AI ને માનવીય સમજણ અને વિવેક શીખવતી ટેકનિક: Reinforcement Learning from Human Feedback (RLHF) ની સંપૂર્ણ સમજ
આધુનિક આર્ટિફિશિયલ ઇન્ટેલિજન્સ મોડલ્સને સુરક્ષિત, મદદરૂપ અને માનવીય પસંદગીઓ મુજબ તૈયાર કરવા માટે RLHF એક અનિવાર્ય પ્રક્રિયા છે.
આજના સમયમાં જ્યારે આપણે ChatGPT અથવા Gemini જેવા આર્ટિફિશિયલ ઇન્ટેલિજન્સ (AI) મોડલ્સ સાથે વાતચીત કરીએ છીએ, ત્યારે આપણને આશ્ચર્ય થાય છે કે આ મશીનો આટલી સચોટ અને માનવીય રીતે કેવી રીતે જવાબ આપી શકે છે. આ સફળતા પાછળ માત્ર ડેટા કે ગણિત નથી, પરંતુ એક વિશિષ્ટ પદ્ધતિ છે જેને 'રિઇન્ફોર્સમેન્ટ લર્નિંગ ફ્રોમ હ્યુમન ફીડબેક' (Reinforcement Learning from Human Feedback - RLHF) કહેવામાં આવે છે. વિકિપીડિયાના અહેવાલ મુજબ, RLHF એ એક એવી ટેકનિક છે જે ઇન્ટેલિજન્ટ એજન્ટને માનવીય પસંદગીઓ સાથે સુસંગત (align) કરવાનું કામ કરે છે. આ પ્રક્રિયામાં એક 'રિવોર્ડ મોડલ' (reward model) તૈયાર કરવામાં આવે છે જે માનવીય પસંદગીઓનું પ્રતિનિધિત્વ કરે છે અને ત્યારબાદ અન્ય મોડલ્સને તાલીમ આપવા માટે તેનો ઉપયોગ થાય છે.
પરંપરાગત રિઇન્ફોર્સમેન્ટ લર્નિંગમાં, AI એજન્ટનું લક્ષ્ય એક એવી 'પોલિસી' (policy) શીખવાનું હોય છે જે તેના વર્તનને માર્ગદર્શન આપે. આ પોલિસીને વારંવાર સુધારવામાં આવે છે જેથી એજન્ટને મળતો 'રિવોર્ડ સિગ્નલ' (reward signal) એટલે કે ઈનામનો સંકેત વધારી શકાય. જોકે, માનવીય પસંદગીઓ એટલી જટિલ હોય છે કે તેને ગણિતના સૂત્રો દ્વારા વ્યાખ્યાયિત કરવી અત્યંત મુશ્કેલ છે. દાખલા તરીકે, કયું લખાણ વધુ 'મદદરૂપ' છે કે કયું લખાણ 'સુરક્ષિત' છે, તે નક્કી કરવા માટે કોઈ ચોક્કસ ગાણિતિક માપદંડ હોતા નથી. આ સમસ્યાના ઉકેલ તરીકે RLHF નો ઉદભવ થયો છે, જે સીધા માનવીય પ્રતિસાદ પરથી રિવોર્ડ મોડલ તૈયાર કરે છે.
- સુપરવાઇઝ્ડ ફાઇન-ટ્યુનિંગ (SFT)માનવીય લેખકો દ્વારા લખાયેલા પ્રશ્નો અને જવાબોના ડેટાસેટ પર મૂળ મોડલને તાલીમ આપીને પાયાની સમજ કેળવવામાં આવે છે.
- રિવોર્ડ મોડલની તાલીમમાણસો AI ના વિવિધ જવાબોને રેન્કિંગ આપે છે, જેના આધારે એક અલગ મોડલ શીખે છે કે કયો જવાબ વધુ સારો ગણાય.
- રિઇન્ફોર્સમેન્ટ લર્નિંગ (PPO)રિવોર્ડ મોડલના સ્કોરનો ઉપયોગ કરીને મૂળ મોડલને સતત સુધારવામાં આવે છે જેથી તે વધુ સારા જવાબો આપી શકે.
| ક્ષેત્ર | ઉપયોગ |
|---|---|
| નેચરલ લેંગ્વેજ પ્રોસેસિંગ | ચેટબોટ્સ અને ટેક્સ્ટ સમરાઇઝેશન |
| કમ્પ્યુટર વિઝન | ટેક્સ્ટ-ટુ-ઈમેજ મોડલ્સ |
| ગેમિંગ અને રોબોટિક્સ | AI બોટ્સનું પ્રદર્શન સુધારવું |
શા માટે RLHF ની જરૂર પડી?
જ્યારે કોઈ કાર્યને સ્પષ્ટ રીતે વ્યાખ્યાયિત કરવું મુશ્કેલ હોય પરંતુ તેનો ન્યાય કરવો સરળ હોય, ત્યારે માનવીય પ્રતિસાદ દ્વારા મોડલને સુધારવું વધુ ઈચ્છનીય બને છે. ઉદાહરણ તરીકે, આપણે એવું AI મોડલ ઈચ્છીએ છીએ જે સુરક્ષિત લખાણ લખે, જે મદદરૂપ હોય અને હાનિકારક ન હોય. હાનિકારક લખાણમાં પક્ષપાત (bias), ઝેરીલી ભાષા (toxicity) અથવા અન્ય નુકસાનકારક સામગ્રીનો સમાવેશ થઈ શકે છે. માણસો માટે હજારોની સંખ્યામાં હાનિકારક અને બિન-હાનિકારક લખાણોના ઉદાહરણો જાતે બનાવવા ખૂબ જ મુશ્કેલ અને સમય માંગી લે તેવું કામ છે. જોકે, માણસો AI દ્વારા જનરેટ થયેલા વિવિધ લખાણોની સરખામણી કરીને તેમાંથી કયું વધુ સારું છે તે ઝડપથી નક્કી કરી શકે છે.
અગાઉના પ્રયાસોમાં રિઇન્ફોર્સમેન્ટ લર્નિંગનો ઉપયોગ કરવામાં આવ્યો હતો, પરંતુ તેમાં ઘણી મુશ્કેલીઓ નડતી હતી. ઘણા મોડલ્સ જટિલ કાર્યોમાં નિષ્ફળ જતા હતા અથવા તો 'નોઈઝી' (noisy) એટલે કે અસંગત ઈનામોને કારણે યોગ્ય રીતે શીખી શકતા નહોતા. RLHF આ સમસ્યાનો ઉકેલ લાવે છે કારણ કે તે માનવીય પસંદગીઓને એક સામાન્ય અલ્ગોરિધમમાં રૂપાંતરિત કરે છે. OpenAI કંપનીએ તેમના એક સંશોધન પત્રમાં ટેક્સ્ટ સમરાઇઝેશન (લખાણનો સારાંશ) માટે આ પદ્ધતિનો ઉપયોગ કર્યો હતો, જે બાદમાં InstructGPT અને ChatGPT માં અત્યંત લોકપ્રિય બની હતી.
RLHF ની કાર્યપદ્ધતિ: ત્રણ મુખ્ય તબક્કાઓ
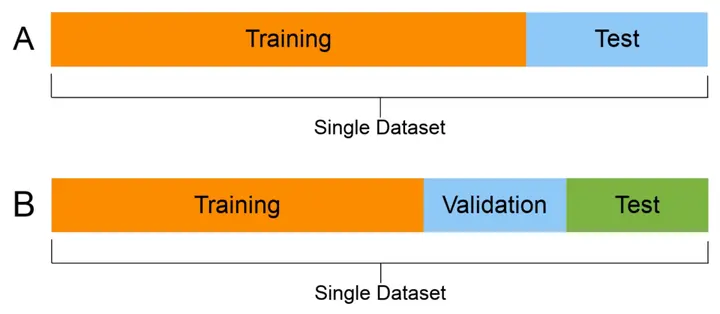
RLHF ની પ્રક્રિયા મુખ્યત્વે ત્રણ તબક્કામાં વહેંચાયેલી છે. પ્રથમ તબક્કામાં, એક પૂર્વ-તાલીમ પામેલા (pre-trained) લેંગ્વેજ મોડલને લેવામાં આવે છે અને તેને 'સુપરવાઇઝ્ડ ફાઇન-ટ્યુનિંગ' (Supervised Fine-Tuning - SFT) દ્વારા તાલીમ આપવામાં આવે છે. આમાં માનવીય લેખકો દ્વારા લખાયેલા પ્રશ્નો અને જવાબોના નાના ડેટાસેટનો ઉપયોગ થાય છે. આનાથી મોડલને ભાષાની પાયાની સમજ અને જવાબ આપવાની રીતભાત સમજાય છે. આ તબક્કો મોડલને એક પાયો પૂરો પાડે છે જેના પર આગળની તાલીમ શક્ય બને છે.
- સુપરવાઇઝ્ડ ફાઇન-ટ્યુનિંગપૂર્વ-તાલીમ પામેલા મોડલને માનવીય લેખકો દ્વારા તૈયાર કરેલા પ્રશ્નો અને જવાબોના ડેટાસેટ પર તાલીમ આપવામાં આવે છે.
- રિવોર્ડ મોડલની રચનામાણસો દ્વારા આપવામાં આવેલા રેન્કિંગ ડેટાનો ઉપયોગ કરીને એક મોડલ તૈયાર કરવામાં આવે છે જે જવાબોને સ્કોર આપે છે.
- રિઇન્ફોર્સમેન્ટ લર્નિંગPPO અલ્ગોરિધમનો ઉપયોગ કરીને રિવોર્ડ મોડલના સ્કોરના આધારે મુખ્ય મોડલની પોલિસીમાં સતત સુધારો કરવામાં આવે છે.
બીજો તબક્કો સૌથી મહત્વનો છે, જેમાં 'રિવોર્ડ મોડલ' (Reward Model) તૈયાર કરવામાં આવે છે. આ મોડલ એક એવું કાર્ય કરે છે જે ઇનપુટ તરીકે ટેક્સ્ટ લે છે અને આઉટપુટ તરીકે એક નંબર (સ્કોર) આપે છે. આ સ્કોર દર્શાવે છે કે તે લખાણ માણસોને કેટલું પસંદ આવશે. આ મોડલને તાલીમ આપવા માટે, માણસોને AI દ્વારા જનરેટ થયેલા બે કે તેથી વધુ જવાબો બતાવવામાં આવે છે અને તેમને તે જવાબોને રેન્કિંગ (ranking) આપવા માટે કહેવામાં આવે છે. આ રેન્કિંગ ડેટાનો ઉપયોગ કરીને રિવોર્ડ મોડલને એ રીતે તાલીમ આપવામાં આવે છે કે તે માણસોની પસંદગીની આગાહી કરી શકે.
ત્રીજા તબક્કામાં, રિઇન્ફોર્સમેન્ટ લર્નિંગનો ઉપયોગ કરીને મૂળ મોડલની પોલિસીને સુધારવામાં આવે છે. આ માટે 'પ્રોક્સિમલ પોલિસી ઓપ્ટિમાઈઝેશન' (Proximal Policy Optimization - PPO) નામના અલ્ગોરિધમનો ઉપયોગ થાય છે. આ પ્રક્રિયામાં, મોડલ કોઈ પ્રશ્નનો જવાબ આપે છે, રિવોર્ડ મોડલ તે જવાબને સ્કોર આપે છે, અને તે સ્કોરના આધારે મોડલ પોતાના વર્તનમાં સુધારો કરે છે. આ એક સતત ચાલતી પ્રક્રિયા છે જેનાથી AI મોડલ ધીમે ધીમે વધુ સચોટ અને માનવીય પસંદગીઓ મુજબનું બનતું જાય છે.
રિવોર્ડ મોડલ અને ગાણિતિક ચોકસાઈ
રિવોર્ડ મોડલને તાલીમ આપવા માટે ઘણીવાર 'એલો રેટિંગ સિસ્ટમ' (Elo rating system) નો ઉપયોગ થાય છે. આ એ જ અલ્ગોરિધમ છે જેનો ઉપયોગ ચેસના ખેલાડીઓની કુશળતા માપવા માટે થાય છે. જ્યારે માણસો બે જવાબોની સરખામણી કરે છે, ત્યારે તે ડેટા રિવોર્ડ મોડલને શીખવે છે કે કયા પ્રકારના શબ્દો કે વાક્યરચના વધુ સ્કોર મેળવશે. વિકિપીડિયાના સ્ત્રોત મુજબ, રિવોર્ડ મોડલને તાલીમ આપવા માટે તેના અંતિમ લેયરને બદલીને એક 'રિગ્રેશન હેડ' (regression head) મૂકવામાં આવે છે, જે વર્ગીકરણને બદલે સીધો સ્કોર આઉટપુટ આપે છે.
આ તાલીમ દરમિયાન 'ક્રોસ-એન્ટ્રોપી લોસ ફંક્શન' (cross-entropy loss function) નો ઉપયોગ કરવામાં આવે છે. આ ગાણિતિક સૂત્ર એ સુનિશ્ચિત કરે છે કે મોડલ માણસો દ્વારા પસંદ કરાયેલા જવાબને ઊંચો સ્કોર આપે અને નકારાયેલા જવાબને નીચો સ્કોર આપે. સંશોધનો દર્શાવે છે કે ડેટાની માત્રા વધારવા કરતા રિવોર્ડ મોડલનું કદ વધારવું ઘણીવાર વધુ અસરકારક સાબિત થાય છે. જોકે, પક્ષપાત ટાળવા માટે ડેટામાં વિવિધતા હોવી અત્યંત જરૂરી છે, કારણ કે જો તાલીમ આપનાર માણસોનો સમૂહ મર્યાદિત હોય, તો મોડલમાં પણ તેમના પક્ષપાતો આવી શકે છે.
KL રેગ્યુલરાઈઝેશન: મોડલને ભટકી જતું અટકાવવું
RLHF ની પ્રક્રિયામાં એક મોટો ભય એ રહેલો છે કે મોડલ રિવોર્ડ મોડલને 'છેતરવાનું' શીખી જાય. એટલે કે, મોડલ એવા જવાબો આપવાનું શરૂ કરે જે રિવોર્ડ મોડલ મુજબ ઊંચો સ્કોર મેળવે પણ વાસ્તવમાં માણસો માટે અર્થહીન કે અયોગ્ય હોય. આને રોકવા માટે 'KL રેગ્યુલરાઈઝેશન' (KL regularization) નો ઉપયોગ કરવામાં આવે છે. આ પદ્ધતિ સુનિશ્ચિત કરે છે કે નવું તાલીમ પામેલું મોડલ તેના મૂળ (unaligned) મોડલથી બહુ દૂર ન નીકળી જાય. આનાથી તાલીમ પ્રક્રિયા સ્થિર બને છે અને ઓવરફિટિંગ (overfitting) એટલે કે ડેટાને ગોખી નાખવાની સમસ્યા ઘટે છે.
નેચર સામયિક અને અન્ય સંશોધનો મુજબ, KL રેગ્યુલરાઈઝેશન સાથે તાલીમ પામેલા મોડલ્સ દ્વારા જનરેટ થયેલી ઈમેજ કે ટેક્સ્ટની ગુણવત્તા તેના વગરના મોડલ્સ કરતા ઘણી વધારે હોય છે. આ ટેકનિક મોડલને તેની મૂળભૂત ભાષાકીય સમજ જાળવી રાખવામાં મદદ કરે છે જ્યારે તે નવી માનવીય પસંદગીઓ શીખી રહ્યું હોય છે. આ સંતુલન જ AI ને ખરેખર ઉપયોગી બનાવે છે.
વિવિધ ક્ષેત્રોમાં RLHF નો પ્રભાવ
RLHF નો ઉપયોગ માત્ર ટેક્સ્ટ મોડલ્સ પૂરતો મર્યાદિત નથી. નેચરલ લેંગ્વેજ પ્રોસેસિંગ (NLP) માં ChatGPT, DeepMind નું Sparrow, Google નું Gemini અને Anthropic નું Claude આ ટેકનિકના શ્રેષ્ઠ ઉદાહરણો છે. આ મોડલ્સ RLHF ને કારણે જ અયોગ્ય પ્રશ્નોના જવાબ આપવાનો ઇનકાર કરી શકે છે અને વધુ પ્રસ્તુત જવાબો આપી શકે છે. કમ્પ્યુટર વિઝન (Computer Vision) ક્ષેત્રમાં, ટેક્સ્ટ-ટુ-ઈમેજ મોડલ્સને વધુ સચોટ ચિત્રો બનાવવા માટે પણ આ ટેકનિકનો ઉપયોગ થાય છે.
વીડિયો ગેમ્સ અને રોબોટિક્સમાં પણ RLHF એ ક્રાંતિ લાવી છે. OpenAI અને DeepMind એ Atari ગેમ્સ રમતા બોટ્સને તાલીમ આપવા માટે આ પદ્ધતિનો ઉપયોગ કર્યો હતો. પરંપરાગત રીતે, ગેમ બોટ્સને સ્કોરના આધારે તાલીમ આપવામાં આવતી હતી. પરંતુ RLHF માં, માણસોને ગેમ રમતા બોટની બે ક્લિપ્સ બતાવવામાં આવે છે અને તેમાંથી કઈ વધુ સારી લાગે છે તે પૂછવામાં આવે છે. આશ્ચર્યજનક રીતે, આ પદ્ધતિથી તાલીમ પામેલા બોટ્સ ઘણીવાર માણસો કરતા પણ વધુ સારું પ્રદર્શન કરે છે, ભલે તેમની પાસે ગેમના સ્કોરની કોઈ સીધી માહિતી ન હોય.
| ક્ષેત્ર | મુખ્ય ઉપયોગ | ઉદાહરણ મોડલ/એપ્લિકેશન |
|---|---|---|
| નેચરલ લેંગ્વેજ પ્રોસેસિંગ | સુરક્ષિત અને મદદરૂપ સંવાદ | ChatGPT, Gemini, Claude |
| કમ્પ્યુટર વિઝન | ઉચ્ચ ગુણવત્તાવાળી ઈમેજ જનરેશન | Text-to-Image Models |
| રોબોટિક્સ અને ગેમ્સ | માનવીય કૌશલ્ય મુજબનું પ્રદર્શન | Atari Game Bots |
| ટેક્સ્ટ સમરાઇઝેશન | ચોકસાઈપૂર્વક સારાંશ લેખન | InstructGPT |
પડકારો અને ભવિષ્યની દિશા
RLHF અત્યંત અસરકારક હોવા છતાં તે સંપૂર્ણ નથી. સૌથી મોટો પડકાર ઉચ્ચ ગુણવત્તાવાળા માનવીય પ્રતિસાદનો છે. માણસો પાસેથી ડેટા એકત્રિત કરવો એ ખર્ચાળ અને સમય માંગી લે તેવી પ્રક્રિયા છે. વળી, જો ડેટા એકત્રિત કરનાર માણસોના સમૂહમાં વિવિધતા ન હોય, તો મોડલ પક્ષપાતી બની શકે છે. RLHF માં 'નોન-માર્કોવિયન' (non-Markovian) પ્રકૃતિ હોય છે, જેનો અર્થ છે કે શ્રેષ્ઠ નિર્ણય લેવા માટે મોડલે ભૂતકાળના પગલાં અને નિર્ણયોને યાદ રાખવા પડે છે, જે ગાણિતિક રીતે જટિલ છે.
ભારત જેવા વિવિધતા ધરાવતા દેશ માટે RLHF નું મહત્વ ઘણું વધારે છે. જો આપણે ગુજરાતી જેવી પ્રાદેશિક ભાષાઓમાં AI ને વધુ સચોટ બનાવવું હોય, તો સ્થાનિક લોકોના પ્રતિસાદ દ્વારા મોડલને તાલીમ આપવી અનિવાર્ય છે. ભવિષ્યમાં, 'ઓનલાઇન ડેટા કલેક્શન' મોડલ્સ વધુ લોકપ્રિય બનશે જ્યાં AI સીધું પર્યાવરણ સાથે વાતચીત કરીને તરત જ પોતાની પોલિસી અપડેટ કરશે. RLHF એ માત્ર એક ટેકનિક નથી, પરંતુ મશીન અને માનવ સંવેદનાઓ વચ્ચેનો એક મજબૂત સેતુ છે જે AI ને વધુ સુરક્ષિત અને વિશ્વાસપાત્ર બનાવે છે.


