ડિફ્યુઝન મોડેલ આર્કિટેક્ચર: થર્મોડાયનેમિક્સથી AI ચિત્ર સર્જન સુધીની ગાણિતિક સફર
આર્ટિફિશિયલ ઇન્ટેલિજન્સમાં અદ્ભુત ચિત્રો અને વિડીયો રચતા ડિફ્યુઝન મોડેલ્સ પાછળનું ભૌતિકવિજ્ઞાન, તેનું ન્યુરલ આર્કિટેક્ચર અને ગાણિતિક કામગીરીની વિગતવાર માહિતી.
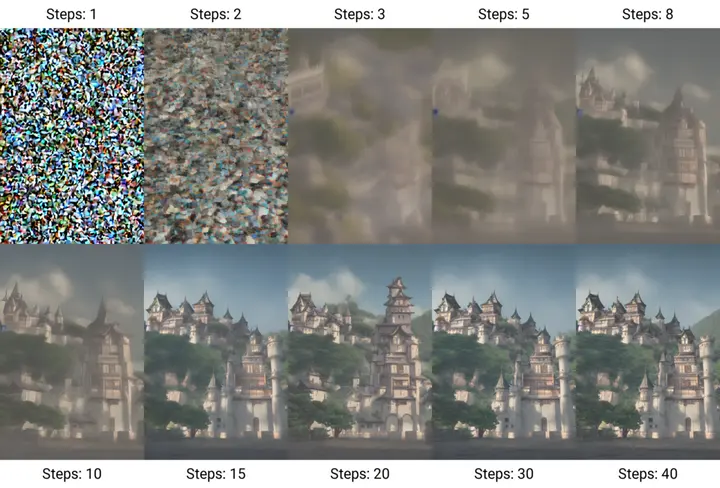
આજના આર્ટિફિશિયલ ઇન્ટેલિજન્સ (AI) ના યુગમાં Stable Diffusion, DALL-E અને Midjourney જેવા મોડેલ્સ માત્ર એક નાના ટેક્સ્ટ પ્રોમ્પ્ટ પરથી અત્યંત દર્શનીય અને વાસ્તવિક ચિત્રો બનાવી આપે છે. આ ચમત્કાર જેવા લાગતા સર્જન પાછળ જે ટેકનોલોજી કામ કરી રહી છે તેને 'ડિફ્યુઝન મોડેલ્સ' (Diffusion Models) અથવા 'સ્કોર-બેઝ્ડ જનરેટિવ મોડેલ્સ' (Score-based generative models) કહેવામાં આવે છે. આ મોડેલ્સ જનરેટિવ AI ના ક્ષેત્રમાં એક ક્રાંતિકારી પરિવર્તન લાવ્યા છે. પરંતુ આ મોડેલ્સ મૂળભૂત રીતે કેવી રીતે કામ કરે છે, તેમનું ગાણિતિક માળખું શું છે અને અસ્તવ્યસ્ત ડિજિટલ કચરામાંથી સુંદર ચિત્ર કેવી રીતે ઉત્પન્ન થાય છે તે સમજવું અત્યંત રસપ્રદ છે.
ગાણિતિક દ્રષ્ટિએ ડિફ્યુઝન મોડેલ એ 'લેટન્ટ વેરીએબલ મોડેલ્સ' (latent variable generative models) નો એક પ્રકાર છે. આ મોડેલના બે મુખ્ય ભાગો છે: પહેલો 'ફોરવર્ડ ડિફ્યુઝન પ્રોસેસ' (Forward Diffusion Process) અને બીજો 'રિવર્સ સેમ્પલિંગ પ્રોસેસ' (Reverse Sampling Process). મોડેલનો મુખ્ય હેતુ આપેલી માહિતી અથવા ચિત્રોના ડેટાસેટની પેટર્ન શીખીને તે જ પ્રકારનો નવો ડેટા તૈયાર કરવાનો છે. તે ડેટાને એક એવી પ્રક્રિયા તરીકે જુએ છે જ્યાં દરેક ડેટા પોઇન્ટ સંભાવનાના વિશાળ અવકાશમાં એક અનિયમિત ચાલ (random walk with drift) ચાલે છે.
- ૧. ડેટાસેટની પસંદગીમૂળ ચિત્રોના ડેટાસેટમાંથી સેમ્પલ લઈને તેની ગાણિતિક સંભાવના પેટર્ન શીખવામાં આવે છે.
- ૨. ફોરવર્ડ ડિફ્યુઝન પ્રોસેસમૂળ ચિત્રમાં ક્રમશઃ ગોશિયન નોઇઝ ઉમેરીને તેને સંપૂર્ણ અસ્તવ્યસ્ત નોઇઝમાં ફેરવવામાં આવે છે.
- ૩. ન્યુરલ નેટવર્ક ટ્રેનિંગબેકબોન નેટવર્ક (જેવા કે U-Net કે Transformer) દ્વારા દરેક તબક્કે ઉમેરાયેલા નોઇઝનો અંદાજ લગાવવામાં આવે છે.
- ૪. રિવર્સ સેમ્પલિંગ પ્રોસેસશુદ્ધ રેન્ડમ નોઇઝથી શરૂઆત કરીને, નેટવર્ક તેને ક્રમશઃ ડેનોઇઝ કરીને આકર્ષક ચિત્રનું સર્જન કરે છે.
- ૧. ફોરવર્ડ ડિફ્યુઝન (Forward Diffusion)મૂળ ચિત્ર (x₀) માં તબક્કાવાર ગોશિયન નોઇઝ ઉમેરવામાં આવે છે, જેથી તે સંપૂર્ણ અસ્તવ્યસ્ત નોઇઝ (x_T) બની જાય છે.
- ૨. નોઇઝનું અનુમાન (Noise Prediction)ન્યુરલ નેટવર્ક (U-Net અથવા Transformer) કોઈપણ તબક્કે ઉમેરાયેલા નોઇઝનું ચોક્કસ ગણિતથી અનુમાન લગાવતા શીખે છે.
- ૩. રિવર્સ ડેનોઇઝિંગ (Reverse Denoising)સંપૂર્ણ રેન્ડમ નોઇઝથી શરૂઆત કરીને, મોડેલ ક્રમશઃ નોઇઝ બાદ કરીને સ્વચ્છ ચિત્ર તરફ પાછું ફરે છે.
- ૪. આઉટપુટ જનરેશન (Final Image Generation)ટેક્સ્ટ પ્રોમ્પ્ટ કે ગાઇડન્સના આધારે મોડેલ સંપૂર્ણપણે નવું અને સ્પષ્ટ ચિત્ર તૈયાર કરે છે.
ડિફ્યુઝન મોડેલનો વૈજ્ઞાનિક પાયો ભૌતિકવિજ્ઞાનની એક શાખા 'અસંતુલિત ઉષ્માગતિશાસ્ત્ર' (Non-equilibrium Thermodynamics) માં રહેલો છે. સૌપ્રથમ ૨૦૧૫ માં સંશોધકોએ ભૌતિકશાસ્ત્રના ડિફ્યુઝન (પ્રસરણ) ના નિયમોનો ઉપયોગ કરીને અત્યંત જટિલ સંભાવના વિતરણ (probability distribution) માંથી ડેટા જનરેટ કરવાની આ પદ્ધતિ પ્રસ્તાવિત કરી હતી. કુદરતી ચિત્રોના સમૂહને વિચારવામાં આવે તો, દરેક ચિત્ર ચિત્રોની કાલ્પનિક જગ્યામાં એક બિંદુ સમાન છે. જ્યારે ચિત્રમાં વારંવાર નોઇઝ (અસ્પષ્ટ કચરો) ઉમેરવામાં આવે છે, ત્યારે તે 'ગોશિયન ડિસ્ટ્રિબ્યુશન' (Gaussian distribution) માં ફેરવાઈ જાય છે. આ પ્રક્રિયાને ઉલટાવીને સંપૂર્ણ અસ્તવ્યસ્ત નોઇઝમાંથી મૂળ ડેટા મેળવી શકાય છે.
આ પ્રક્રિયાને ભૌતિકશાસ્ત્રના 'મેક્સવેલ-બોલ્ટઝમેન વિતરણ' (Maxwell-Boltzmann distribution) સાથે સરખાવી શકાય છે, જ્યાં પોટેન્શિયલ વેલ V(x) = ૧/૨ ||x||² માં કણોની ગતિવિધિ થાય છે. જો સિસ્ટમમાં માત્ર ગ્રેડિયન્ટ ડિસેન્ટ (ચોક્કસ તરફનો ઝુકાવ) હોય તો બધા કણો કેન્દ્રમાં એકઠા થઈને નષ્ટ થઈ જાય. આથી, સંતુલન જાળવવા માટે તેમાં રેન્ડમનેસ (યાદચ્છિકતા) ઉમેરવી જરૂરી બને છે. ૨૦૨૦ ના સંશોધન પત્રમાં 'ડેનોઇઝિંગ ડિફ્યુઝન પ્રોબાબિલિસ્ટિક મોડેલ' (DDPM) રજૂ કરવામાં આવ્યું, જેણે વેરિએશનલ ઇન્ફરન્સ (variational inference) નો ઉપયોગ કરીને આ તકનીકને અદ્ભુત રીતે સુધારી.
| પદ્ધતિ / મોડેલ | ગણિત અને માળખું | મુખ્ય ફાયદા | ઉપયોગ ક્ષેત્ર |
|---|---|---|---|
| DDPM (૨૦૨૦) | માર્કોવ ચેઇન અને વેરિએશનલ ઇન્ફરન્સ | સ્થિર તાલીમ અને ઉચ્ચ ગુણવત્તા | ઇમેજ જનરેશન, સુપર-રિઝોલ્યુશન |
| Latent Diffusion (LDM) | કોમ્પ્રેસ્ડ લેટન્ટ સ્પેસ ડિફ્યુઝન | ઓછો કોમ્પ્યુટેશનલ ખર્ચ અને ઝડપ | Stable Diffusion, DALL-E |
| Score-based SDEs | સતત સમયના કન્ટિન્યુઅસ SDE/ODE | ચોક્કસ સેમ્પલિંગ અને સૈદ્ધાંતિક મજબૂતી | સતત ડેટા મોડેલિંગ |
| Rectified Flow | સ્ટ્રેટ-લાઇન ટ્રેજેક્ટોરી ફ્લો | ઓછા સ્ટેપ્સમાં અતિઝડપી સેમ્પલિંગ | ઝડપી AI ઇમેજ અને વિડીયો સર્જન |
ગણિતની ભાષામાં, ફોરવર્ડ ડિફ્યુઝન પ્રક્રિયા એક 'માર્કોવ ચેઇન' (Markov Chain) ને અનુસરે છે. મૂળ ચિત્ર x₀ થી શરૂ કરીને, T જેટલા સમયગાળાના તબક્કાઓમાં થોડો થોડો ગોશિયન નોઇઝ ઉમેરવામાં આવે છે. આ માટે અમુક નિશ્ચિત સતતાંકો β₁, ..., β_T નક્કી કરવામાં આવે છે, જે ૦ અને ૧ ની વચ્ચે હોય છે. દરેક તબક્કે નવા ડેટા પોઇન્ટ x_t ની ગણતરી માટે x_{t-૧} માં નોઇઝ ઉમેરાય છે. સુખદ વાત એ છે કે, દરેક તબક્કામાંથી પસાર થયા વિના, માત્ર એક ગાણિતિક સૂત્ર દ્વારા x₀ માંથી સીધા જ કોઈપણ તબક્કા x_t નો નોઇઝ ઉમેરેલો ફોટો ગણી શકાય છે. જેમ જેમ તબક્કો t અનંત તરફ જાય છે, તેમ મૂળ ચિત્ર સંપૂર્ણપણે નાશ પામીને શુદ્ધ ગોશિયન નોઇઝ N(૦, I) બની જાય છે.
ડીફ્યુઝન મોડેલની ખરી જાદુઈ તાકાત તેના 'રિવર્સ સેમ્પલિંગ પ્રોસેસ' માં છે. કારણ કે ફોરવર્ડ પ્રોસેસમાં ઉમેરાયેલું નોઇઝ આપણને ખબર હોય છે, પરંતુ તેને સીધું ઉલટાવવું (intractable) અશક્ય હોય છે. આથી, એક આર્ટિફિશિયલ ન્યુરલ નેટવર્કને તાલીમ આપવામાં આવે છે જે આ રિવર્સ પ્રક્રિયાનું ગાણિતિક અંદાજન લગાવે છે. આ ન્યુરલ નેટવર્કને મોડેલનું 'બેકબોન' (Backbone) કહેવામાં આવે છે. સામાન્ય રીતે આ બેકબોન તરીકે 'યુ-નેટ' (U-Net) અથવા 'ટ્રાન્સફોર્મર' (Transformer) આર્કિટેક્ચરનો ઉપયોગ થાય છે. તાલીમ દરમિયાન, નેટવર્ક x_t અને સમય t જાણીને તેમાં ઉમેરાયેલા નોઇઝ z_θ નો ચોક્કસ અંદાજ લગાવે છે.
કમ્યુટેશનલ ખર્ચ ઘટાડવા માટે, સંશોધકોએ 'લેટન્ટ ડિફ્યુઝન મોડેલ્સ' (Latent Diffusion Models - LDM) વિકસાવ્યા. વાસ્તવિક પિક્સેલ સ્પેસમાં ડિફ્યુઝન ચલાવવું ખૂબ ભારે પડે છે, તેથી પહેલા ઓટોએન્કોડર દ્વારા ચિત્રને નાના ગાણિતિક પરિમાણ વાળા 'લેટન્ટ સ્પેસ' (Latent Space) માં સંકુચિત કરવામાં આવે છે. ત્યારબાદ તમામ ડિફ્યુઝન અને ડેનોઇઝિંગ પ્રોસેસ આ લેટન્ટ સ્પેસમાં જ થાય છે. Stable Diffusion આ જ સિદ્ધાંત પર કાર્ય કરે છે. વપરાશકર્તા દ્વારા આપવામાં આવેલા ટેક્સ્ટ પ્રોમ્પ્ટને ચિત્રમાં બદલવા માટે ક્રોસ-એટેન્શન મોડ્યુલ્સ (cross-attention modules) અને ટેક્સ્ટ-એન્કોડર્સનો ઉપયોગ કરવામાં આવે છે.
જનરેટ કરેલા ચિત્ર પર વપરાશકર્તાનું નિયંત્રણ વધારવા માટે 'ક્લાસિફાયર-ફ્રી ગાઇડન્સ' (Classifier-free guidance - CFG) નો ઉપયોગ કરવામાં આવે છે. CFG તકનીકમાં મોડેલને એકસાથે શરતી (Conditional, એટલે કે ટેક્સ્ટ સાથે) અને બિન-શરતી (Unconditional, ટેક્સ્ટ વગર) બંને રીતે તાલીમ આપવામાં આવે છે. સેમ્પલિંગ વખતે, ગાઇડન્સ સ્કેલ 'w' વડે આ બંનેના તફાવતને ગુણવામાં આવે છે. આનાથી ચિત્રની વિવિધતા અને ટેક્સ્ટ પ્રોમ્પ્ટ પ્રત્યેની ચોકસાઈ વચ્ચે સંતુલન જાળવી શકાય છે.
૨૦૨૦ માં સંગ (Song) અને તેમના સાથીદારોએ ડિફ્યુઝન મોડેલ્સને 'કન્ટિન્યુઅસ-ટાઇમ સ્ટોકેસ્ટિક ડિફરન્શિયલ ઇક્વેશન્સ' (Stochastic Differential Equations - SDEs) ના સાર્વત્રિક માળખામાં રજૂ કર્યા. આ ગણતરીથી ડિફ્યુઝન પ્રક્રિયાને અનંત નાના સમયગાળામાં વિભાજિત કરી શકાય છે. આ અભિગમમાંથી 'પ્રોબાબિલિટી ફ્લો ODE' ની સંતતિ થઈ, જેનાથી ડેટાની ઝડપી સેમ્પલિંગ અને સચોટ ગણતરી શક્ય બની. તાજેતરના વર્ષોમાં 'ફ્લો મેચિંગ' (Flow Matching) અને 'રેક્ટિફાઇડ ફ્લો' (Rectified Flow) જેવી તકનીકો આવી છે, જે નોઇઝ અને ડેટા વચ્ચેના માર્ગોને સીધા (straight trajectories) બનાવે છે, જેથી મોડેલ માત્ર થોડા જ સ્ટેપ્સમાં ચિત્ર બનાવી શકે છે.
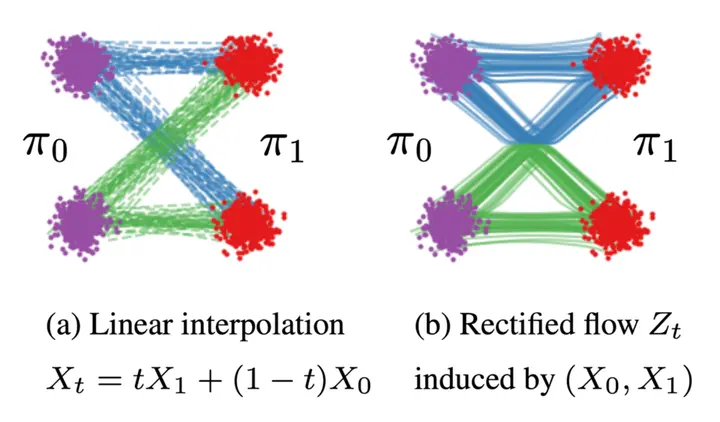
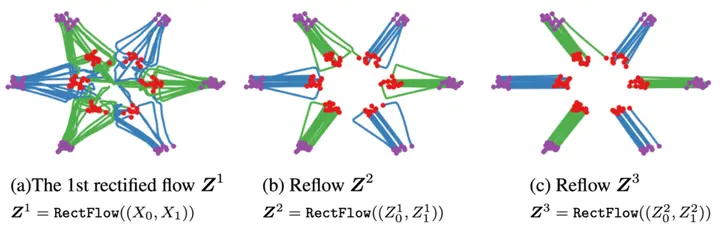
૨૦૨૪ સુધીમાં, ડિફ્યુઝન મોડેલ્સ માત્ર ચિત્ર સર્જન પૂરતા મર્યાદિત નથી રહ્યા. કમ્પ્યુટર વિઝનમાં ચિત્રમાંથી નોઇઝ દૂર કરવો (image denoising), ઇનપેઇન્ટિંગ (inpainting), સુપર-રિઝોલ્યુશન અને હાઇ-ક્વોલિટી વિડીયો જનરેશન માટે તેનો વ્યાપક ઉપયોગ થઈ રહ્યો છે. આ ઉપરાંત, નેચરલ લેંગ્વેજ પ્રોસેસિંગમાં ટેક્સ્ટ સમરાઇઝેશન, ઓડિયો-સાઉન્ડ જનરેશન અને રિઇનફોર્સમેન્ટ લર્નિંગમાં પણ ડિફ્યુઝન આર્કિટેક્ચર મહત્વની ભૂમિકા ભજવી રહ્યું છે.
ભારત જેવા દેશ માટે, જ્યાં AI ટેકનોલોજીનો ઉપયોગ શિક્ષણ, કૃષિ, અને ડિઝાઇનિંગ ક્ષેત્રે ઝડપથી વધી રહ્યો છે, ત્યાં ડિફ્યુઝન મોડેલ્સની ગાણિતિક અને આર્કિટેક્ચરલ સમજ અત્યંત મહત્વપૂર્ણ છે. જોકે, આ મોડેલ્સને તાલીમ આપવા માટે વિશાળ કમ્પ્યુટિંગ પાવર (GPUs) ની જરૂર પડે છે. ભવિષ્યમાં વધુ કાર્યક્ષમ, ઓછા સ્ટેપ્સમાં કામ કરતા અને ઓછા કમ્પ્યુટેશનલ ખર્ચવાળા રેક્ટિફાઇડ ડિફ્યુઝન મોડેલ્સ AI ક્રાંતિને વધુ લોકભોગ્ય બનાવશે.


