डिफ्यूजन मॉडल आर्किटेक्चर: थर्मोडायनामिक्स से AI चित्र सृजन तक की गणितीय यात्रा
आर्टिफिशियल इंटेलिजेंस में अद्भुत चित्र और वीडियो रचने वाले डिफ्यूजन मॉडल्स के पीछे का भौतिकी, उसका न्यूरल आर्किटेक्चर और गणितीय कार्यप्रणाली की विस्तृत जानकारी।
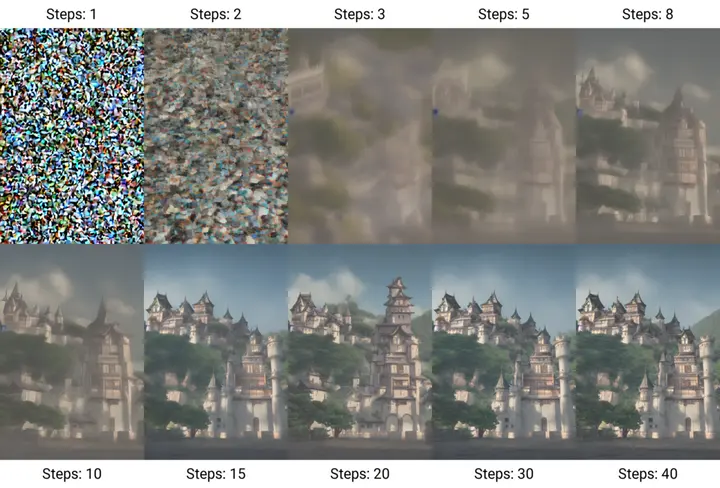
आज के आर्टिफिशियल इंटेलिजेंस (AI) के युग में Stable Diffusion, DALL-E और Midjourney जैसे मॉडल्स मात्र एक छोटे टेक्स्ट प्रॉम्प्ट से अत्यंत दर्शनीय और वास्तविक चित्र बना देते हैं। इस चमत्कार जैसे लगने वाले सृजन के पीछे जो तकनीक काम कर रही है उसे 'डिफ्यूजन मॉडल्स' (Diffusion Models) या 'स्कोर-बेस्ड जेनेरेटिव मॉडल्स' (Score-based generative models) कहा जाता है। ये मॉडल्स जेनेरेटिव AI के क्षेत्र में एक क्रांतिकारी परिवर्तन लाए हैं। परंतु ये मॉडल्स मूल रूप से कैसे काम करते हैं, उनका गणितीय ढांचा क्या है और अस्त-व्यस्त डिजिटल कचरे से सुंदर चित्र कैसे उत्पन्न होता है यह समझना अत्यंत दिलचस्प है।
गणितीय दृष्टि से डिफ्यूजन मॉडल एक 'लेटेंट वेरिएबल मॉडल्स' (latent variable generative models) का एक प्रकार है। इस मॉडल के दो मुख्य भाग हैं: पहला 'फॉरवर्ड डिफ्यूजन प्रोसेस' (Forward Diffusion Process) और दूसरा 'रिवर्स सैंपलिंग प्रोसेस' (Reverse Sampling Process). मॉडल का मुख्य उद्देश्य दी गई जानकारी या चित्रों के डेटासेट की पैटर्न सीखकर उसी प्रकार का नया डेटा तैयार करना है। यह डेटा को एक ऐसी प्रक्रिया के रूप में देखता है जहां प्रत्येक डेटा पॉइंट संभावना के विशाल अवकाश में एक अनियमित चाल (random walk with drift) चलता है।
- 1. डेटासेट का चयनमूल चित्रों के डेटासेट से सैंपल लेकर उसकी गणितीय संभावना पैटर्न सीखी जाती है।
- 2. फॉरवर्ड डिफ्यूजन प्रोसेसमूल चित्र में क्रमशः गोशियन नॉइज़ जोड़कर उसे पूरी तरह अस्त-व्यस्त नॉइज़ में बदला जाता है।
- 3. न्यूरल नेटवर्क ट्रेनिंगबैकबोन नेटवर्क (जैसे कि U-Net या Transformer) द्वारा प्रत्येक चरण पर जोड़े गए नॉइज़ का अंदाज़ लगाया जाता है।
- 4. रिवर्स सैंपलिंग प्रोसेसशुद्ध रैंडम नॉइज़ से शुरुआत करके, नेटवर्क इसे क्रमशः डैनोइज करके आकर्षक चित्र का सृजन करता है।
- 1. फॉरवर्ड डिफ्यूजन (Forward Diffusion)मूल चित्र (x₀) में चरणबद्ध गोशियन नॉइज़ जोड़ा जाता है, जिससे वह पूरी तरह अस्त-व्यस्त नॉइज़ (x_T) बन जाता है।
- 2. नॉइज़ का अनुमान (Noise Prediction)न्यूरल नेटवर्क (U-Net या Transformer) किसी भी चरण पर जोड़े गए नॉइज़ का सटीक गणित से अनुमान लगाना सीखता है।
- 3. रिवर्स डैनोइजिंग (Reverse Denoising)पूर्ण रैंडम नॉइज़ से शुरुआत करके, मॉडल क्रमशः नॉइज़ घटाकर स्वच्छ चित्र की ओर वापस लौटता है।
- 4. आउटपुट जनरेशन (Final Image Generation)टेक्स्ट प्रॉम्प्ट या गाइडेंस के आधार पर मॉडल पूरी तरह नया और स्पष्ट चित्र तैयार करता है।
डिफ्यूजन मॉडल का वैज्ञानिक आधार भौतिकी की एक शाखा 'असंतुलित ऊष्मागतिकी' (Non-equilibrium Thermodynamics) में निहित है। सर्वप्रथम 2015 में शोधकर्ताओं ने भौतिकशास्त्र के डिफ्यूजन (प्रसार) के नियमों का उपयोग करके अत्यंत जटिल संभावना वितरण (probability distribution) में से डेटा जनरेट करने की इस पद्धति को प्रस्तावित किया था। प्राकृतिक चित्रों के समूह को सोचा जाए तो, प्रत्येक चित्र चित्रों की काल्पनिक जगह में एक बिंदु समान है। जब चित्र में बार-बार नॉइज़ (अस्पष्ट कचरा) जोड़ा जाता है, तब वह 'गोशियन डिस्ट्रीब्यूशन' (Gaussian distribution) में बदल जाता है। इस प्रक्रिया को उलटकर पूरी तरह अस्त-व्यस्त नॉइज़ से मूल डेटा प्राप्त किया जा सकता है।
इस प्रक्रिया को भौतिकी के 'मैक्सवेल-बोल्ट्जमैन वितरण' (Maxwell-Boltzmann distribution) के साथ तुलना की जा सकती है, जहां पोटेंशियल वेल V(x) = 1/2 ||x||² में कणों की गतिविधियां होती हैं। यदि सिस्टम में केवल ग्रेडिएंट डिसेंट (निश्चित की ओर का झुकाव) हो तो सभी कण केंद्र में एकत्र होकर नष्ट हो जाते हैं। अतः, संतुलन बनाए रखने के लिए इसमें रैंडमनेस (यादच्छिकता) जोड़ना आवश्यक हो जाता है। 2020 के शोध पत्र में 'डैनोइजिंग डिफ्यूजन प्रोबेबिलिस्टिक मॉडल' (DDPM) प्रस्तुत किया गया, जिसने वैरीएशनल इन्फेरेंस (variational inference) का उपयोग करके इस तकनीक को अद्भुत रूप से सुधारा।
| पद्धति / मॉडल | गणित और ढांचा | मुख्य फायदे | उपयोग क्षेत्र |
|---|---|---|---|
| DDPM (2020) | मार्कोव चेन और वैरीएशनल इन्फेरेंस | स्थिर तालीम और उच्च गुणवत्ता | इमेज जनरेशन, सुपर-रिजॉल्यूशन |
| Latent Diffusion (LDM) | कंप्रेस्ड लेटेंट स्पेस डिफ्यूजन | कम कंप्यूटेशनल खर्च और गति | Stable Diffusion, DALL-E |
| Score-based SDEs | सतत समय के कंटीन्यूअस SDE/ODE | सटीक सैंपलिंग और सैद्धांतिक मजबूती | सतत डेटा मॉडलिंग |
| Rectified Flow | स्ट्रेट-लाइन ट्रेजेक्टोरी फ्लो | कम स्टेप्स में अति तीव्र सैंपलिंग | त्वरित AI इमेज और वीडियो सृजन |
गणित की भाषा में, फॉरवर्ड डिफ्यूजन प्रक्रिया एक 'मार्कोव चेन' (Markov Chain) का अनुसरण करती है। मूल चित्र x₀ से शुरू करते हुए, T जितने समयाकाल के चरणों में थोड़ा-थोड़ा गोशियन नॉइज़ जोड़ा जाता है। इसके लिए कुछ निश्चित सतांक β₁, ..., β_T तय किए जाते हैं, जो 0 और 1 के बीच होते हैं। प्रत्येक चरण पर नए डेटा पॉइंट x_t की गणना के लिए x_{t-1} में नॉइज़ जोड़ा जाता है। सुखद बात यह है कि, प्रत्येक चरण से गुजरे बिना, मात्र एक गणितीय सूत्र द्वारा x₀ में से सीधे ही किसी भी चरण x_t का नॉइज़ जोड़ा हुआ फोटो गिना जा सकता है। जैसे-जैसे चरण t अनंत की ओर जाता है, त्यों मूल चित्र पूरी तरह नष्ट होकर शुद्ध गोशियन नॉइज़ N(0, I) बन जाता है।
डिफ्यूजन मॉडल की वास्तविक जादुई ताकत इसके 'रिवर्स सैंपलिंग प्रोसेस' में है। चूंकि फॉरवर्ड प्रोसेस में जोड़ा गया नॉइज़ हमें पता होता है, परंतु इसे सीधे उलटाना (intractable) असंभव होता है। अतः, एक आर्टिफिशियल न्यूरल नेटवर्क को प्रशिक्षित किया जाता है जो इस रिवर्स प्रक्रिया का गणितीय अंदाजन लगाता है। इस न्यूरल नेटवर्क को मॉडल का 'बैकबोन' (Backbone) कहा जाता है। सामान्यतः इस बैकबोन के रूप में 'यू-नेट' (U-Net) या 'ट्रांसफार्मर' (Transformer) आर्किटेक्चर का उपयोग होता है। तालीम के दौरान, नेटवर्क x_t और समय t जानकर उसमें जोड़े गए नॉइज़ z_θ का सटीक अंदाज़ लगाता है।
कम्प्यूटेशनल खर्च घटाने के लिए, शोधकर्ताओं ने 'लेटेंट डिफ्यूजन मॉडल्स' (Latent Diffusion Models - LDM) विकसित किए। वास्तविक पिक्सेल स्पेस में डिफ्यूजन चलाना बहुत भारी पड़ता है, इसलिए पहले ऑटोएनकोडर द्वारा चित्र को छोटे गणितीय परिमाण वाले 'लेटेंट स्पेस' (Latent Space) में संकुचित किया जाता है। तत्पश्चात सभी डिफ्यूजन और डैनोइजिंग प्रोसेस इस लेटेंट स्पेस में ही होते हैं। Stable Diffusion इसी सिद्धांत पर कार्य करता है। उपयोगकर्ता द्वारा दिए गए टेक्स्ट प्रॉम्प्ट को चित्र में बदलने के लिए क्रॉस-अटेंशन मॉड्यूल्स (cross-attention modules) और टेक्स्ट-एनकोडर्स का उपयोग किया जाता है।
जेनरेट किए गए चित्र पर उपयोगकर्ता का नियंत्रण बढ़ाने के लिए 'क्लासिफायर-फ्री गाइडेंस' (Classifier-free guidance - CFG) का उपयोग किया जाता है। CFG तकनीक में मॉडल को एक साथ शर्तीय (Conditional, यानी टेक्स्ट के साथ) और गैर-शर्तीय (Unconditional, टेक्स्ट के बिना) दोनों तरह से प्रशिक्षित किया जाता है। सैंपलिंग करते समय, गाइडेंस स्केल 'w' द्वारा इन दोनों के अंतर को गुणा किया जाता है। इससे चित्र की विविधता और टेक्स्ट प्रॉम्प्ट के प्रति सटीकता के बीच संतुलन बनाए रखा जा सकता है।
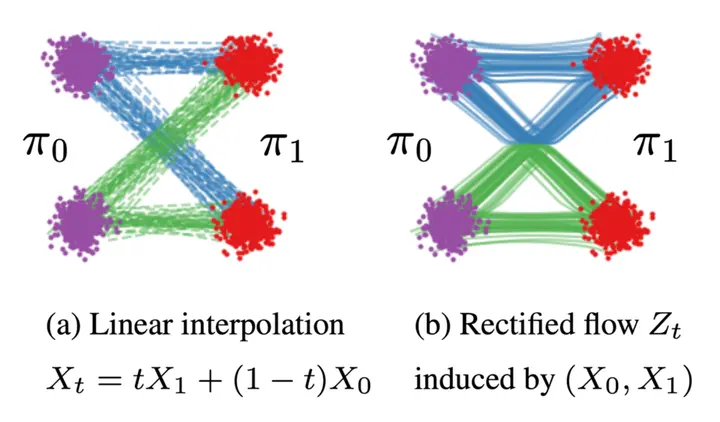
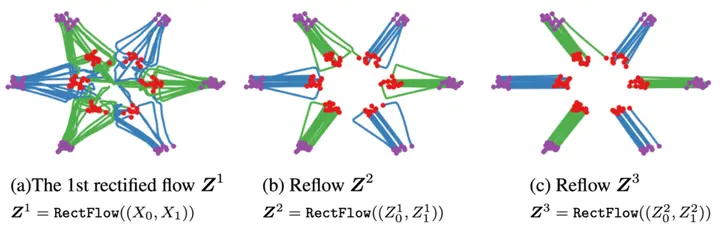
2020 में सोंग (Song) और उनके साथियों ने डिफ्यूजन मॉडल्स को 'कंटीन्यूअस-टाइम स्टोकेस्टिक डिफरेंशियल इक्वेशंस' (Stochastic Differential Equations - SDEs) के सार्वभौमिक ढांचे में प्रस्तुत किया। इस गणना से डिफ्यूजन प्रक्रिया को अनंत छोटे समयाकाल में विभाजित किया जा सकता है। इस दृष्टिकोण से 'प्रोबेबिलिटी फ्लो ODE' की संतति हुई, जिससे डेटा की त्वरित सैंपलिंग और सटीक गणना संभव बनी। हाल के वर्षों में 'फ्लो मैचिंग' (Flow Matching) और 'रेक्टिफाइड फ्लो' (Rectified Flow) जैसी तकनीकें आई हैं, जो नॉइज़ और डेटा के बीच के मार्गों को सीधा (straight trajectories) बनाती हैं, जिससे मॉडल मात्र कुछ ही स्टेप्स में चित्र बना सकता है।
2024 तक, डिफ्यूजन मॉडल्स केवल चित्र सृजन तक सीमित नहीं रहे हैं। कंप्यूटर विजन में चित्र से नॉइज़ दूर करना (image denoising), इनपेंटिंग (inpainting), सुपर-रिजॉल्यूशन और हाई-क्वालिटी वीडियो जनरेशन के लिए इसका व्यापक उपयोग हो रहा है। इसके अलावा, नेचुरल लैंग्वेज प्रोसेसिंग में टेक्स्ट समराइजेशन, ऑडियो-साउंड जनरेशन और रिइंफोर्समेंट लर्निंग में भी डिफ्यूजन आर्किटेक्चर महत्वपूर्ण भूमिका निभा रहा है।
भारत जैसे देश के लिए, जहां AI तकनीक का उपयोग शिक्षा, कृषि, और डिजाइनिंग क्षेत्र में तेजी से बढ़ रहा है, वहां डिफ्यूजन मॉडल्स की गणितीय और आर्किटेक्चरल समझ अत्यंत महत्वपूर्ण है। हालांकि, इन मॉडल्स को प्रशिक्षित करने के लिए विशाल कंप्यूटिंग पावर (GPUs) की आवश्यकता पड़ती है। भविष्य में अधिक कार्यक्षमता, कम स्टेप्स में काम करने वाले और कम कंप्यूटेशनल खर्च वाले रेक्टिफाइड डिफ्यूजन मॉडल्स AI क्रांति को अधिक जनोपयोगी बनाएंगे।


