ટ્રાન્સફોર્મર અને મલ્ટી-હેડ એટેન્શન: આધુનિક કૃત્રિમ બુદ્ધિમત્તાનું મૂળ એન્જિન કેવી રીતે કામ કરે છે?
શબ્દો વચ્ચેના સંબંધોને એકસાથે માપીને ભાષા સમજવાની ક્ષમતા આપતી ટ્રાન્સફોર્મર આર્કિટેક્ચર અને તેની ગાણિતિક પ્રક્રિયાની ઊંડી સમજૂતી.

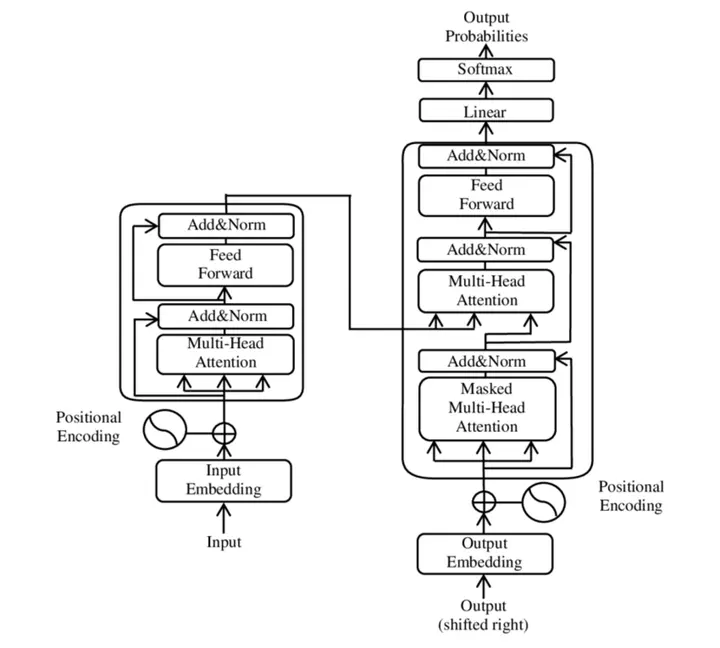
આજે વિશ્વભરમાં ચર્ચાતા મોટા ભાષા મોડેલ્સ જેવા કે ChatGPT, Claude કે વિઝન મોડેલ્સ પાછળ એક જ મૂળભૂત ટેકનોલોજી કામ કરી રહી છે, જેને ટ્રાન્સફોર્મર (Transformer) આર્કિટેક્ચર કહેવામાં આવે છે. ૧૨ જૂન ૨૦૧૭ના રોજ ગૂગલના સંશોધકો દ્વારા પ્રસિદ્ધ કરાયેલા ઐતિહાસિક સંશોધન પત્ર "Attention Is All You Need" માં આ મોડેલ સૌપ્રથમ વખત રજૂ કરવામાં આવ્યું હતું. તે સમયે સંશોધનનો મુખ્ય ઉદ્દેશ્ય મશીન ટ્રાન્સલેશન એટલે કે ભાષાંતરની પ્રક્રિયાને વધુ સચોટ અને ઝડપી બનાવવાનો હતો, પરંતુ આ આર્કિટેક્ચરે સમગ્ર આર્ટિફિશિયલ ઇન્ટેલિજન્સ જગતનું ચિત્ર બદલી નાખ્યું.
ટ્રાન્સફોર્મર મોડેલની સૌથી મોટી વિશેષતા તેની સમાંતર ગણતરી (parallel processing) કરવાની અજોડ ક્ષમતા છે. ટ્રાન્સફોર્મર આવ્યા તે પહેલાં ઉપયોગમાં લેવાતા ન્યુરલ નેટવર્ક્સ લખાણને એક પછી એક શબ્દ કરીને ક્રમિક રીતે વાંચતા હતા, જ્યારે ટ્રાન્સફોર્મર સમગ્ર વાક્યને એકસાથે સ્કેન કરી શકે છે. આ ક્રાંતિકારી ફેરફાર પાછળનું મુખ્ય ચાલક બળ 'મલ્ટી-હેડ એટેન્શન' (Multi-head attention) મિકેનિઝમ છે, જે દરેક શબ્દને અન્ય તમામ શબ્દો સાથેના તેના સંદર્ભ અને મહત્વના આધારે જોડે છે.
ક્રમિક પ્રક્રિયાથી સમાંતર ગણતરી સુધીનો ઇતિહાસ
ટ્રાન્સફોર્મરના આગમન પહેલાં રિકરન્ટ ન્યુરલ નેટવર્ક્સ (RNN), જેમ કે ૧૯૯૦નું Elman નેટવર્ક, ક્રમિક ડેટા માટે વ્યાપકપણે વપરાતા હતા. પરંતુ તેમાં એક મોટી ખામી વેનિશિંગ ગ્રેડિયન્ટ (vanishing-gradient) સમસ્યા હતી, જેના કારણે લાંબા વાક્યના અંતે પહોંચતા સુધીમાં શરૂઆતના શબ્દોની માહિતી નષ્ટ થઈ જતી હતી. આ ખામી નિવારવા ૧૯૯૭માં લોંગ શોર્ટ-ટર્મ મેમરી (LSTM) રજૂ કરવામાં આવી, જેમાં મલ્ટિપ્લિકેટિવ ગેટિંગ યુનિટ્સ દ્વારા માહિતી સાચવી શકાતી હતી. આમ છતાં, LSTM પણ એક સમયે એક જ ટોકન પર કામ કરી શકતું હોવાથી સુપરકોમ્પ્યુટર્સ કે ગ્રાફિક્સ પ્રોસેસિંગ યુનિટ્સ (GPU) પર સમાંતર રીતે ઝડપથી તાલીમ પામી શકતું ન હતું.
૨૦૧૪માં એન્કોડર-ડીકોડર આધારિત સિક્વન્સ-ટુ-સિક્વન્સ (seq2seq) મોડેલ્સ આવ્યા, જેમાં ૩૮૦ મિલિયન પેરામીટર્સ ધરાવતું મશીન ટ્રાન્સલેશન મોડેલ બે LSTM નેટવર્ક્સ વાપરતું હતું. અન્ય એક ૧૩૦ મિલિયન પેરામીટર્સવાળા મોડેલમાં ગેટિડ રિકરન્ટ યુનિટ (GRU) વપરાયું હતું. પરંતુ સમગ્ર વાક્યને એક નિશ્ચિત કદના વેક્ટરમાં સંકુચિત કરવા જતાં માહિતીનો સંકોચ (bottleneck) થતો હતો. આ સમસ્યા ઉકેલવા 'RNN સર્ચ' દ્વારા અટેન્શન પદ્ધતિ ઉમેરાઈ. ૨૦૧૬માં ગૂગલે ન્યુરલ મશીન ટ્રાન્સલેશન (GNMT) શરૂ કર્યું, જેમાં ૮ સ્તરોના બાયડિરેક્શનલ LSTM હતા. તેમ છતાં, મૂળભૂત સમસ્યા ક્રમિક પ્રક્રિયાની જ હતી, જ્યાં સુધી જેકોબ ઉસ્કોરાઇટ અને તેમના સાથીઓએ રિકરન્સ વિના કેવળ એટેન્શન આધારિત સંપૂર્ણ નેટવર્ક વિકસાવવાની કલ્પના ન કરી.
| મોડેલ | પેરામીટર્સ | આર્કિટેક્ચર |
|---|---|---|
| મશીન ટ્રાન્સલેશન મોડેલ | 380 મિલિયન | બે LSTM નેટવર્ક્સ |
| અન્ય મોડેલ | 130 મિલિયન | ગેટિડ રિકરન્ટ યુનિટ (GRU) |
| GNMT (ગૂગલ) | લાગુ નથી | 8 સ્તરોના બાયડિરેક્શનલ LSTM |
ટ્રાન્સફોર્મરનું અંદરનું માળખું અને પોઝિશનલ એન્કોડિંગ
ટ્રાન્સફોર્મરના કાર્યને સમજવા માટે તેના ડેટા પ્રવાહને સમજવો જરૂરી છે. જ્યારે કોઈ લખાણ, ચિત્ર કે અવાજ મોડેલમાં પ્રવેશે છે, ત્યારે તેને સૌપ્રથમ ડિજિટલ ટુકડાઓમાં વહેંચવામાં આવે છે, જેને ટોકન (token: શબ્દ કે તેનો નાનો અંશ) કહે છે. આ દરેક ટોકનને એમ્બેડિંગ લેયર દ્વારા સંખ્યાઓના એક લાંબા સંગ્રહ એટલે કે વેક્ટર (vector: ગાણિતિક પરિમાણ સૂચવતી શ્રેણી) માં ફેરવવામાં આવે છે.
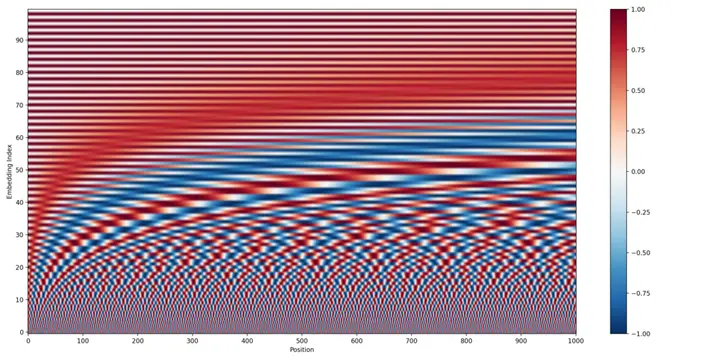
પરંતુ અહીં એક મોટો પડકાર ઉપસ્થિત થાય છે: જો બધા ટોકન્સ એકસાથે પ્રોસેસ થતા હોય, તો મોડેલને શબ્દોના ક્રમની કેવી રીતે ખબર પડે? ઉદાહરણ તરીકે, "રામે રાવણને માર્યો" અને "રાવણે રામને માર્યો" બંનેમાં સમાન શબ્દો છે પરંતુ ક્રમ બદલાતા અર્થ ઊલટો થઈ જાય છે. સેલ્ફ-એટેન્શન મૂળભૂત રીતે ક્રમ-નિરપેક્ષ (permutation-invariant) છે. તેથી ટ્રાન્સફોર્મર દરેક શબ્દના વેક્ટરમાં પોઝિશનલ એન્કોડિંગ (positional encoding) ઉમેરે છે, જે સાઇન અને કોસાઇન તરંગો આધારિત ગાણિતિક સંકેતો દ્વારા શબ્દનું વાક્યમાં ચોક્કસ સ્થાન દર્શાવે છે.
અટેન્શનનું ગણિત: ક્વેરી, કી અને વેલ્યુ
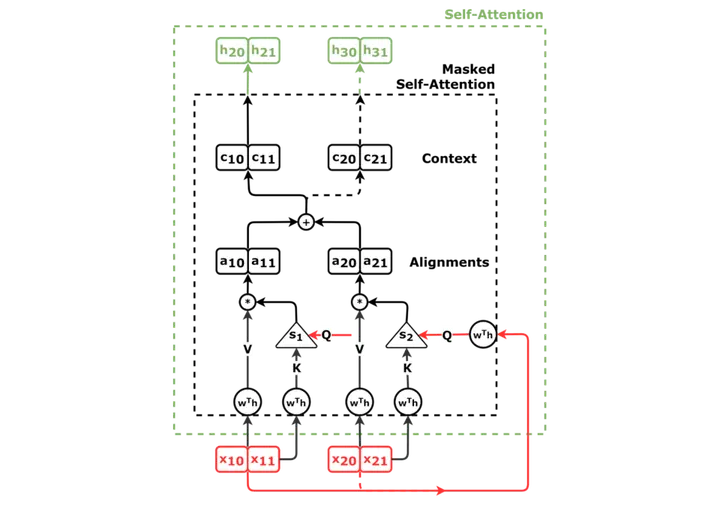
સ્કેલ્ડ ડોટ-પ્રોડક્ટ એટેન્શન (Scaled dot-product attention) ટ્રાન્સફોર્મરનું હૃદય છે. તેને સમજવા માટે પુસ્તકાલયનું એક સરસ ઉદાહરણ લઈ શકાય. જ્યારે તમે લાઈબ્રેરિયન પાસે જઈને કહો કે "મને ગુજરાતના ઇતિહાસનું પુસ્તક જોઈએ છે", ત્યારે તમારી આ માંગણી એ 'ક્વેરી' (Query - Q) છે. પુસ્તકાલયના દરેક પુસ્તકના પૂંઠા પર લખેલું વિષયનું લેબલ એ 'કી' (Key - K) છે. લાઈબ્રેરિયન તમારી ક્વેરી સાથે તમામ પુસ્તકોની કી સરખાવે છે અને જે સૌથી વધુ મેળ ખાતી હોય તે પુસ્તકની અંદર રહેલી વાસ્તવિક માહિતી તમને આપે છે, જે 'વેલ્યુ' (Value - V) છે.
ગણિતની ભાષામાં, જ્યારે ક્વેરી મેટ્રિક્સ Q અને કી મેટ્રિક્સ Kનો ડોટ-પ્રોડક્ટ ગુણાકાર કરવામાં આવે છે, ત્યારે દરેક શબ્દનો બીજા દરેક શબ્દ સાથેનો સંબંધિત સ્કોર મળે છે. જો કી પરિમાણ d_k મોટું હોય, તો ડોટ-પ્રોડક્ટનું મૂલ્ય ઘણું મોટું થઈ શકે છે, જેનાથી ગ્રેડિયન્ટ્સ નાશ પામે છે. તેથી તેને d_k ના વર્ગમૂળ વડે ભાગવામાં (scale) આવે છે. ત્યારબાદ સોફ્ટમેક્સ (softmax) વિધેય લાગુ કરીને સ્કોરને ૦ થી ૧ વચ્ચેની સંભાવનામાં ફેરવાય છે, જે દર્શાવે છે કે કયા શબ્દ પર કેટલું વજન (weight) મૂકવું. છેલ્લે આ વજનનો વેલ્યુ મેટ્રિક્સ V સાથે ગુણાકાર થાય છે.
- ડોટ-પ્રોડક્ટ ગુણાકારક્વેરી મેટ્રિક્સ (Q) અને કી મેટ્રિક્સ (K ના ટ્રાન્સપોઝ) નો ગુણાકાર કરી કાચો સુસંગતતા સ્કોર મેળવવામાં આવે છે.
- સ્કેલિંગ ફેક્ટર વિભાજનસ્કોરને કીના પરિમાણના વર્ગમૂળ (√d_k) વડે ભાગવામાં આવે છે જેથી અતિશય મોટા મૂલ્યો નિયંત્રિત રહે.
- સોફ્ટમેક્સ સંભાવનાદરેક હરોળ પર સોફ્ટમેક્સ વિધેય લાગુ કરીને ૦ થી ૧ વચ્ચેના ચોક્કસ એટેન્શન વજન (weights) નિર્ધારિત થાય છે.
- વેલ્યુ સાથે વેઇટેડ સરવાળોગણતરી કરેલા એટેન્શન વજનનો વેલ્યુ મેટ્રિક્સ (V) સાથે ગુણાકાર કરી અંતિમ કોન્ટેક્સ્ટ વેક્ટર ઉત્પન્ન કરાય છે.

મલ્ટી-હેડ એટેન્શન શા માટે જરૂરી છે?
એક જ વાક્યમાં એક શબ્દના અનેક પ્રકારના સંબંધો હોઈ શકે છે. દાખલા તરીકે, "બેંકે નદીના કિનારે નવી શાખા ખોલી" વાક્યમાં 'બેંક' શબ્દનો વ્યાકરણિક સંબંધ ક્રિયાપદ 'ખોલી' સાથે છે, પરંતુ સંદર્ભિત અર્થ નાણાકીય સંસ્થા તરીકે 'શાખા' સાથે જોડાયેલો છે. જો કેવળ એક જ એટેન્શન પદ્ધતિ હોય તો તે એક સમયે કદાચ એક જ પાસા પર ધ્યાન આપી શકે.
આ મર્યાદા દૂર કરવા માટે ટ્રાન્સફોર્મરમાં મલ્ટી-હેડ એટેન્શન (Multi-Head Attention) મૂકવામાં આવ્યું છે. મૂળ ૧૦૦ મિલિયન પેરામીટર્સવાળા મોડેલમાં સ્વતંત્ર એટેન્શન હેડ્સ વાપરવામાં આવ્યા હતા. આ દરેક 'હેડ' (head) શબ્દોના વેક્ટર્સને અલગ-અલગ પરિમાણોમાં પ્રોજેક્ટ કરે છે અને એકસાથે સમાંતર રીતે ગણતરી કરે છે. એક હેડ કદાચ વ્યાકરણ પર નજર રાખે છે, બીજો હેડ સર્વનામો કોના માટે વપરાયા છે તે શોધે છે, અને ત્રીજો હેડ વિષયવસ્તુના ઊંડા અર્થને પકડે છે. છેલ્લે આ તમામ હેડ્સના પરિણામોને જોડીને (concatenate કરીને) અંતિમ આઉટપુટ મેટ્રિક્સ તૈયાર કરવામાં આવે છે.

કોઝલ માસ્કિંગ અને તાલીમની સ્થિરતા
ટ્રાન્સફોર્મરના એન્કોડરમાં સેલ્ફ-એટેન્શન આગળ-પાછળના તમામ શબ્દોને મુક્તપણે જોઈ શકે છે, પરંતુ ડીકોડર સ્તરે આ મુક્તિ સમસ્યા સર્જી શકે છે. જ્યારે મોડેલ નવું વાક્ય જનરેટ કરી રહ્યું હોય, ત્યારે તે ભવિષ્યમાં આવનારા શબ્દોની 'ચોરી' ન કરી લે તે જોવું અનિવાર્ય છે. આ માટે કોઝલ માસ્કિંગ (causal masking) વપરાય છે. આ પ્રક્રિયામાં ભવિષ્યના શબ્દોના સ્થાને માઈનસ ઈન્ફિનિટી (-∞) મૂકી દેવાય છે, જેથી સોફ્ટમેક્સ ગણતરી પછી તેમનું વજન શૂન્ય થઈ જાય અને મોડેલ કેવળ ભૂતકાળના શબ્દોના આધારે જ આગળનો શબ્દ ધારે.
શરૂઆતના પ્લેન ટ્રાન્સફોર્મર મોડેલોને તાલીમ દરમિયાન સ્થિર રાખવા મુશ્કેલ હતા. મૂળ સંશોધન પત્રમાં લર્નિંગ રેટ વોર્મ-અપની ભલામણ કરાઈ હતી, જેમાં શરૂઆતના ૨% પગલાં સુધી લર્નિંગ રેટ શૂન્યથી વધારીને મહત્તમ કરાતો હતો. ૨૦૨૦ના એક સંશોધનમાં જણાયું કે લેયર નોર્મલાઇઝેશનને એટેન્શન લેયરની આગળ મૂકવાથી (Pre-LN) તાલીમ ખૂબ સ્થિર બને છે. વધુમાં, ઓવરફિટિંગ અટકાવવા ડ્રોપઆઉટ (dropout) અને લેબલ સ્મૂધિંગ જેવી પદ્ધતિઓ પણ ઉપયોગમાં લેવાય છે.
વૈશ્વિક પ્રભાવ અને ભવિષ્યની દિશા
ટ્રાન્સફોર્મર આર્કિટેક્ચરનું આગમન કેવળ ભાષા અનુવાદ પૂરતું મર્યાદિત ન રહ્યું. ૨૦૧૮માં ગૂગલે એન્કોડર-ઓન્લી BERT રજૂ કર્યું, જેણે ૨૦૧૯થી ગૂગલ સર્ચ ક્વેરીઝ પ્રોસેસ કરવાનું શરૂ કર્યું. ૨૦૨૦માં ગૂગલ ટ્રાન્સલેટે પણ જૂની સિસ્ટમ હટાવી ટ્રાન્સફોર્મર આધારિત સિસ્ટમ અપનાવી. બીજી તરફ, OpenAI દ્વારા ૨૦૧૮થી શરૂ કરાયેલી ડીકોડર-ઓન્લી GPT શ્રેણીએ ૨૦૨૨ના અંતમાં ChatGPT સ્વરૂપે વિશ્વભરમાં જનરેટિવ AIની નવી ક્રાંતિ સર્જી.
આજે આ જ સિદ્ધાંત કમ્પ્યુટર વિઝન માટે વિઝન ટ્રાન્સફોર્મર્સ (ViT), રોબોટિક્સ, ઓડિયો અને ૨૦૨૧ના DALL-E, ૨૦૨૪ના Stable Diffusion 3 અને Sora જેવા અદ્યતન ઇમેજ અને વિડીયો જનરેટર્સમાં વપરાય છે. વિશાળ મોડેલ્સને તાલીમ આપવા માટે ટેન્સર અને પાઇપલાઇન પેરેલલિઝમ દ્વારા હજારો GPU નેટવર્ક્સમાં ડેટા વહેંચવામાં આવે છે. સ્ટાન્ડર્ડ સેલ્ફ-એટેન્શનમાં વાક્યની લંબાઈ વધતા કમ્પ્યુટેશનલ ખર્ચ સ્ક્વેર (ચતુર્ભુજ) ગતિએ વધે છે, જે તેની એક જાણીતી મર્યાદા છે. છતાં, ૨૦૧૭માં શરૂ થયેલી આ અટેન્શન યાત્રાએ આજના આર્ટિફિશિયલ ઇન્ટેલિજન્સને માનવ ભાષાની ઘોંઘાટભરી ઊંડાણો સમજવા સક્ષમ બનાવ્યું છે.


