ट्रांसफार्मर और मल्टी-हेड अटेंशन: आधुनिक कृत्रिम बुद्धिमत्ता का मूल इंजन कैसे काम करता है?
शब्दों के बीच के संबंधों को एक साथ मापकर भाषा को समझने की क्षमता देने वाले ट्रांसफार्मर आर्किटेक्चर और उसकी गणितीय प्रक्रिया की गहरी समझ।

आज विश्वभर में चर्चा में रहने वाले बड़े भाषा मॉडल जैसे कि ChatGPT, Claude या विज़न मॉडल के पीछे एक ही बुनियादी तकनीक काम कर रही है, जिसे ट्रांसफॉर्मर (Transformer) आर्किटेक्चर कहा जाता है। 12 जून 2017 को गूगल के शोधकर्ताओं द्वारा प्रकाशित ऐतिहासिक शोध पत्र "Attention Is All You Need" में यह मॉडल पहली बार प्रस्तुत किया गया था। उस समय शोध का मुख्य उद्देश्य मशीन ट्रांसलेशन यानी अनुवाद की प्रक्रिया को अधिक सटीक और तेज़ बनाना था, लेकिन इस आर्किटेक्चर ने संपूर्ण आर्टिफिशियल इंटेलिजेंस जगत की तस्वीर बदल दी।
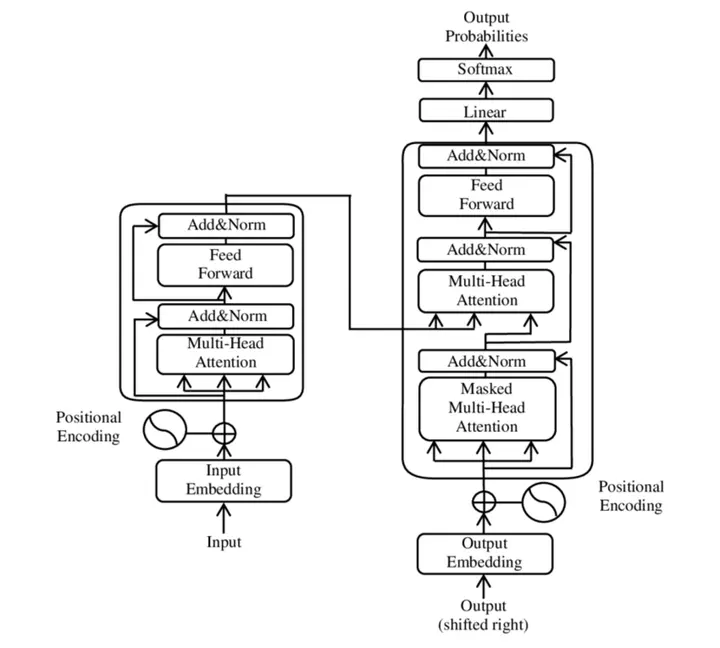
ट्रांसफॉर्मर मॉडल की सबसे बड़ी विशेषता इसकी समानांतर गणना (parallel processing) करने की अद्वितीय क्षमता है। ट्रांसफॉर्मर के आने से पहले उपयोग में लिए जाने वाले न्यूरल नेटवर्क टेक्स्ट को एक के बाद एक शब्द करके क्रमिक रूप से पढ़ते थे, जबकि ट्रांसफॉर्मर पूरे वाक्य को एक साथ स्कैन कर सकता है। इस क्रांतिकारी बदलाव के पीछे मुख्य प्रेरक बल 'मल्टी-हेड अटेंशन' (Multi-head attention) मैकेनिज्म है, जो प्रत्येक शब्द को अन्य सभी शब्दों के साथ उनके संदर्भ और महत्व के आधार पर जोड़ता है।
क्रमिक प्रक्रिया से समानांतर गणना तक का इतिहास
ट्रांसफॉर्मर के आगमन से पहले रिकरेंट न्यूरल नेटवर्क (RNN), जैसे कि 1990 का Elman नेटवर्क, क्रमिक डेटा के लिए व्यापक रूप से उपयोग किए जाते थे। लेकिन उनमें एक बड़ी कमी 'वेनिशिंग ग्रेडिएंट' (vanishing-gradient) समस्या थी, जिसके कारण लंबे वाक्य के अंत तक पहुँचते-पहुँचते शुरुआती शब्दों की जानकारी नष्ट हो जाती थी। इस कमी को दूर करने के लिए 1997 में लॉन्ग शॉर्ट-टर्म मेमोरी (LSTM) पेश की गई, जिसमें मल्टीप्लिकेटिव गेटिंग यूनिट्स के माध्यम से जानकारी सुरक्षित रखी जा सकती थी। इसके बावजूद, LSTM भी एक समय में एक ही टोकन पर काम कर सकता था, इसलिए सुपरकंप्यूटर या ग्राफिक्स प्रोसेसिंग यूनिट्स (GPU) पर समानांतर रूप से तेजी से प्रशिक्षित नहीं हो सकता था।
2014 में एनकोडर-डिकोडर आधारित सीक्वेंस-टू-सीक्वेंस (seq2seq) मॉडल आए, जिसमें 380 मिलियन पैरामीटर्स वाला मशीन ट्रांसलेशन मॉडल दो LSTM नेटवर्क का उपयोग करता था। अन्य एक 130 मिलियन पैरामीटर्स वाले मॉडल में गेटेड रिकरेंट यूनिट (GRU) का उपयोग किया गया था। लेकिन पूरे वाक्य को एक निश्चित आकार के वेक्टर में संकुचित करने के कारण जानकारी का संकुचन (bottleneck) हो जाता था। इस समस्या को हल करने के लिए 'RNN सर्च' के माध्यम से अटेंशन पद्धति जोड़ी गई। 2016 में गूगल ने न्यूरल मशीन ट्रांसलेशन (GNMT) शुरू किया, जिसमें 8 स्तरों के बायडायरेक्शनल LSTM थे। फिर भी, मूल समस्या क्रमिक प्रक्रिया की ही थी, जब तक कि जैकब उस्कोराइट और उनके सहयोगियों ने रिकरेंस के बिना केवल अटेंशन आधारित संपूर्ण नेटवर्क विकसित करने की कल्पना नहीं की।
| मॉडल | पैरामीटर्स | आर्किटेक्चर |
|---|---|---|
| मशीन ट्रांसलेशन मॉडल | 380 मिलियन | दो LSTM नेटवर्क्स |
| अन्य मॉडल | 130 मिलियन | गेटिड रिकरंट यूनिट (GRU) |
| GNMT (गूगल) | लागू नहीं | 8 स्तरों के बायडायरेक्शनल LSTM |
ट्रांसफॉर्मर का आंतरिक ढांचा और पोजीशनल एनकोडिंग
ट्रांसफॉर्मर के कार्य को समझने के लिए उसके डेटा प्रवाह को समझना आवश्यक है। जब कोई लिखावट, चित्र या आवाज़ मॉडल में प्रवेश करती है, तो उसे सबसे पहले डिजिटल टुकड़ों में विभाजित किया जाता है, जिन्हें टोकन (token: शब्द या उसका छोटा अंश) कहा जाता है। इन सभी टोकनों को एम्बेडिंग लेयर द्वारा संख्याओं के एक लंबे संग्रह यानी वेक्टर (vector: गणितीय परिमाण दर्शाने वाली श्रेणी) में बदल दिया जाता है।
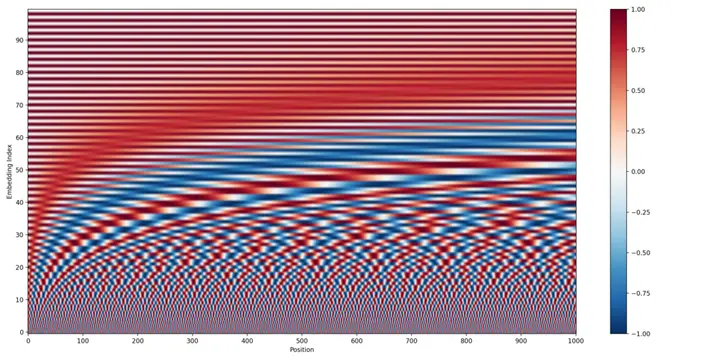
परंतु यहाँ एक बड़ी चुनौती उपस्थित होती है: यदि सभी टोकन एकसाथ प्रोसेस हो रहे हों, तो मॉडल को शब्दों के क्रम का कैसे पता चलता है? उदाहरण के लिए, "रामे रावणं मार्यो" (राम ने रावण को मारा) और "रावणे रामं मार्यो" (रावण ने राम को मारा) दोनों में समान शब्द हैं परंतु क्रम बदलने पर अर्थ उल्टा हो जाता है। सेल्फ-अटेंशन मूल रूप से क्रम-निरपेक्ष (permutation-invariant) है। इसलिए ट्रांसफॉर्मर प्रत्येक शब्द के वेक्टर में पॉजिशनल एन्कोडिंग (positional encoding) जोड़ता है, जो साइन और कोसाइन तरंगों पर आधारित गणितीय संकेतों द्वारा वाक्य में शब्द का सटीक स्थान दर्शाता है।
अटेंशन का गणित: क्वेरी, की और वैल्यू
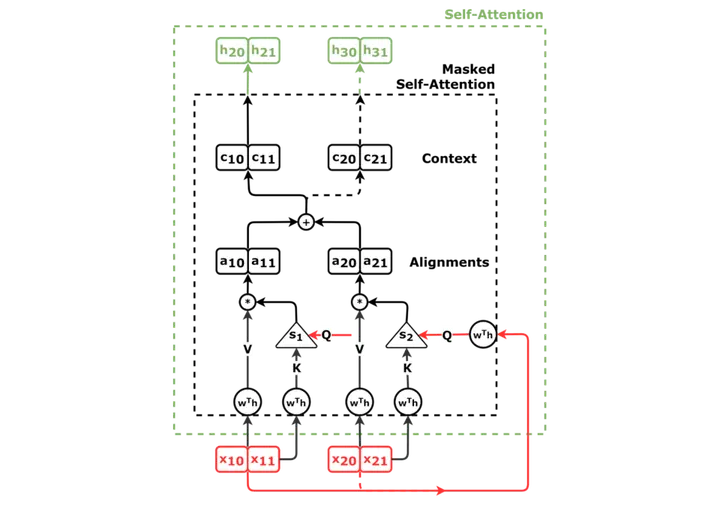
स्केल्ड डॉट-प्रोडक्ट अटेंशन (Scaled dot-product attention) ट्रांसफॉर्मर का हृदय है। इसे समझने के लिए पुस्तकालय का एक बेहतरीन उदाहरण लिया जा सकता है। जब आप लाइब्रेरियन के पास जाकर कहें कि "मुझे गुजरात के इतिहास की पुस्तक चाहिए", तब आपकी यह माँग 'क्वेरी' (Query - Q) है। पुस्तकालय की प्रत्येक पुस्तक के कवर पर लिखा हुआ विषय का लेबल 'की' (Key - K) है। लाइब्रेरियन आपकी क्वेरी के साथ सभी पुस्तकों की की की तुलना करता है और जो सबसे अधिक मेल खाती है उस पुस्तक के अंदर मौजूद वास्तविक जानकारी आपको देता है, जो 'वेल्यू' (Value - V) है।
गणित की भाषा में, जब क्वेरी मैट्रिक्स Q और की मैट्रिक्स K का डॉट-प्रोडक्ट गुणा किया जाता है, तो प्रत्येक शब्द का दूसरे प्रत्येक शब्द के साथ संबंधित स्कोर मिलता है। यदि की परिमाण d_k बड़ा हो, तो डॉट-प्रोडक्ट का मान बहुत बड़ा हो सकता है, जिससे ग्रेडिएंट्स नष्ट हो जाते हैं। इसलिए इसे d_k के वर्गमूल द्वारा विभाजित (scale) किया जाता है। इसके बाद सॉफ्टमैक्स (softmax) फ़ंक्शन लागू करके स्कोर को 0 से 1 के बीच की संभावना में बदला जाता है, जो यह दर्शाता है कि किस शब्द पर कितना वजन (weight) रखना है। अंत में इस वजन का वैल्यू मैट्रिक्स V के साथ गुणा किया जाता है।
- डॉट-प्रोडक्ट गुणाक्वेरी मैट्रिक्स (Q) और की मैट्रिक्स (K के ट्रांसपोज़) का गुणा करके कच्चा सुसंगतता स्कोर प्राप्त किया जाता है।
- स्केलिंग फैक्टर विभाजनस्कोर को की के आयाम के वर्गमूल (√d_k) द्वारा भागा जाता है ताकि अत्यधिक बड़े मूल्य नियंत्रित रहें।
- सॉफ्टमैक्स संभावनाप्रत्येक पंक्ति पर सॉफ्टमैक्स विधेय लागू करके ० से १ के बीच के सटीक अटेंशन वजन (weights) निर्धारित होते हैं।
- वेल्यू के साथ वेटेड योगगणना किए गए अटेंशन वजन का वेल्यू मैट्रिक्स (V) के साथ गुणा कर अंतिम कॉन्टेक्स्ट वेक्टर उत्पन्न किया जाता है।

मल्टी-हेड अटेंशन क्यों आवश्यक है?
एक ही वाक्य में एक शब्द के अनेक प्रकार के संबंध हो सकते हैं। उदाहरण के लिए, "बैंक ने नदी के किनारे नई शाखा खोली" वाक्य में 'बैंक' शब्द का व्याकरणिक संबंध क्रियापद 'खोली' के साथ है, लेकिन संदर्भित अर्थ वित्तीय संस्था के रूप में 'शाखा' के साथ जुड़ा हुआ है। यदि केवल एक ही अटेंशन पद्धति हो तो वह एक समय में शायद एक ही पहलू पर ध्यान दे सके।
इस सीमा को दूर करने के लिए ट्रांसफॉर्मर में मल्टी-हेड अटेंशन (Multi-Head Attention) रखा गया है। मूल 100 मिलियन पैरामीटर्स वाले मॉडल में स्वतंत्र अटेंशन हेड्स का इस्तेमाल किया गया था। यह प्रत्येक 'हेड' (head) शब्दों के वेक्टर्स को अलग-अलग आयामों में प्रोजेक्ट करता है और एक साथ समानांतर रूप से गणना करता है। एक हेड शायद व्याकरण पर नज़र रखता है, दूसरा हेड सर्वनाम किसके लिए प्रयुक्त हुए हैं यह ढूँढता है, और तीसरा हेड विषय-वस्तु के गहरे अर्थ को पकड़ता है। अंत में इन तमाम हेड्स के परिणामों को जोड़कर (concatenate करके) अंतिम आउटपुट मैट्रिक्स तैयार किया जाता है।

कॉज़ल मास्किंग और प्रशिक्षण की स्थिरता
ट्रांसफॉर्मर के एनकोडर में सेल्फ-अटेंशन आगे-पीछे के तमाम शब्दों को स्वतंत्र रूप से देख सकता है, लेकिन डिकोडर स्तर पर यह स्वतंत्रता समस्या पैदा कर सकती है। जब मॉडल नया वाक्य जनरेट कर रहा हो, तब यह देखना अनिवार्य है कि वह भविष्य में आने वाले शब्दों की 'चोरी' न कर ले। इसके लिए कॉज़ल मास्किंग (causal masking) का इस्तेमाल किया जाता है। इस प्रक्रिया में भविष्य के शब्दों के स्थान पर माइनस इनफिनिटी (-∞) रख दिया जाता है, ताकि सॉफ्टमैक्स गणना के बाद उनका वज़न शून्य हो जाए और मॉडल केवल पिछले शब्दों के आधार पर ही अगला शब्द अनुमानित करे।
शुरुआती प्लेन ट्रांसफॉर्मर मॉडल को प्रशिक्षण के दौरान स्थिर रखना मुश्किल था। मूल शोध पत्र में लर्निंग रेट वॉर्म-अप की सिफारिश की गई थी, जिसमें शुरुआती 2% चरणों तक लर्निंग रेट शून्य से बढ़ाकर अधिकतम किया जाता था। 2020 के एक शोध में पता चला कि लेयर नॉर्मलाइज़ेशन को अटेंशन लेयर के आगे रखने से (Pre-LN) प्रशिक्षण बहुत स्थिर बनता है। इसके अलावा, ओवरफिटिंग रोकने के लिए ड्रॉपआउट (dropout) और लेबल स्मूथिंग जैसी पद्धतियों का भी उपयोग किया जाता है।
वैश्विक प्रभाव और भविष्य की दिशा
ट्रांसफॉर्मर आर्किटेक्चर का आगमन केवल भाषा अनुवाद तक सीमित नहीं रहा। 2018 में गूगल ने एनकोडर-ओनली BERT पेश किया, जिसने 2019 से गूगल सर्च क्वेरीज़ प्रोसेस करना शुरू किया। 2020 में गूगल ट्रांसलेट ने भी पुरानी प्रणाली हटाकर ट्रांसफॉर्मर आधारित प्रणाली अपनाई। दूसरी ओर, OpenAI द्वारा 2018 से शुरू की गई डिकोडर-ओनली GPT श्रृंखला ने 2022 के अंत में ChatGPT के रूप में विश्वभर में जनरेटिव AI की नई क्रांति पैदा की।
आज यही सिद्धांत कंप्यूटर विज़न के लिए विज़न ट्रांसफॉर्मर्स (ViT), रोबोटिक्स, ऑडियो और 2021 के DALL-E, 2024 के Stable Diffusion 3 और Sora जैसे उन्नत इमेज और वीडियो जनरेटर्स में इस्तेमाल होता है। विशाल मॉडल्स को प्रशिक्षित करने के लिए टेंसर और पाइपलाइन पैरेललिज्म द्वारा हज़ारों GPU नेटवर्क्स में डेटा बाँटा जाता है। स्टैंडर्ड सेल्फ-अटेंशन में वाक्य की लंबाई बढ़ने पर कंप्यूटेशनल खर्च स्क्वेयर (चतुर्घात) गति से बढ़ता है, जो इसकी एक जानी-मानी सीमा है। फिर भी, 2017 में शुरू हुई यह अटेंशन यात्रा आज के आर्टिफिशियल इंटेलिजेंस को मानव भाषा की पेचीदा गहराइयों को समझने में सक्षम बना चुकी है।


