हैलोवीन के लिए ओपन AI मॉडल्स से लैस बोलने वाला 'मॉन्स्टर हाउस' पेश किया गया
NVIDIA के नेमोट्रॉन ओपन मॉडल्स और स्थानीय वर्कस्टेशन की मदद से गैरेज के दरवाजे को एक जीवंत, मुखर और हास्यप्रद राक्षस में बदल दिया गया है।
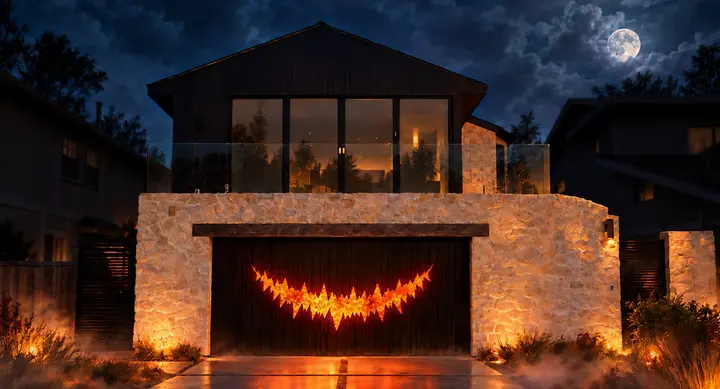
आर्टिफिशियल इंटेलिजेंस (AI) के क्षेत्र में मॉडल्स केवल चैटबॉट तक सीमित नहीं रहे हैं, बल्कि भौतिक दुनिया के साथ संवाद करने में सक्षम बन गए हैं। 30 अक्टूबर, 2026 के दिन Hugging Face पर प्रकाशित एक रिपोर्ट के अनुसार, NVIDIA के इंजीनियरों रिक ग्रांडी (Rick Grandy) और मरियम मोतामेदी (Maryam Motamedi) ने 'nemotron-halloween' प्रोजेक्ट के तहत एक अनोखा 'मॉन्स्टर हाउस' (MonsterHouse) तैयार किया है। यह एक ऐसा इंटरैक्टिव घर है जो हैलोवीन के समय आने वाले बच्चों की आवाज़ें सुनता है, एक पाइरेट (pirate) के खराब मिजाज वाली आवाज़ में जवाब देता है और जब आगंतुक विनम्रता से 'प्लीज' (please) कहते हैं तब यह नरम पड़कर चॉकलेट देता है।
इस पूरे प्रोजेक्ट की सबसे खास बात यह है कि इतना जटिल AI आर्किटेक्चर क्लाउड पर निर्भर रहने के बजाय केवल एक ही सिंगल स्थानीय वर्कस्टेशन पर रन होता है। गैरेज के दरवाजे को एक मुंह देकर उसे शिकायत करना सिखाना आर्टिफिशियल इंटेलिजेंस और 3D एनिमेशन का एक अद्भुत समन्वय है। यह सिस्टम NVIDIA के ओपन मॉडल्स परिवार पर आधारित है, जिसमें संवाद, श्रवण, दृष्टि और मुख के हाव-भाव के लिए अलग-अलग AI मॉडल्स एकसाथ काम करते हैं।
मॉन्स्टर हाउस के पीछे की प्रेरणा और पृष्ठभूमि
इस प्रोजेक्ट के सर्जक रिक ग्रांडी के अनुसार, वे हैलोवीन के दौरान अपने घर पर आने वाले बच्चों को एक अलग अनुभव देना चाहते थे। घर खुद ही एक तुनकमिज़ाज लेकिन कम डरावना पात्र बनकर चॉकलेट बांटे, ऐसा विचार था। इसके लिए उन्होंने गैरेज के दरवाजे की लकड़ी की पट्टी को टूटे हुए होंठ के आकार में डिजाइन किया और उसके पीछे डिजिटल आग प्रज्वलित की।
घर के इस पात्र के लिए एक दिलचस्प बैकस्टोरी बनाई गई थी। यह घर एक डूबे हुए पाइरेट जहाज की लकड़ी से बना है और इसके तूफानी अतीत के कारण यह लगातार असंतुष्ट और गुस्से में रहता है। जब भी कोई आगंतुक आता है, तो यह शुरुआत में यह कहकर भगा देता है कि "मैं गुस्सा होने में व्यस्त हूं, पड़ोसियों को परेशान करो!"। लेकिन अगर आगंतुक लगातार बात करें या विनम्र शब्दों का इस्तेमाल करें, तो इसका मिजाज बदल जाता है। एक बार आगंतुक इसे जीत ले, तो यह सिस्टम उस आगंतुक को याद रखता है ताकि हर बार दोबारा बातचीत न करनी पड़े।
- 1. आवाज का श्रवण (Nemotron ASR)मुलाकाती की आवाज रिकॉर्ड कर `nemotron-speech` मॉडल द्वारा रियल-टाइम में टेक्स्ट में रूपांतरित होती है।
- 2. डायलॉग जनरेशन (Bolt E4B)`Nemotron 3.5 Bolt E4B` मॉडल लोरा एडेप्टर की मदद से उचित समुद्री डाकू (pirate) के मिजाज में जवाब लिखता है।
- 3. स्पीच सिंथेसिस (Magpie TTS)`Magpie TTS Zeroshot` मॉडल छोटे वॉयस सैंपल का उपयोग कर जवाब को हूबहू आवाज देता है।
- 4. 3D एनिमेशन (Audio2Face-3D)`Audio2Face-3D` टेक्नोलॉजी आवाज की तरंगों के आधार पर Unreal Engine 5 में मुंह का विजुअल एनिमेशन करती है।
यह सिस्टम कैसे काम करता है: चरण-दर-चरण स्पष्टीकरण
मॉन्स्टर हाउस की बातचीत की प्रक्रिया पांच मुख्य चरणों में बंटी हुई है, जिसे वास्तविक समय में (real-time) बेहद तेजी से अंजाम दिया जाता है:
पहले चरण में श्रवण यानी स्पीच रिकग्निशन (Speech Recognition) होता है। आगंतुक जो कुछ भी बोलता है उसे 'NVIDIA Nemotron Speech ASR' (ऑटोमैटिक स्पीच रिकग्निशन) द्वारा टेक्स्ट में रूपांतरित किया जाता है। इसके लिए `nemotron-speech-streaming-en-0.6b.q8_0.gguf` मॉडल का उपयोग किया जाता है, जो 300 मिलीसेकंड (ms) की शांति (silence) के बाद आवाज़ पूरी हो गई है ऐसा समझ लेता है।
दूसरे चरण में विचार यानी डायलॉग जेनरेशन (Dialogue Generation) होता है। 'NVIDIA Nemotron 3.5 Bolt E4B 4GB' मॉडल बातचीत के अगले जवाब की रचना करता है। यह एक छोटा ओपन लैंग्वेज मॉडल (Small Language Model) है, जिसे लोरा एडाप्टर (LoRA adapter: Low-Rank Adaptation) की मदद से समुद्री डाकू के मिजाज में ढाला गया है।
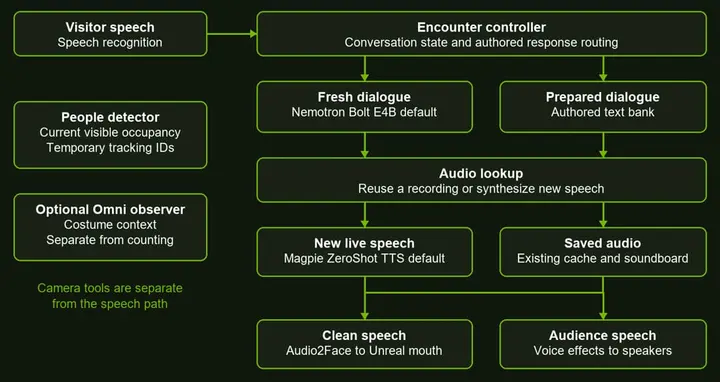
तीसरे चरण में वाचन यानी टेक्स्ट-टू-स्पीच (Text-to-Speech) की बारी आती है। 'NVIDIA Magpie TTS Zeroshot' मॉडल लिखे गए जवाब को जीवंत आवाज में बदलता है। यह सिस्टम शॉर्ट रेफरेंस सैंपल (short reference sample) का उपयोग करके गिनती की सेकंडों में संबंधित भावना के साथ आवाज जनरेट करता है।
चौथे चरण में एनिमेशन (Animation) होता है। 'NVIDIA Audio2Face-3D' तकनीक स्पष्ट आवाज के आधार पर Unreal Engine 5 में बनाए गए लकड़ी के मुंह के हाव-भाव को लाइव एनिमेट करती है। और पांचवें चरण में दृष्टि यानी विजुअल प्रोसेसिंग (Visual Processing) काम करती है, जहां 'NVIDIA Nemotron 3 Nano Omni' नामक VLM (Vision Language Model) कैमरे के सामने आए बच्चों के कोस्च्युम या वेशभूषा को पहचानता है।
| घटक (Component) | मॉडल / टेक्नोलॉजी | कार्य / विवरण |
|---|---|---|
| स्पीच रिकग्निशन (ASR) | nemotron-speech-streaming-en-0.6b.q8_0.gguf | मुलाकाती की आवाज को टेक्स्ट में बदलना |
| लैंग्वेज मॉडल (LLM) | Nemotron 3.5 Bolt E4B 4GB (LoRA fine-tuned) | संभाषण का जवाब तैयार करना |
| टेक्स्ट-टू-स्पीच (TTS) | NVIDIA Magpie TTS Zeroshot | 7 मूड के अनुसार स्पीच सिंथेसिस |
| 3D एनिमेशन | NVIDIA Audio2Face-3D + Unreal Engine 5 | दरवाजे के मुंह का रियल-टाइम लिप-सिंक |
| विजुअल प्रोसेसिंग | Nemotron 3 Nano Omni, YOLO, ByteTrack | मुलाकातियों के कॉस्ट्यूम और संख्या पहचानना |
| प्रथम GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q | ASR, LLM और Voice पाइपलाइन रन करना |
| द्वितीय GPU | NVIDIA RTX PRO 4000 Blackwell | Unreal Engine और Audio2Face प्रोसेसिंग |
तकनीकी आंकड़े, कस्टमाइजेशन और बेंचमार्क
मॉन्स्टर हाउस को जीवंत बनाने के लिए रिक ग्रांडी ने 5,000 से अधिक बहु-चरणीय (multi-turn) वार्ताओं का एक डेटासेट तैयार किया था। इस डेटासेट से अलग-अलग LLM के लिए लोरा (LoRA) एडाप्टर ट्रेन किए गए थे, जो ट्रेन होने में 1 से 2 घंटे का समय लेते थे। कन्वर्सेशनल एजेंट के लिए Qwen3 30B-A3B और Qwen 3.6 35B-A3B जैसे बड़े मॉडल्स की तुलना में Bolt E4B का 4-बिट क्वांटाइज्ड (4-bit quantized) वर्जन अधिक तेज और कम मेमोरी घेरने वाला साबित हुआ था।
इस सिस्टम में रिस्पांस लेटेंसी (response latency) यानी प्रतिक्रिया समय बहुत महत्वपूर्ण है। यदि घर जवाब देने में अधिक समय ले, तो उसकी भयावहता और प्रभावशीलता कम हो जाती है। Bolt Q4 और TTS पाइपलाइन के साथ स्पीच पूरी होने से ऑडियो शुरू होने का मीडियन लेटेंसी (median latency) 1.70 सेकंड रहा था। लेकिन जो जवाब पहले से कैश्ड (cached) यानी सेव किए गए थे, उनमें यह समय घटकर मात्र 0.72 सेकंड रह गया था।
સેકન્ડ
घर के 7 अलग-अलग मिजाज (moods) तय किए गए हैं, जो गुस्से वाले से लेकर आनंदित मोड तक के हैं। प्रॉमप्ट टेम्पलेट में मौजूद इमोशन टैग्स के आधार पर मिग्पी TTS उपयुक्त 3 से 10 सेकंड के वॉयस सैंपल का उपयोग करता है। एनिमेशन सिस्टम में फ्रेम रेट लगातार बना रहे इसके लिए Audio2Face-3D बफरिंग के लिए 100 मिलिसेकंड का एडजस्टमेंट सेट किया गया था।
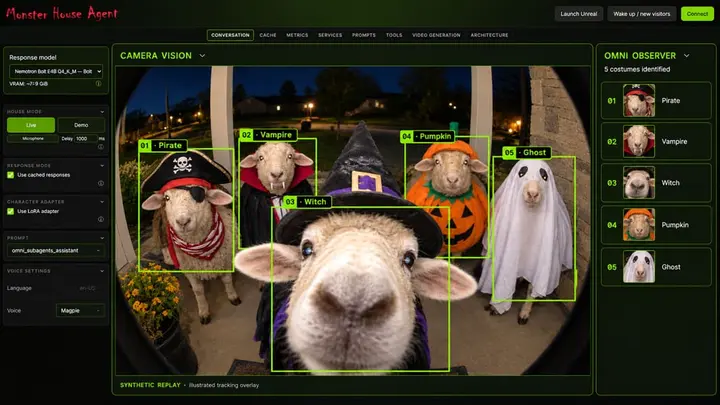
घर की विजन सिस्टम का परीक्षण करने के लिए, पांच अलग-अलग हैलोवीन कॉस्ट्यूम (पायरेट, वैम्पायर, चुड़ैल, कद्दू और भूत) पहने हुए भेड़ों का एक वीडियो Nemotron 3 Nano Omni मॉडल को दिया गया था। इस मॉडल ने प्रत्येक कॉस्ट्यूम की सटीक पहचान की। यह पहचान सटीक बनी रहे, इसके लिए लोगों की गिनती और ट्रैकिंग के लिए YOLO और ByteTrack मॉडल का अलग से उपयोग किया गया था।
हार्डवेयर और कंप्यूटिंग बजट
इस पूरी पाइपलाइन को बिना किसी क्लाउड सर्वर के ऑन-प्रिमाइसेस (on-premise) चलाने के लिए एक शक्तिशाली हार्डवेयर सेटअप तैयार किया गया था। कंप्यूटेशनल वर्कलोड को दो भागों में विभाजित किया गया था:
1. प्रथम प्रोसेसर: NVIDIA RTX PRO 6000 Blackwell Max-Q GPU पर भाषा मॉडल (Bolt E4B), स्पीच-टू-टेक्स्ट (ASR) और विजन मॉडल चलाए गए थे। 2. द्वितीय प्रोसेसर: NVIDIA RTX PRO 4000 Blackwell GPU पर Unreal Engine 5 के ग्राफिक्स और Audio2Face-3D का रियल-टाइम मोशन एनिमेशन रन किया गया था।
इस तरह कंप्यूटिंग पावर को विभाजित करने से, जब भाषा मॉडल प्रोसेसिंग कर रहा होता है, तब भी एनिमेशन के फ्रेम रेट में कोई कमी नहीं आती और अनुभव पूरी तरह से स्मूथ रहता है।
Hugging Face और NVIDIA का गठबंधन
यह प्रोजेक्ट Hugging Face के प्लेटफॉर्म पर रिलीज किया गया है। Hugging Face की स्थापना 2016 में क्लेमेंट डेलंग्यू (Clément Delangue), जूलियन चौमंड (Julien Chaumond) और थॉमस वुल्फ (Thomas Wolf) द्वारा न्यूयॉर्क सिटी में की गई थी। शुरुआत में किशोरों के लिए चैटबॉट बनाने वाली यह कंपनी आज मशीन लर्निंग मॉडल और डेटासेट के लिए दुनिया का सबसे बड़ा ओपन-सोर्स प्लेटफॉर्म बन गई है।
यहाँ यह उल्लेखनीय है कि सितंबर 2026 में NVIDIA ने Hugging Face को 12.93 अरब डॉलर ($12.93 billion) में खरीदने की घोषणा की थी। जनवरी 1993 में जेन्सन हुआंग (Jensen Huang), क्रिस मलाचोव्स्की (Chris Malachowsky) और कर्टिस प्रिम (Curtis Priem) द्वारा स्थापित NVIDIA आज 5 ट्रिलियन डॉलर से अधिक मार्केट कैप वाली दुनिया की अग्रणी AI चिप निर्माता है। NVIDIA ने स्पष्ट किया है कि इस अधिग्रहण के बाद भी Hugging Face एक ओपन प्लेटफॉर्म के रूप में ही कार्य करती रहेगी।
भारत और भविष्य के AI एजेंट्स के लिए इसके मायने
nemotron-halloween प्रोजेक्ट यह साबित करता है कि स्थानीय स्तर (edge computing) पर चलने वाले ओपन AI मॉडल अब क्लाउड सर्वर जितने ही सक्षम हो रहे हैं। भारत में जहाँ इंटरनेट कनेक्टिविटी और डेटा प्राइवेसी बड़े मुद्दे हैं, वहाँ स्थानीय वर्कस्टेशन या ऑन-डिवाइस पर चलने वाले इस प्रकार के एजेंट्स बहुत उपयोगी हो सकते हैं।
साथ ही, इसने शिक्षा, मनोरंजन, रोबोटिक्स और ग्राहक सेवा जैसे क्षेत्रों में स्थानीय भाषाओं में संवाद करने में सक्षम रियल-टाइम अवतार और 3D एनिमेटेड एजेंट बनाने का मार्ग प्रशस्त किया है। मॉन्स्टर हाउस केवल हैलोवीन का एक मनोरंजक प्रयोग नहीं है, बल्कि भौतिक और डिजिटल दुनिया के बीच AI संवाद की एक सशक्त झलक है।


