डार्क जीपीयू: एआई तेजी के बीच डेटासेंटरों में अप्रयुक्त पड़ी प्रोसेसिंग क्षमता का पहेलीनुमा सत्य
कृत्रिम बुद्धिमत्ता के मॉडल विकसित करने के लिए चिप्स की वैश्विक कमी है, फिर भी अरबों डॉलर के डेटासेंटरों में कई जीपीयू पूरी क्षमता से काम नहीं कर पा रहे हैं।
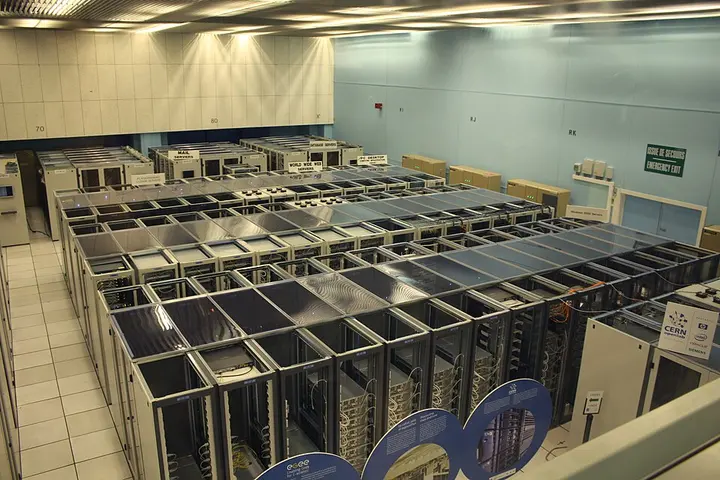
कृत्रिम बुद्धिमत्ता यानी आर्टिफिशियल इंटेलिजेंस (AI) के आधुनिक युग में सबसे मूल्यवान संपत्ति सिलिकॉन चिप्स हैं। दुनियाभर की प्रौद्योगिकी कंपनियां अत्याधुनिक जीपीयू हासिल करने के लिए अरबों डॉलर खर्च कर रही हैं, लेकिन इसके पीछे एक छुपी और गंभीर समस्या आकार ले रही है जिसे प्रौद्योगिकी विशेषज्ञ 'डार्क जीपीयू' (dark GPUs) के रूप में बता रहे हैं। Business Standard की रिपोर्ट के अनुसार, ग्राफिक्स प्रोसेसिंग यूनिट (GPU) एक विशिष्ट कंप्यूटर चिप है जिसे एक साथ कई जटिल गणनाएं करने के लिए विशेष रूप से डिज़ाइन किया गया है।
डार्क जीपीयू एक ऐसी स्थिति को दर्शाता है जहां डेटासेंटरों में लाखों डॉलर के अत्याधुनिक प्रोसेसर लगे होने के बावजूद, वे अपनी पूर्ण क्षमता से काम नहीं कर पाते हैं या अधिकांश समय निष्क्रिय (idle) अवस्था में पड़े रहते हैं। यह घटना केवल वित्तीय बर्बादी नहीं है, बल्कि वैश्विक स्तर पर एआई के विकास की गति को भी धीमा कर रही है। जब दुनिया में प्रोसेसिंग पावर की भारी कमी हो, तब सर्वर रैक में रखे हजारों प्रोसेसर पर्याप्त क्षमता के बिना पड़े रहें यह आज की कंप्यूटिंग दुनिया का सबसे बड़ा विरोधाभास है।
जीपीयू की रचना और एआई के लिए उसकी अनिवार्यता
कंप्यूटिंग के इतिहास पर नजर डालें तो सामान्य प्रोसेसर यानी सीपीयू (CPU - central processing unit) जटिल गणनाओं को क्रमानुसार करने के लिए बना है। इसके मुकाबले ग्राफिक्स प्रोसेसिंग यूनिट (GPU) का उद्भव १९९० के दशक में डिजिटल इमेज प्रोसेसिंग और कंप्यूटर ग्राफिक्स को तेज करने के लिए हुआ था। जीपीयू में सैकड़ों या हजारों छोटे कैलकुलेशन यूनिट्स होते हैं, जो समानांतर रूप से यानी पैरेलल प्रोसेसिंग (parallel processing) द्वारा भारी मात्रा में डेटा प्रोसेस करने की क्षमता रखते हैं।
विकिपीडिया के विवरण के अनुसार, २०१२ के बाद जब न्यूरल नेटवर्क्स को गति देने के लिए जीपीयू का उपयोग शुरू हुआ, तब डीप लर्निंग (deep learning) के क्षेत्र में असाधारण क्रांति आई। लार्जे लैंग्वेज मॉडल्स (LLM) और जनरेटिव एआई के लिए भारी मात्रा में लिनियर अलजेब्रा (linear algebra) यानी रैखिक बीजगणित की गणनाओं की आवश्यकता होती है। जीपीयू की रचना ऐसे समानांतर कार्यों के लिए स्वाभाविक रूप से अनुकूल होने के कारण यह सुपरकंप्यूटिंग और आर्टिफिशियल इंटेलिजेंस का अनिवार्य हृदय बन गया है।
સિસ્ટમ્સ
'डार्क जीपीयू' क्यों सर्जित होते हैं: क्षमता होने के बावजूद लाचारी
डार्क जीपीयू की समस्या कोई एक भौतिक खामी नहीं बल्कि पूरी प्रणाली की असंतुलित डिजाइन का परिणाम है। जब किसी सुपरकंप्यूटर या क्लाउड डेटासेंटर में सैकड़ों जीपीयू एक साथ जोड़कर विशाल मॉडल ट्रेन किए जाते हैं, तब प्रत्येक चिप का निरंतर कार्य करना आवश्यक होता है। लेकिन व्यवहार में कई बार जीपीयू की प्रोसेसिंग स्पीड बहुत अधिक होती है, जबकि उसे डेटा पहुँचाने वाली मेमोरी या नेटवर्क उतनी तेजी से काम नहीं कर पाते हैं।
इस स्थिति को मेमोरी बॉटनेक (memory bottleneck) कहा जाता है, जिसमें प्रोसेसर डेटा की प्रतीक्षा करने में कीमती मिलीसेकंड्स बर्बाद करता है। समर्पित यानी कि डेडिकेटेड जीपीयू अपनी खुद से जुड़ी विशिष्ट मेमोरी (VRAM) का उपयोग करते हैं, लेकिन जब जटिल मॉडल के पैरामीटर्स इस मेमोरी से बड़े हो जाते हैं तब सिस्टम का दम घुटने लगता है जिसे तकनीकी भाषा में चोकिंग (choking) कहते हैं। जब एक चिप डेटा की प्रतीक्षा कर रही होती है तब उससे जुड़े अन्य प्रोसेसर भी रुक जाते हैं, जिससे पूरे क्लस्टर की क्षमता घट जाती है।
- डेटा वितरण में विलंबविशाल मॉडल का डेटा मुख्य स्टोरेज से प्रोसेसर तक पहुँचने में मेमोरी बैंडविथ के कारण बाधा उत्पन्न होती है।
- मेमोरी सैचुरेशनप्रोसेसर की अपनी VRAM सीमित होने के कारण जटिल कैलकुलेशंस के दौरान डेटा ट्रांसफर चोक हो जाता है।
- सिंक्रोनाइजेशन अड़चनसमांतर जुड़े हजारों जीपीयू में से कुछ प्रोसेसर परिणाम की राह देखते हुए अन्य प्रोसेसर्स अटके रहते हैं।
- डार्क या आइडल स्टेटबिजली प्रयुक्त होने के बावजूद चिप अपनी सौ प्रतिशत क्षमता उपयोग किए बिना निष्क्रिय साइकिल चलाती है।
तकनीकी आंकड़े: मेमोरी बैंडविड्थ और सुपरकंप्यूटर्स का विश्लेषण
प्रोसेसिंग क्षमता मापने के लिए आमतौर पर फ्लॉप्स (FLOPS: floating point operations per second) का उपयोग किया जाता है, और आधुनिक चिप्स टेराफ्लॉप्स (TFLOPS) में गणना करती हैं। लेकिन केवल फ्लॉप्स से वास्तविक कार्यनिष्पादन तय नहीं होता है। सामान्य इंटीग्रेटेड जीपीयू सिस्टम मेमोरी के साथ अधिक से अधिक १२८ गीगाबाइट्स प्रति सेकंड (GB/s) की बैंडविड्थ रखते हैं, जबकि अत्याधुनिक डेडिकेटेड ग्राफिक्स कार्ड अपनी VRAM और कोर के बीच १००० गीगाबाइट्स प्रति सेकंड से अधिक बैंडविड्थ दे सकते हैं।
जून २०२६ की वैश्विक TOP500 सुपरकंप्यूटर सूची के अनुसार, दुनिया के २७६ अग्रणी सुपरकंप्यूटर एक्सीलरेटर या सह-प्रोसेसर तकनीक पर निर्भर हैं, जो पिछले छह महीनों के २५५ सिस्टम्स के आंकड़ों की तुलना में बड़ी वृद्धि को दर्शाता है। यह डेटा दर्शाता है कि १०७ सिस्टम्स NVIDIA Hopper चिप्स से लैस हैं, ६२ सिस्टम्स NVIDIA Ampere का उपयोग करते हैं और ३२ सिस्टम्स AMD Instinct आर्किटेक्चर पर आधारित हैं। यदि इतने विशाल ढांचे में जीपीयू का अधूरा उपयोग होता है, तो अरबों वॉट बिजली और करोड़ों डॉलर का नुकसान होता है।
| जीपीयू प्रकार | मेमोरी का प्रकार | अधिकतम बैंडविथ |
|---|---|---|
| इंटीग्रेटेड जीपीयू (IGPU) | शेर्ड सिस्टम रैम (RAM) | 128 GB/s तक |
| डेडीकेटेड जीपीयू (Discrete) | समर्पित वीडियो रैम (VRAM) | 1000 GB/s से अधिक |

ऊर्जा खपत, कूलिंग और बुनियादी ढांचे का संकट
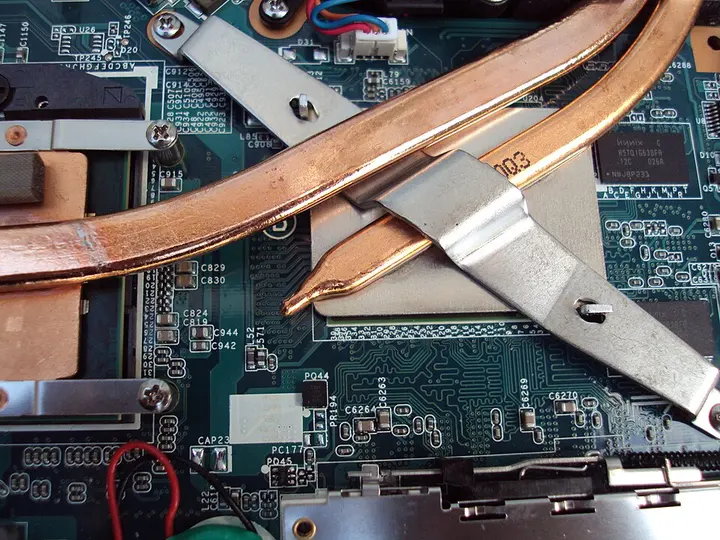
आधुनिक डेटासेंटर्स केवल सॉफ्टवेयर से नहीं चलते हैं, बल्कि उनके लिए भारी बिजली आपूर्ति और कूलिंग सिस्टम जरूरी बनते हैं। अत्याधुनिक एक्सीलरेटर चिप्स सैकड़ों वॉट पावर खींचती हैं और अत्यधिक गर्मी पैदा करती हैं। यदि डेटासेंटर के पास प्रत्येक रैक को पर्याप्त बिजली देने की क्षमता न हो या कूलिंग क्षमता सीमित हो, तो इंजीनियरों को कुछ चिप्स को बंद रखना पड़ता है या उनकी स्पीड घटानी पड़ती है।
इस स्थिति के कारण सिलिकॉन हार्डवेयर भौतिक रूप से मौजूद होने के बावजूद 'अंधेरे में' यानी अकुशल रहते हैं। इसके अलावा, बिजली आपूर्ति में बाधा न आए इसके लिए बड़े पैमाने पर औद्योगिक बैटरी बैंक और बैकअप सिस्टम्स लगाने पड़ते हैं। जब बुनियादी ढांचे की इन सीमाओं के कारण हार्डवेयर का औसत उपयोग घटकर चालीस या पचास प्रतिशत रह जाता है, तो निवेश पर मिलने वाला रिटर्न जोखिम में पड़ जाता है।
आम लोगों और भारत पर इस घटना का प्रभाव
डार्क जीपीयू की समस्या दूर के डेटासेंटर तक सीमित नहीं है, बल्कि इसका असर आखिर में ग्राहकों तक पहुंचता है। जब एआई इन्फ्रास्ट्रक्चर अकुशल बनता है, तो एआई सेवाएं देने का खर्च बढ़ जाता है, जिससे उपयोगकर्ताओं के लिए सब्सक्रिप्शन फीस ऊंची रहती है। भारत जैसे विकासशील देश के लिए, जहां स्थानीय एआई मॉडल और भाषा आधारित कंप्यूटिंग का विस्तार हो रहा है, उपलब्ध हर चिप का पूरा उपयोग बेहद महत्वपूर्ण है।
यदि भारतीय संस्थान और स्टार्टअप्स जीपीयू रिसोर्सिस की सही शेड्यूलिंग कर सकें और डार्क सिलिकॉन की कमियों को सॉफ्टवेयर ऑप्टिमाइजेशन द्वारा सुधार लें, तो सीमित हार्डवेयर में भी बेहतरीन परिणाम प्राप्त किए जा सकते हैं। भविष्य में केवल शक्तिशाली जीपीयू खरीदने से स्पर्धा नहीं जीती जा सकेगी, बल्कि उस हार्डवेयर के एक-एक ट्रांजिस्टर का कितना सटीक उपयोग होता है, इस पर पूरी एआई क्रांति का आधार रहेगा।


