આધુનિક આર્ટિફિશિયલ ઇન્ટેલિજન્સનું હૃદય: ટ્રાન્સફોર્મર આર્કિટેક્ચર અને લાર્જ લેંગ્વેજ મોડેલ્સ
માનવ ભાષાને સમજવા અને સર્જવા માટે ૨૦૧૭માં ગૂગલના સંશોધકોએ રજૂ કરેલી અટેન્શન ટેકનિકે સમગ્ર વિશ્વની ટેકનોલોજીને કેવી રીતે બદલી નાખી તેની ઊંડી છણાવટ.
આજે આપણે જે આર્ટિફિશિયલ ઇન્ટેલિજન્સ (AI) ક્રાંતિના સાક્ષી બની રહ્યા છીએ, તેની પાછળ કોઈ જાદુ નથી પરંતુ ગણિત અને કમ્પ્યુટર વિજ્ઞાનની એક અનોખી શોધ રહેલી છે. ChatGPT, Claude, Gemini કે DeepSeek જેવા અત્યાધુનિક ચેટબોટ્સ જે ટેકનોલોજી પર ચાલે છે તેને લાર્જ લેંગ્વેજ મોડેલ (Large Language Model - LLM) કહેવામાં આવે છે. આ મોડેલો માત્ર સવાલના જવાબો આપવા પૂરતા સીમિત નથી રહ્યા, પરંતુ કવિતા લખવા, કોડિંગ કરવા, લાંબા દસ્તાવેજોનો સારાંશ તૈયાર કરવા અને જટિલ તાર્કિક સમસ્યાઓ ઉકેલવા સુધી પહોંચી ગયા છે. આ સમગ્ર ક્રાંતિનો પાયો જૂન ૨૦૧૭માં ગૂગલના સંશોધકો દ્વારા પ્રકાશિત થયેલા એક સંશોધન પત્ર પર આધારિત છે.
લાર્જ લેંગ્વેજ મોડેલ એ મૂળભૂત રીતે કૃત્રિમ ન્યુરલ નેટવર્ક (artificial neural network) પર આધારિત સિસ્ટમ છે, જેને ઇન્ટરનેટ પર ઉપલબ્ધ અબજો-ખરબો શબ્દોના લખાણ પર તાલીમ આપવામાં આવે છે. ભાષાના આગલા સંભવિત શબ્દનું અનુમાન લગાવવાથી શરૂ થતી આ પ્રક્રિયા ક્રમશઃ માનવ જેવી ભાષાકીય સમજમાં રૂપાંતરિત થઈ જાય છે. વર્ષ ૨૦૨૨ના અંત ભાગમાં OpenAI દ્વારા ChatGPT રજૂ કરવામાં આવ્યું તે પછી આ ક્ષેત્રે અભૂતપૂર્વ ગતિ પકડી છે. આ તમામ મોડેલો જે ખાસ એન્જિન પર દોડે છે, તે આર્કિટેક્ચરનું નામ છે ટ્રાન્સફોર્મર (Transformer).
ભૂતકાળની મર્યાદાઓ અને અટેન્શનનો ઉદય
ટ્રાન્સફોર્મર પહેલાં ભાષા અનુવાદ અને પ્રક્રિયા માટે મુખ્યત્વે રિકરન્ટ ન્યુરલ નેટવર્ક્સ (RNN) અને લોંગ શોર્ટ-ટર્મ મેમરી (LSTM) મોડેલોનો ઉપયોગ થતો હતો. વર્ષ ૧૯૯૭માં લોકપ્રિય બનેલા LSTM મોડેલો શબ્દોને એક પછી એક ક્રમમાં વાંચતા હતા. આ પદ્ધતિમાં એક મોટી મર્યાદા હતી કે જો વાક્ય ખૂબ લાંબું હોય, તો વાક્યના અંત સુધી પહોંચતા મોડેલ શરૂઆતના શબ્દો ભૂલી જતું હતું. કમ્પ્યુટર વિજ્ઞાનમાં તેને વેનિશિંગ ગ્રેડિયન્ટ (vanishing gradient) ની સમસ્યા કહેવામાં આવે છે, જેમાં લાંબા સંદર્ભોની માહિતી આગળ વહન થઈ શકતી નથી.
આ સમસ્યાને ઉકેલવા માટે વર્ષ ૨૦૧૪માં બહદાનૌ અને અન્ય સંશોધકોએ ‘અટેન્શન મિકેનિઝમ’ (attention mechanism) એટલે કે ધ્યાનાકર્ષણ પદ્ધતિની શરૂઆત કરી હતી. ત્યારબાદ વર્ષ ૨૦૧૬માં ગૂગલે પોતાની અનુવાદ સેવામાં આઠ-સ્તરીય બાયડિરેક્શનલ LSTM આધારિત ન્યુરલ મશીન ટ્રાન્સલેશન લાગુ કર્યું. પરંતુ જૂની સિસ્ટમ્સમાં સૌથી મોટો અવરોધ એ હતો કે શબ્દો ક્રમશઃ પ્રોસેસ થતા હોવાથી તેમને આધુનિક ગ્રાફિક્સ પ્રોસેસિંગ યુનિટ (GPU) પર સમાંતર રીતે (in parallel) તાલીમ આપી શકાતી નહોતી.
'અટેન્શન ઈઝ ઓલ યુ નીડ' અને નવો યુગ
વર્ષ ૨૦૧૭માં યોજાયેલી NeurIPS પરિષદમાં ગૂગલના જેકોબ ઉસ્કોરાઈટ અને તેમના સાથીઓએ ‘Attention Is All You Need’ શીર્ષક હેઠળ ૧૦ કરોડ (૧૦૦M) પેરામીટર ધરાવતું મૂળ ટ્રાન્સફોર્મર મોડેલ રજૂ કર્યું. આ સંશોધનનો મુખ્ય વિચાર એ હતો કે વાક્યના શબ્દોને એક પછી એક ક્રમમાં વાંચવાની કોઈ જરૂર નથી. જો તમામ શબ્દોને એકસાથે મૂકીને તેમની વચ્ચેનો પરસ્પર સંબંધ માપવામાં આવે, તો ભાષાકીય પ્રક્રિયા અત્યંત ઝડપી અને સચોટ બની શકે છે. આ વિચાર તે સમયે પરંપરાગત માન્યતાઓથી એટલો વિપરીત હતો કે ભાષાવિજ્ઞાનીઓ પણ શરૂઆતમાં તેનાથી આશ્ચર્યચકિત થઈ ગયા હતા.
- ૧. ટોકનાઇઝેશન (Tokenization)મૂળ લખાણને નાના શબ્દ-ટુકડાઓમાં વિભાજિત કરી દરેક ટુકડાને અનન્ય આંકડાકીય ઓળખ આપવામાં આવે છે.
- ૨. પોઝિશનલ એન્કોડિંગ (Positional Encoding)શબ્દો ક્રમશઃ પ્રોસેસ ન થતા હોવાથી તેમાં વાક્યમાં તેમના સ્થાનની ગાણિતિક માહિતી ઉમેરવામાં આવે છે.
- ૩. મલ્ટી-હેડ સેલ્ફ-અટેન્શન (Multi-Head Attention)વાક્યના તમામ શબ્દો વચ્ચેના પરસ્પર સંબંધો અને વ્યાકરણિક સંદર્ભને સમાંતર રીતે માપવામાં આવે છે.
- ૪. ફીડ-ફોરવર્ડ અને નોર્મલાઇઝેશનદરેક સ્તર પછી ડેટાનું સામાન્યીકરણ કરી ગાણિતિક ન્યુરલ નેટવર્ક દ્વારા માહિતીને વધુ સંક્ષિપ્ત બનાવાય છે.
- ૫. આઉટપુટ જનરેશનસંભાવના વિતરણ (probability distribution) આધારે આગલા સૌથી સુસંગત શબ્દની પસંદગી કરવામાં આવે છે.
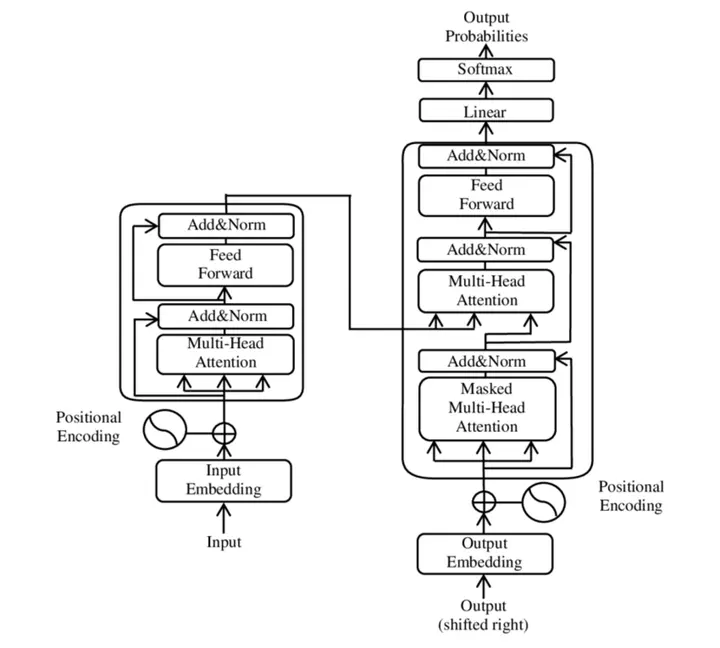
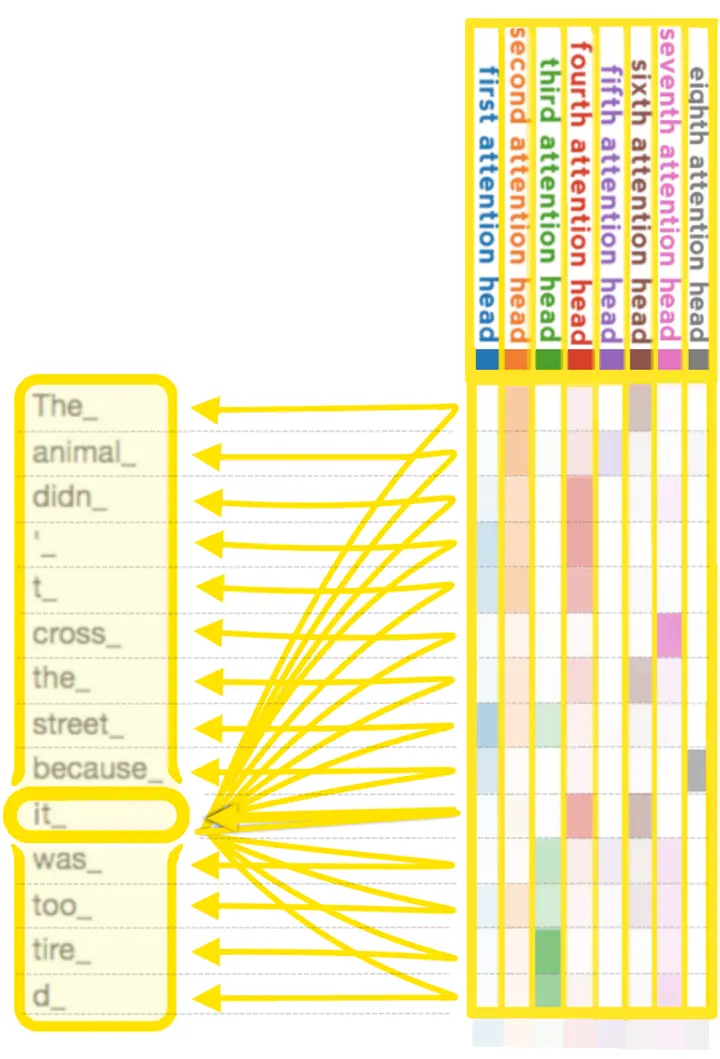
ટ્રાન્સફોર્મર મોડેલની સૌથી મોટી વિશેષતા એ છે કે તે વાક્યના પ્રત્યેક શબ્દને અન્ય તમામ શબ્દો સાથે સરખાવે છે. ઉદાહરણ તરીકે, જો વાક્ય હોય કે ‘બેંકે નદીના કાંઠે નાણાં ધીરવાની નવી શાખા ખોલી’, તો મોડેલ સમજી શકે છે કે અહીં ‘બેંક’ શબ્દનો સંબંધ ‘નદીના કાંઠા’ સાથે નથી પણ ‘નાણાં ધીરવા’ અને ‘શાખા’ સાથે છે. આ મિકેનિઝમને સેલ્ફ-અટેન્શન (self-attention) કહેવામાં આવે છે, જે સંદર્ભ મુજબ શબ્દનો ચોક્કસ અર્થ તારવી આપે છે.
ટ્રાન્સફોર્મર કેવી રીતે કામ કરે છે: તબક્કાવાર વિશ્લેષણ
કોઈપણ લખાણને સમજવા માટે ટ્રાન્સફોર્મર સૌપ્રથમ ટોકનાઇઝેશન (tokenization) કરે છે, જેમાં લખાણને નાના ટુકડાઓમાં વિભાજિત કરવામાં આવે છે જેને ટોકન (token) કહેવાય છે. સામાન્ય રીતે એક ટોકન એટલે લગભગ ત્રણથી ચાર અક્ષરો અથવા અડધો શબ્દ. Byte-Pair Encoding (BPE) અને WordPiece જેવી પદ્ધતિઓ દ્વારા શબ્દોને પૂર્ણાંક આંકડાઓમાં ફેરવવામાં આવે છે. કારણ કે ન્યુરલ નેટવર્ક શબ્દો નહીં પરંતુ માત્ર આંકડાઓ જ સમજી શકે છે.
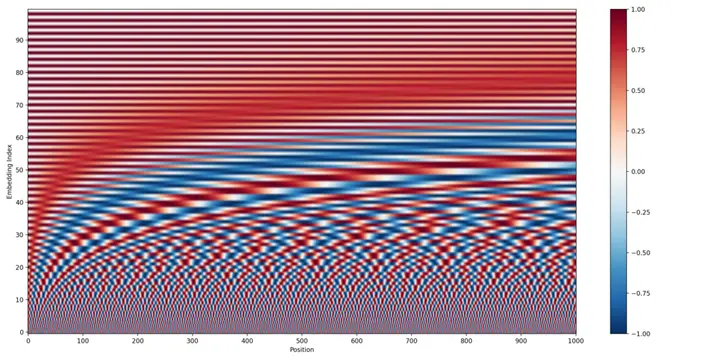
બધા શબ્દો એકસાથે અંદર આવતા હોવાથી મોડેલને ક્રમની ખબર રહેતી નથી, તેથી તેમાં પોઝિશનલ એન્કોડિંગ (positional encoding) ઉમેરવામાં આવે છે. આ ગાણિતિક તરંગો જેવી પદ્ધતિ છે જે દરેક ટોકનને વાક્યમાં તેનું ચોક્કસ સ્થાન દર્શાવતો એક અનોખો સદિશ (vector) આપે છે. આ પછી મલ્ટી-હેડ અટેન્શન (multi-head attention) નું સ્તર આવે છે, જ્યાં વાક્યના વિવિધ વ્યાકરણ અને અર્થ સંબંધોને જુદા જુદા ‘હેડ’ દ્વારા સ્વતંત્ર રીતે તપાસવામાં આવે છે.
એન્કોડર, ડીકોડર અને મોડેલ પરિવારો
મૂળ ટ્રાન્સફોર્મરમાં બે ભાગ હતા: ઇનપુટનું વિશ્લેષણ કરનાર એન્કોડર (encoder) અને નવું લખાણ ઉત્પન્ન કરનાર ડીકોડર (decoder). પરંતુ બાદમાં સંશોધકોએ આ માળખાને બે અલગ દિશામાં વિકસાવ્યું. વર્ષ ૨૦૧૮માં ગૂગલે BERT રજૂ કર્યું, જે માત્ર એન્કોડર-આધારિત (encoder-only) મોડેલ હતું અને શોધ એન્જિનમાં લખાણ સમજવા માટે વપરાયું. બીજી તરફ OpenAI એ GPT શ્રેણી બનાવી, જે માત્ર ડીકોડર-આધારિત (decoder-only) મોડેલ છે અને નવું લખાણ સર્જવામાં અજોડ સાબિત થઈ.
વર્ષ ૨૦૧૯માં ૧.૫ અબજ પેરામીટર ધરાવતું GPT-2 આવ્યું, જેને OpenAI એ દુરુપયોગના ડરથી શરૂઆતમાં જાહેર નહોતું કર્યું. ૨૦૨૦માં GPT-3 આવ્યું, જેમાં ૧૭૫ અબજ પેરામીટર હતા. વર્ષ ૨૦૨૩માં આવેલા GPT-4 એ મલ્ટીમોડલ ક્ષમતાઓ દર્શાવી, એટલે કે તે લખાણ ઉપરાંત ચિત્રો પણ સમજી શકતું હતું. વર્ષ ૨૦૨૪માં OpenAI એ o1 નામનું મોડેલ બહાર પાડ્યું, જે અંતિમ જવાબ આપતા પહેલા લાંબી તાર્કિક વિચારશૃંખલા (chain of thought) ચલાવે છે.
ઓપન-સોર્સ ક્રાંતિ અને કમ્પ્યુટેશનનો વિરાટ ખર્ચ
શરૂઆતમાં બંધ મોડેલોનું પ્રભુત્વ હતું, પરંતુ ૨૦૨૨ પછી ઓપન-વેઇટ મોડેલોનું મોજું આવ્યું. Meta ના LLaMA અને Mistral AI ના મોડેલોએ સંશોધકોને પોતાના કમ્પ્યુટર પર મોડેલ ચલાવવાની સ્વતંત્રતા આપી. જાન્યુઆરી ૨૦૨૫માં ચીનની કંપનીએ DeepSeek R1 નામનું ૬૭૧ અબજ પેરામીટર ધરાવતું મોડેલ જાહેર કર્યું, જેણે અતિશય ઓછા ખર્ચે OpenAI o1 જેટલું જ ઊંચું પરિણામ આપીને આખી ટેક દુનિયાને હચમચાવી દીધી.
આવા વિશાળ મોડેલોને તાલીમ આપવાનો ખર્ચ આસમાને પહોંચ્યો છે. વર્ષ ૨૦૧૯માં GPT-2 ની તાલીમ પાછળ લગભગ $૫૦,૦૦૦ નો ખર્ચ થયો હતો, જ્યારે આજના અત્યાધુનિક મોડેલોની તાલીમ લાખો ડોલર અને હજારો અદ્યતન GPU ક્લસ્ટર્સની માંગ કરે છે. મોડેલોને તાલીમ આપવા માટે ડેટા પેરેલલિઝમ (data parallelism) અને ટેન્સર પેરેલલિઝમ (tensor parallelism) જેવી સંકુલ કમ્પ્યુટિંગ પદ્ધતિઓનો ઉપયોગ કરવામાં આવે છે.
ભવિષ્યની દિશા અને ખુલ્લા સવાલો
લાર્જ લેંગ્વેજ મોડેલો જેટલા સક્ષમ છે તેટલા જ પડકારો પણ ધરાવે છે. ઘણી વખત આ મોડેલો આત્મવિશ્વાસપૂર્વક ખોટી માહિતી રજૂ કરે છે, જેને હેલ્યુસિનેશન (hallucination) કહેવામાં આવે છે. તાલીમ ડેટામાં રહેલા પૂર્વગ્રહો પણ મોડેલના આઉટપુટમાં ઝળકે છે. આ ઉપરાંત, ઇન્ટરનેટ પર કુદરતી માનવ લખાણ ખૂટી રહ્યું હોવાથી હવે સિન્થેટિક ડેટા (synthetic data) એટલે કે AI દ્વારા જ સર્જાયેલા ડેટાનો ઉપયોગ કરીને નવા મોડેલો તાલીમબદ્ધ કરવામાં આવી રહ્યા છે.
ગુજરાતી અને ભારતની અન્ય પ્રાદેશિક ભાષાઓ માટે આ ટેકનોલોજી એક સુવર્ણ તક લઈને આવી છે. યોગ્ય પ્રી-ટ્રેનિંગ અને ફાઈન-ટ્યુનિંગ દ્વારા આપણી ભાષાઓમાં સરકારી સેવાઓ, શિક્ષણ અને કૃષિ ક્ષેત્રે ક્રાંતિકારી સહાયકો બનાવી શકાય છે. ટ્રાન્સફોર્મર આર્કિટેક્ચરે સાબિત કર્યું છે કે જ્યારે સાચું માળખું અને વિરાટ ગણતરી શક્તિ એકત્ર થાય છે, ત્યારે માનવ બુદ્ધિના સૌથી જટિલ પાસા સમાન ‘ભાષા’ પણ મશીનના નિયંત્રણમાં આવી શકે છે.


