आधुनिक आर्टिफिशियल इंटेलिजेंस का हृदय: ट्रांसफॉर्मर आर्किटेक्चर और लार्ज लैंग्वेज मॉडल्स
मानव भाषा को समझने और रचने के लिए २०१७ में गूगल के शोधकर्ताओं द्वारा प्रस्तुत अटेंशन तकनीक ने पूरी दुनिया की तकनीक को कैसे बदल डाला, इसकी गहरी छानबीन।
आज हम जिस आर्टिफिशियल इंटेलिजेंस (AI) क्रांति के गवाह बन रहे हैं, उसके पीछे कोई जादू नहीं बल्कि गणित और कंप्यूटर विज्ञान की एक अनूठी खोज छिपी है। ChatGPT, Claude, Gemini या DeepSeek जैसे अत्याधुनिक चैटबॉट जिस तकनीक पर चलते हैं, उसे लार्ज लैंग्वेज Model (Large Language Model - LLM) कहा जाता है। ये मॉडल केवल सवाल के जवाब देने तक सीमित नहीं रहे हैं, बल्कि कविता लिखने, कोडिंग करने, लंबे दस्तावेज़ों का सारांश तैयार करने और जटिल तार्किक समस्याओं को हल करने तक पहुँच गए हैं। इस पूरी क्रांति की नींव जून २०१७ में गूगल के शोधकर्ताओं द्वारा प्रकाशित एक शोध पत्र पर आधारित है।
लार्ज लैंग्वेज मॉडल मूल रूप से कृत्रिम न्यूरल नेटवर्क (artificial neural network) पर आधारित सिस्टम है, जिसे इंटरनेट पर उपलब्ध अरबों-खरबों शब्दों के पाठ पर प्रशिक्षित किया जाता है। भाषा के अगले संभावित शब्द का अनुमान लगाने से शुरू होने वाली यह प्रक्रिया क्रमशः मानव जैसी भाषाई समझ में रूपांतरित हो जाती है। वर्ष २०२२ के उत्तरार्ध में OpenAI द्वारा ChatGPT प्रस्तुत किए जाने के बाद इस क्षेत्र में अभूतपूर्व गति पकड़ी है। ये सभी मॉडल जिस विशेष इंजन पर दौड़ते हैं, उस आर्किटेक्चर का नाम ट्रांसफॉर्मर (Transformer) है। ## अतीत की सीमाएँ और अटेंशन का उदय
ट्रांसफॉर्मर से पहले भाषा अनुवाद और प्रोसेसिंग के लिए मुख्य रूप से रिकरेंट न्यूरल नेटवर्क्स (RNN) और लॉन्ग शॉर्ट-टर्म मेमोरी (LSTM) मॉडल का उपयोग किया जाता था। वर्ष १९९७ में लोकप्रिय हुए LSTM मॉडल शब्दों को एक के बाद एक क्रम में पढ़ते थे। इस पद्धति में एक बड़ी सीमा यह थी कि यदि वाक्य बहुत लंबा हो, तो वाक्य के अंत तक पहुँचते-पहुँचते मॉडल शुरुआती शब्दों को भूल जाता था। कंप्यूटर विज्ञान में इसे वैनिशिंग ग्रेडिएंट (vanishing gradient) की समस्या कहा जाता है, जिसमें लंबे संदर्भों की जानकारी आगे प्रसारित नहीं हो पाती है।
इस समस्या को हल करने के लिए वर्ष २०१४ में बदानौ और अन्य शोधकर्ताओं ने ‘अटेंशन मैकेनिज्म’ (attention mechanism) यानी ध्यानाकर्षण पद्धति की शुरुआत की थी। इसके बाद वर्ष २०१६ में गूगल ने अपनी अनुवाद सेवा में आठ-स्तरीय बाइडायरेक्शनल LSTM आधारित न्यूरल मशीन ट्रांसलेशन लागू किया। लेकिन पुरानी प्रणालियों में सबसे बड़ा अवरोध यह था कि शब्दों को क्रमिक रूप से प्रोसेस किए जाने के कारण उन्हें आधुनिक ग्राफिक्स प्रोसेसिंग यूनिट (GPU) पर समानांतर रूप से (in parallel) प्रशिक्षित नहीं किया जा सकता था। ## 'अटेंशन इज़ ऑल यू नीड' और नया युग
वर्ष २०१७ में आयोजित NeurIPS कॉन्फ्रेंस में गूगल के जैकोब उसुकोराइट और उनके साथियों ने ‘Attention Is All You Need’ शीर्षक के तहत १० करोड़ (100M) पैरामीटर वाला मूल ट्रांसफॉर्मर मॉडल प्रस्तुत किया। इस शोध का मुख्य विचार यह था कि वाक्य के शब्दों को एक के बाद एक क्रम में पढ़ने की कोई आवश्यकता नहीं है। यदि सभी शब्दों को एक साथ रखकर उनके बीच के पारस्परिक संबंध को मापा जाए, तो भाषाई प्रक्रिया अत्यंत तीव्र और सटीक हो सकती है। यह विचार उस समय पारंपरिक मान्यताओं से इतना विपरीत था कि भाषाविद् भी शुरुआत में इससे चकित रह गए थे।
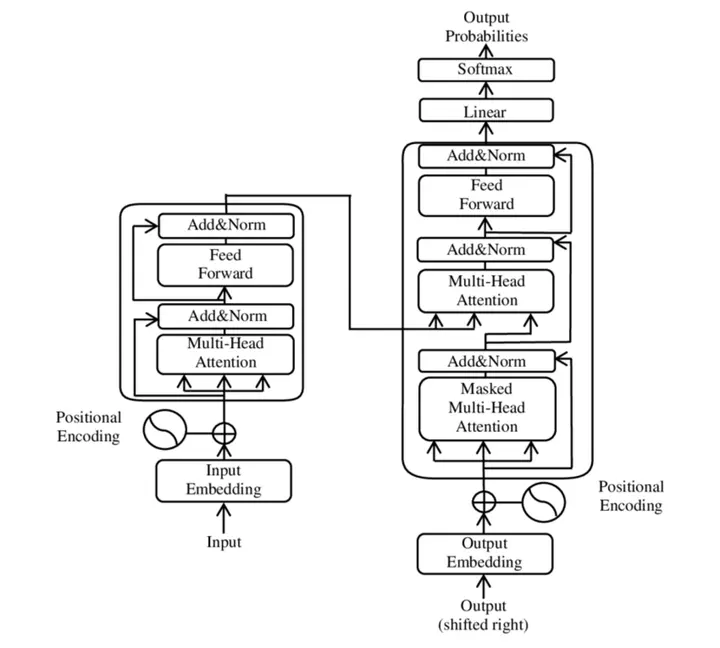
- १. टोकेनाइजेशन (Tokenization)मूल पाठ को छोटे शब्द-टुकड़ों में विभाजित कर प्रत्येक टुकड़े को अनन्य सांख्यिकीय पहचान दी जाती है।
- २. पॉजिशनल एनकोडिंग (Positional Encoding)शब्दों को क्रमिक रूप से प्रोसेस न किए जाने के कारण उनमें वाक्य में उनके स्थान की गणितीय जानकारी जोड़ी जाती है।
- ३. मल्टी-हेड सेल्फ-अटेंशन (Multi-Head Attention)वाक्य के सभी शब्दों के बीच के पारस्परिक संबंधों और व्याकरणिक संदर्भ को समानांतर रूप से मापा जाता है।
- ४. फीड-फॉर्वाड और नॉर्मलाइजेशनप्रत्येक स्तर के बाद डेटा का सामान्यीकरण कर गणितीय न्यूरल नेटवर्क द्वारा जानकारी को अधिक संक्षिप्त बनाया जाता है।
- ५. आउटपुट जनरेशनसंभाव्यता वितरण (probability distribution) के आधार पर अगले सबसे सुसंगत शब्द का चयन किया जाता है।
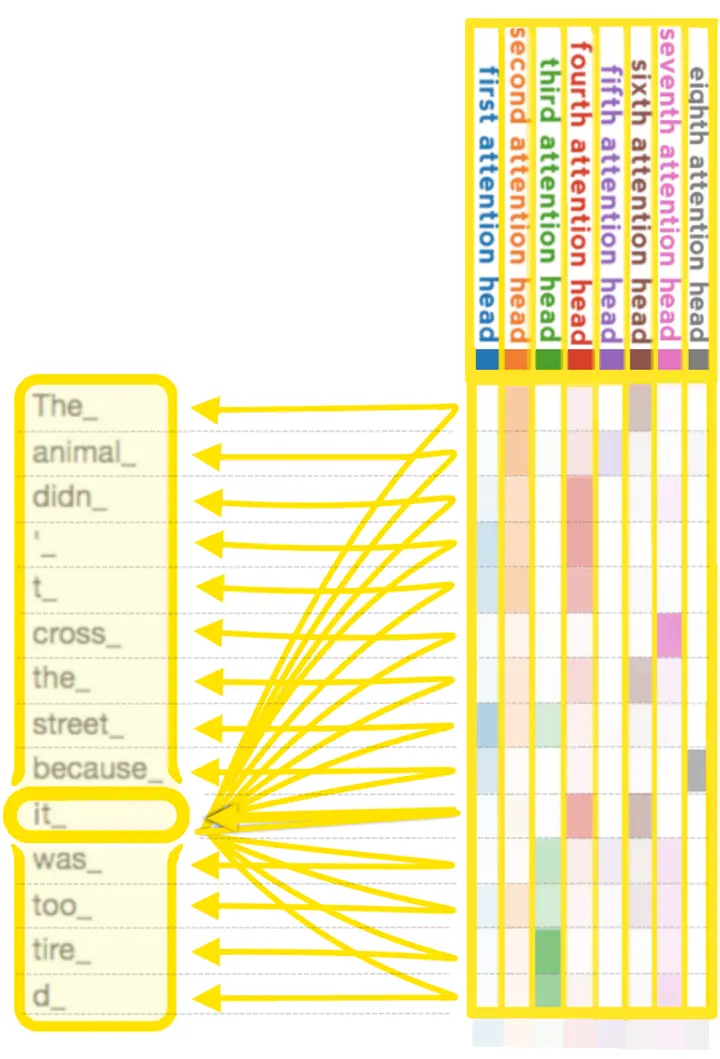
ट्रांसफॉर्मर मॉडल की सबसे बड़ी विशेषता यह है कि यह वाक्य के प्रत्येक शब्द की तुलना अन्य सभी शब्दों से करता है। उदाहरण के लिए, यदि वाक्य हो कि ‘बैंक ने नदी के किनारे पैसे उधार देने की नई शाखा खोली’, तो मॉडल समझ सकता है कि यहाँ ‘बैंक’ शब्द का संबंध ‘नदी के किनारे’ से नहीं बल्कि ‘पैसे उधार देने’ और ‘शाखा’ से है। इस मैकेनिज्म को सेल्फ-अटेंशन (self-attention) कहा जाता है, जो संदर्भ के अनुसार शब्द का सटीक अर्थ निकाल कर देता है।
ट्रांसफॉर्मर कैसे काम करता है: चरणबद्ध विश्लेषण
किसी भी पाठ को समझने के लिए ट्रांसफॉर्मर सबसे पहले टोकेनाइजेशन (tokenization) करता है, जिसमें पाठ को छोटे टुकड़ों में विभाजित किया जाता है जिन्हें टोकन (token) कहा जाता है। सामान्यतः एक टोकन यानी लगभग तीन से चार अक्षर या आधा शब्द। Byte-Pair Encoding (BPE) और WordPiece जैसी पद्धतियों द्वारा शब्दों को पूर्णांक अंकों में बदला जाता है। क्योंकि न्यूरल नेटवर्क शब्दों को नहीं बल्कि केवल अंकों को ही समझ सकते हैं।
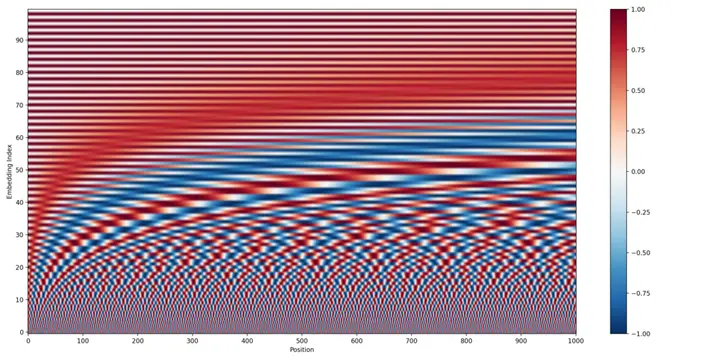
सभी शब्दों के एक साथ अंदर आने के कारण मॉडल को क्रम का पता नहीं रहता है, इसलिए इसमें पॉजिशनल एनकोडिंग (positional encoding) जोड़ी जाती है। यह गणितीय तरंगों जैसी पद्धति है जो प्रत्येक टोकन को वाक्य में उसका सटीक स्थान दर्शाने वाला एक अनूठा सदिश (vector) देती है। इसके बाद मल्टी-हेड अटेंशन (multi-head attention) का स्तर आता है, जहाँ वाक्य के विभिन्न व्याकरण और अर्थ संबंधों को अलग-अलग ‘हेड’ द्वारा स्वतंत्र रूप से परखा जाता है। ## एनकोडर, डिकोडर और मॉडल परिवार
मूल ट्रांसफॉर्मर में दो भाग थे: इनपुट का विश्लेषण करने वाला एनकोडर (encoder) और नया पाठ उत्पन्न करने वाला डिकोडर (decoder)। लेकिन बाद में शोधकर्ताओं ने इस ढाँचे को दो अलग दिशाओं में विकसित किया। वर्ष २०१८ में गूगल ने BERT प्रस्तुत किया, जो केवल एनकोडर-आधारित (encoder-only) मॉडल था और सर्च इंजन में पाठ को समझने के लिए उपयोग हुआ। दूसरी ओर, OpenAI ने GPT श्रृंखला बनाई, जो केवल डिकोडर-आधारित (decoder-only) मॉडल है और नया पाठ रचने में अद्वितीय साबित हुई।
वर्ष २०१९ में १.५ अरब पैरामीटर वाला GPT-2 आया, जिसे OpenAI ने दुरुपयोग के डर से शुरुआत में सार्वजनिक नहीं किया था। २०२० में GPT-3 आया, जिसमें १७५ अरब पैरामीटर थे। वर्ष २०२३ में आए GPT-4 ने मल्टीमॉडल क्षमताएँ प्रदर्शित कीं, यानी वह पाठ के अलावा चित्रों को भी समझ सकता था। वर्ष २०२४ में OpenAI ने o1 नामक मॉडल जारी किया, जो अंतिम उत्तर देने से पहले लंबी तार्किक विचार-शृंखला (chain of thought) चलाता है। ## ओपन-सोर्स क्रांति और कंप्यूटेशन का विराट खर्च
शुरुआत में बंद मॉडलों का वर्चस्व था, लेकिन २०२२ के बाद ओपन-वेट मॉडलों की लहर आई। Meta के LLaMA और Mistral AI के मॉडलों ने शोधकर्ताओं को अपने कंप्यूटर पर मॉडल चलाने की स्वतंत्रता दी। जनवरी २०२५ में चीन की एक कंपनी ने DeepSeek R1 नामक ६७१ अरब पैरामीटर वाला मॉडल जारी किया, जिसने अत्यधिक कम लागत पर OpenAI o1 जितना ही उच्च परिणाम देकर पूरी तकनीकी दुनिया को हिलाकर रख दिया।
ऐसे विशाल मॉडलों को प्रशिक्षित करने का खर्च आसमान छू रहा है। वर्ष २०१९ में GPT-2 के प्रशिक्षण के पीछे लगभग $50,000 का खर्च आया था, जबकि आज के अत्याधुनिक मॉडलों का प्रशिक्षण लाखों डॉलर और हज़ारों उन्नत GPU क्लस्टर की माँग करता है। मॉडलों को प्रशिक्षित करने के लिए डेटा पैरेललिज्म (data parallelism) और टेंसर पैरेललिज्म (tensor parallelism) जैसी जटिल कंप्यूटिंग पद्धतियों का उपयोग किया जाता है। ## भविष्य की दिशा और खुले सवाल
लार्ज लैंग्वेज मॉडल जितने सक्षम हैं, उतने ही चुनौतियाँ भी रखते हैं। कई बार ये मॉडल आत्मविश्वास के साथ गलत जानकारी प्रस्तुत करते हैं, जिसे हेलुसिनेशन (hallucination) कहा जाता है। प्रशिक्षण डेटा में मौजूद पूर्वाग्रह भी मॉडल के आउटपुट में झलकते हैं। इसके अलावा, इंटरनेट पर प्राकृतिक मानव पाठ समाप्त हो रहा है, इसलिए अब सिंथेटिक डेटा (synthetic data) यानी AI द्वारा ही रचे गए डेटा का उपयोग करके नए मॉडल प्रशिक्षित किए जा रहे हैं।
गुजराती और भारत की अन्य क्षेत्रीय भाषाओं के लिए यह तकनीक एक स्वर्णिम अवसर लेकर आई है। उचित प्री-ट्रेनिंग और फाइन-ट्यूनिंग के माध्यम से हमारी भाषाओं में सरकारी सेवाओं, शिक्षा और कृषि क्षेत्र में क्रांतिकारी सहायक बनाए जा सकते हैं। ट्रांसफॉर्मर आर्किटेक्चर ने साबित कर दिया है कि जब सही ढाँचा और विराट गणना शक्ति एक साथ मिलती है, तब मानव बुद्धि के सबसे जटिल पहलू समान ‘भाषा’ भी मशीन के नियंत्रण में आ सकती है।


