StateBench: શું AI લાંબા લખાણમાં માહિતીના ફેરફારોને યાદ રાખી શકે છે? એક નવું પરીક્ષણ
આર્ટિફિશિયલ ઇન્ટેલિજન્સ મોડલ્સની લાંબા દસ્તાવેજોમાં માહિતીના બદલાતા પ્રવાહને સમજવાની ક્ષમતા ચકાસવા માટે 'StateBench' નામનું નવું પરીક્ષણ માળખું રજૂ કરવામાં આવ્યું છે.
આજના સમયમાં આર્ટિફિશિયલ ઇન્ટેલિજન્સ (AI) અને ખાસ કરીને લાર્જ લેંગ્વેજ મોડલ્સ (LLMs) આપણી કામ કરવાની પદ્ધતિ બદલી રહ્યા છે. આ મોડલ્સ હજારો પાનાના દસ્તાવેજો વાંચી શકે છે અને તેમાંથી સારાંશ પણ આપી શકે છે. પરંતુ શું આ મોડલ્સ ખરેખર સમજે છે કે લાંબા લખાણ દરમિયાન માહિતીમાં કેવા ફેરફારો થઈ રહ્યા છે? આ પ્રશ્નનો જવાબ મેળવવા માટે એલન ઇન્સ્ટિટ્યૂટ ફોર AI (Ai2) ના સંશોધકોએ 'StateBench' નામનું એક નવું બેન્ચમાર્ક (benchmark): પરીક્ષણ માટેનું માપદંડ, રજૂ કર્યું છે. આ બેન્ચમાર્ક ખાસ કરીને 'સ્ટેટ ટ્રેકિંગ' (state tracking) એટલે કે માહિતીમાં થતા ક્રમિક ફેરફારો પર નજર રાખવાની મોડલની ક્ષમતાને માપે છે.
સ્ટેટ ટ્રેકિંગ એ કોઈ પણ બૌદ્ધિક કાર્યનો પાયો છે. ધારો કે તમે એક રહસ્યમય નવલકથા વાંચી રહ્યા છો. વાર્તાની શરૂઆતમાં જ્હોન પાસે એક ચપ્પુ છે. થોડા પ્રકરણો પછી જ્હોન તે ચપ્પુ મેરીને આપે છે અને મેરી તે એડવર્ડને આપે છે. જો છેલ્લે કોઈ ખૂન થાય, તો વાચક તરીકે તમારે યાદ રાખવું પડે કે અત્યારે ચપ્પુ કોની પાસે છે. આ જ બાબત પ્રોગ્રામિંગ કોડ વાંચતી વખતે પણ લાગુ પડે છે, જ્યાં વેરિએબલ (variable): કિંમત સંગ્રહવા માટેનું નામ, ની કિંમતો સતત બદલાતી રહે છે. જો AI મોડલ આ ફેરફારોને સચોટ રીતે ટ્રેક ન કરી શકે, તો તે લાંબા અને જટિલ કાર્યોમાં નિષ્ફળ જઈ શકે છે.
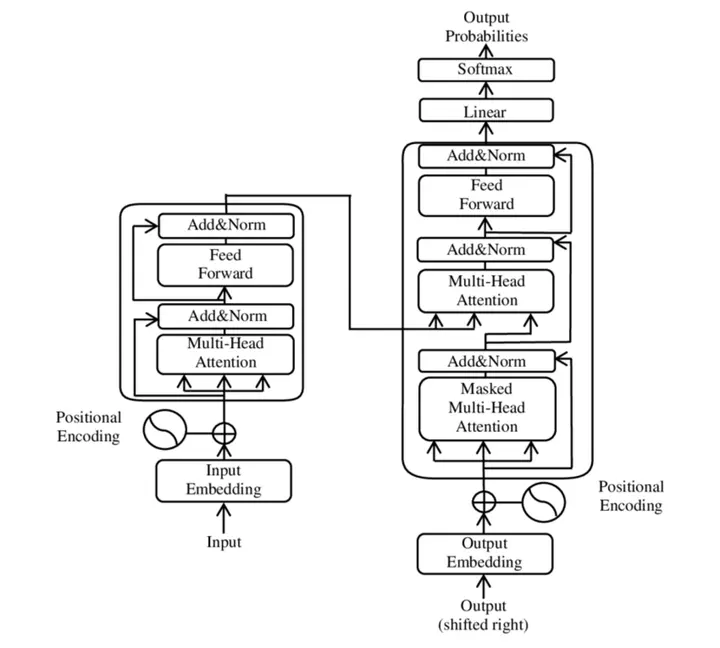
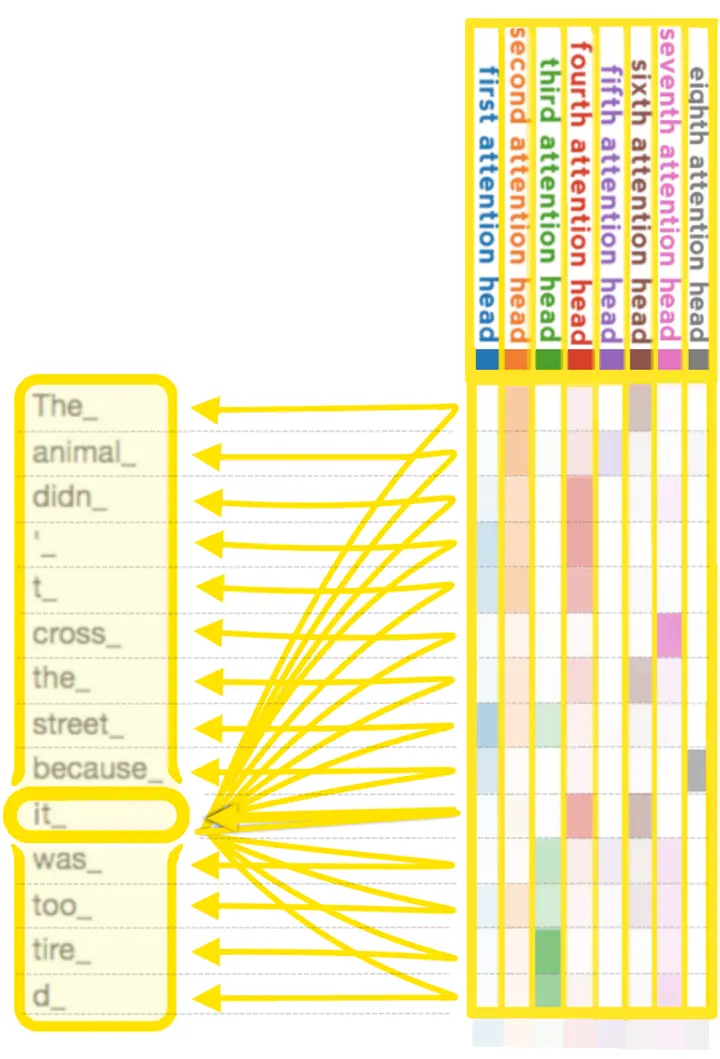
હાલના મોટાભાગના AI મોડલ્સ 'ટ્રાન્સફોર્મર' (transformer) આર્કિટેક્ચર પર આધારિત છે. ટ્રાન્સફોર્મર એ એક પ્રકારનું ન્યુરલ નેટવર્ક છે જે લખાણના જુદા જુદા ભાગો વચ્ચેના સંબંધોને સમજવા માટે 'એટેન્શન મિકેનિઝમ'નો ઉપયોગ કરે છે. જોકે, સંશોધકોએ નોંધ્યું છે કે ટ્રાન્સફોર્મર મોડલ્સની લાંબા લખાણમાં સ્ટેટ ટ્રેકિંગ કરવાની ક્ષમતામાં કેટલીક સૈદ્ધાંતિક મર્યાદાઓ છે. ખાસ કરીને જ્યારે માહિતીના ફેરફારોની સાંકળ બહુ લાંબી હોય, ત્યારે આ મોડલ્સ ઘણીવાર છેલ્લી સ્થિતિ ભૂલી જાય છે અથવા ગૂંચવાઈ જાય છે. StateBench આ મર્યાદાઓને વધુ ઊંડાણપૂર્વક સમજવા માટે બનાવવામાં આવ્યું છે.
- ઇનપુટ સિક્વન્સમોડલને વેરિએબલ અસાઇનમેન્ટ્સની એક લાંબી સાંકળ આપવામાં આવે છે, જેમ કે 'A = 5' અને પછી 'B = A'.
- સ્ટેટ અપડેટદરેક નવા સ્ટેપ પર, મોડલે આંતરિક રીતે યાદ રાખવું પડે છે કે કયા વેરિએબલની કિંમત બદલાઈ છે.
- જટિલતાના સ્તરોમાહિતીના ફેરફારો સાદા (r-trivial) થી લઈને અત્યંત જટિલ (general finite) હોઈ શકે છે.
- અંતિમ પરિણામઆખી સિક્વન્સ વાંચ્યા પછી, મોડલે દરેક વેરિએબલની છેલ્લી સાચી કિંમત જણાવવાની હોય છે.
StateBench ને ચાર અલગ-અલગ મુશ્કેલીના સ્તરોમાં વહેંચવામાં આવ્યું છે. આ સ્તરો ગણિતની 'ક્રોન-રોડ્સ થિયરી' (Krohn–Rhodes theory) પર આધારિત છે, જે સ્ટેટ ટ્રેકિંગની સમસ્યાઓને મૂળભૂત તત્વોમાં વિભાજિત કરે છે. પ્રથમ સ્તર 'r-trivial' છે, જે સૌથી સરળ છે. તેમાં મોડલે માત્ર એ યાદ રાખવાનું હોય છે કે કોઈ વસ્તુમાં છેલ્લે કયો ફેરફાર થયો હતો. બીજું સ્તર 'aperiodic' છે, જે થોડું વધુ જટિલ છે. ત્રીજું સ્તર 'soluble' અને ચોથું 'general finite' છે, જે સૌથી અઘરું છે. આ છેલ્લા સ્તરમાં માહિતીના ફેરફારો એકબીજા પર નિર્ભર હોય છે, એટલે કે જો મોડલ એક પણ સ્ટેપ ચૂકી જાય, તો આખો જવાબ ખોટો પડી શકે છે.
| સ્તર | વર્ણન |
|---|---|
| r-trivial | સૌથી સરળ: માત્ર છેલ્લો ફેરફાર યાદ રાખવાનો હોય છે. |
| aperiodic | મધ્યમ: થોડું વધુ જટિલ સ્ટેટ ટ્રેકિંગ. |
| soluble | અઘરું: માહિતીના ફેરફારો એકબીજા પર નિર્ભર હોય છે. |
| general finite | સૌથી અઘરું: એક પણ સ્ટેપ ચૂકી જવાથી જવાબ ખોટો પડે છે. |
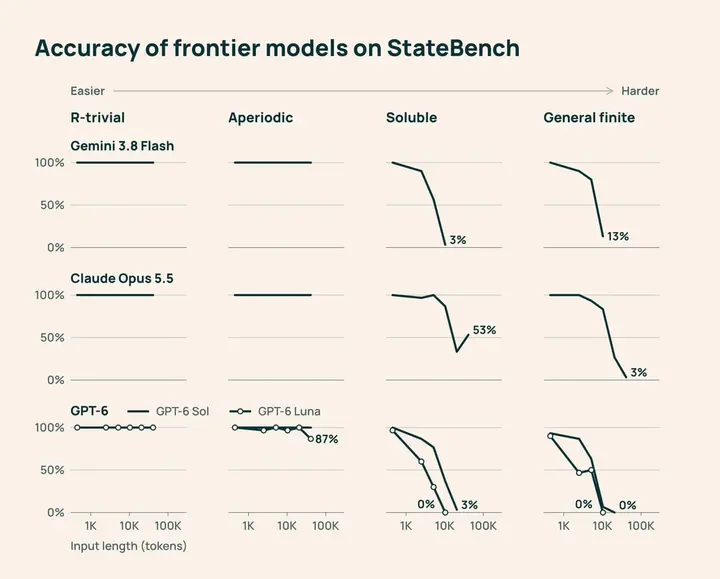
સંશોધકોએ આ પરીક્ષણ માટે વિવિધ પ્રકારના મોડલ્સનો ઉપયોગ કર્યો હતો. તેમાં ઓપન-સોર્સ (open-source): જેનો કોડ અને ડેટા જાહેર હોય, મોડલ્સ જેવા કે Olmo ૩ અને Olmo Hybrid નો સમાવેશ થાય છે. આ ઉપરાંત, દુનિયાના સૌથી શક્તિશાળી ગણાતા ફ્રન્ટિયર મોડલ્સ (frontier models) જેવા કે Gemini ૩.૮ Flash, Claude Opus ૫.૫, અને GPT-૬ Sol અને Luna પર પણ પરીક્ષણ કરવામાં આવ્યું હતું. આ મોડલ્સને હજારો ટોકન (token): શબ્દનો એક નાનો ટુકડો, લાંબા લખાણો આપવામાં આવ્યા હતા અને જોવામાં આવ્યું હતું કે તેઓ ક્યાં સુધી સચોટ રહી શકે છે.
પરીક્ષણના પરિણામો ચોંકાવનારા હતા. જ્યારે લખાણ ટૂંકું હોય ત્યારે લગભગ તમામ મોડલ્સ સારું પ્રદર્શન કરે છે. પરંતુ જેમ જેમ લખાણની લંબાઈ વધે છે, તેમ તેમ તેમની સચોટતા ઘટવા લાગે છે. ખાસ કરીને સૌથી અઘરા 'general finite' સ્તર પર, GPT-૬ અને Claude જેવા મોડલ્સની સચોટતા ૧૩% થી પણ નીચે જતી રહી હતી. આનો અર્થ એ થયો કે ભલે આ મોડલ્સ ગમે તેટલા સ્માર્ટ દેખાતા હોય, પણ લાંબી અને જટિલ માહિતીની સાંકળને ટ્રેક કરવામાં તેઓ હજુ પણ કાચા છે. સંશોધકોના મતે, આ સમસ્યાનું મુખ્ય કારણ 'સેન્સિટિવિટી' (sensitivity) છે; એટલે કે જટિલ સ્તરો પર એક નાની ભૂલ પણ અંતિમ પરિણામને સંપૂર્ણપણે બદલી નાખે છે.
| સ્તરનું નામ | વર્ણન | ઉદાહરણ |
|---|---|---|
| r-trivial | સૌથી સરળ, માત્ર છેલ્લો ફેરફાર યાદ રાખવો | x = 5, પછી x = 10. હવે x શું છે? |
| aperiodic | મધ્યમ જટિલતા, ક્રમિક ફેરફારો | ચોક્કસ ક્રમમાં થતા ફેરફારો ટ્રેક કરવા |
| soluble | વધુ અઘરું, ગણિત આધારિત ફેરફારો | એક ફેરફાર બીજા પર આધારિત હોય |
| general finite | સૌથી જટિલ, સંપૂર્ણ સાંકળ યાદ રાખવી | જટિલ પ્રોગ્રામિંગ કોડ અથવા રહસ્યમય વાર્તા |
આ સમસ્યાના ઉકેલ તરીકે સંશોધકોએ 'રિકરન્ટ' (recurrent) અને 'હાઇબ્રિડ' (hybrid) આર્કિટેક્ચર પર ધ્યાન કેન્દ્રિત કર્યું છે. ટ્રાન્સફોર્મર મોડલ્સ આખા લખાણને એકસાથે જુએ છે, જ્યારે રિકરન્ટ મોડલ્સ જેમ કે Gated DeltaNet માહિતીને ક્રમશઃ પ્રોસેસ કરે છે અને એક 'રનિંગ મેમરી' (running memory) જાળવી રાખે છે. જ્યારે આ મોડલ્સને સીધું જ StateBench ના ડેટા પર તાલીમ આપવામાં આવી, ત્યારે તેઓએ અદભૂત પ્રદર્શન કર્યું. Gated DeltaNet મોડલ્સ પોતાની તાલીમ કરતા ૨૫૦ ગણા લાંબા લખાણમાં પણ સ્ટેટ ટ્રેકિંગ કરવામાં સફળ રહ્યા હતા. આ દર્શાવે છે કે કદાચ ભવિષ્યના AI મોડલ્સમાં માત્ર ટ્રાન્સફોર્મર જ નહીં, પણ રિકરન્ટ લેયર્સનો પણ સમાવેશ કરવો પડશે.
- ડેટા ઇનપુટમોડલને હજારો ટોકન લાંબુ લખાણ આપવામાં આવે છે જેમાં વેરિએબલ્સની કિંમતો બદલાતી રહે છે.
- સ્ટેટ ટ્રેકિંગમોડલે આખી પ્રક્રિયા દરમિયાન દરેક વેરિએબલની વર્તમાન સ્થિતિને ટ્રેક કરવાની હોય છે.
- પરિણામનું મૂલ્યાંકનઅંતે મોડલને પ્રશ્ન પૂછવામાં આવે છે કે વેરિએબલની છેલ્લી કિંમત શું છે અને તેની સચોટતા માપવામાં આવે છે.
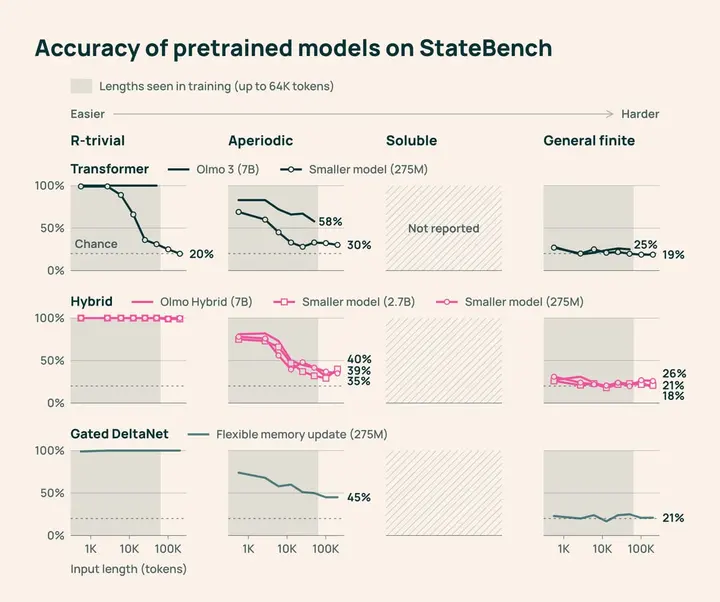
એક રસપ્રદ અવલોકન એ પણ હતું કે મોડલને પ્રશ્ન કઈ રીતે પૂછવામાં આવે છે તેનાથી પણ પરિણામ બદલાય છે. દાખલા તરીકે, જ્યારે ૨૭૫ મિલિયન પેરામીટર (parameter): મોડલની શીખવાની ક્ષમતાનું માપ, ધરાવતા હાઇબ્રિડ મોડલને સાદા લખાણ સ્વરૂપે પ્રશ્ન પૂછવામાં આવ્યો ત્યારે તેણે સારું પ્રદર્શન કર્યું. પરંતુ જ્યારે એ જ પ્રશ્ન સ્પ્રેડશીટ (spreadsheet) એડિટિંગના ફોર્મેટમાં પૂછવામાં આવ્યો, ત્યારે તેની સચોટતા ઘટી ગઈ. આથી જ StateBench માં એક જ સમસ્યાને અલગ-અલગ ફોર્મેટમાં રજૂ કરવામાં આવે છે જેથી મોડલની સાચી સમજણ માપી શકાય.
ભારત જેવા દેશોમાં જ્યાં AI નો ઉપયોગ કાયદાકીય દસ્તાવેજોના વિશ્લેષણ અથવા લાંબા મેડિકલ રિપોર્ટ્સ વાંચવા માટે થઈ રહ્યો છે, ત્યાં આ પ્રકારના સંશોધનો ખૂબ મહત્વના છે. જો કોઈ AI વકીલ હજારો પાનાના કેસમાં કોઈ એક મહત્વના પુરાવાનો ફેરફાર ટ્રેક કરવાનું ચૂકી જાય, તો તેનાથી ગંભીર પરિણામો આવી શકે છે. StateBench જેવા સાધનો ડેવલપર્સને એ સમજવામાં મદદ કરશે કે તેમનું મોડલ કયા પ્રકારના કાર્યો માટે સુરક્ષિત છે અને ક્યાં તેને વધુ સુધારવાની જરૂર છે.
જોકે, StateBench ની પણ પોતાની કેટલીક મર્યાદાઓ છે. હાલમાં આ પરીક્ષણ એવું માની લે છે કે માહિતીમાં વેરિએબલ્સની સંખ્યા નિશ્ચિત છે. વાસ્તવિક જીવનમાં, જેમ કે લાંબી વાતચીત દરમિયાન, નવા પાત્રો અથવા નવી વસ્તુઓ ગમે ત્યારે ઉમેરાઈ શકે છે. સંશોધકો હવે આ દિશામાં કામ કરી રહ્યા છે કે કેવી રીતે અનિશ્ચિત સંખ્યામાં આવતી નવી માહિતીને ટ્રેક કરવાની ક્ષમતા માપી શકાય. આ ઉપરાંત, ગાણિતિક ચોકસાઈ (numerical precision) મોડલના પ્રદર્શન પર કેવી અસર કરે છે તે પણ એક ખુલ્લો પ્રશ્ન છે.
નિષ્કર્ષમાં, StateBench એ AI સંશોધકો માટે એક 'નોર્થ સ્ટાર' (North Star) એટલે કે માર્ગદર્શક સમાન છે. તે માત્ર મોડલ્સની નબળાઈઓ જ નથી બતાવતું, પરંતુ નવી અને વધુ મજબૂત આર્કિટેક્ચર વિકસાવવા માટેની દિશા પણ સૂચવે છે. જેમ જેમ આપણે વધુ જટિલ AI સિસ્ટમ્સ તરફ આગળ વધી રહ્યા છીએ, તેમ તેમ તેમની યાદશક્તિ અને તર્કશક્તિની આકરી કસોટી કરવી અનિવાર્ય બની ગઈ છે. કંપનીની જાહેરાત અને ટેકનિકલ રિપોર્ટ મુજબ, આ ડેટાસેટ અને કોડ હવે જાહેર જનતા માટે ઉપલબ્ધ કરાવવામાં આવ્યા છે જેથી વિશ્વભરના સંશોધકો તેનો ઉપયોગ કરી શકે.


