StateBench: क्या AI लंबे लेखों में जानकारी के बदलावों को याद रख सकता है? एक नया परीक्षण
आर्टिफिशियल इंटेलिजेंस मॉडल्स की लंबे दस्तावेजों में जानकारी के बदलते प्रवाह को समझने की क्षमता जांचने के लिए 'StateBench' नामक एक नया परीक्षण ढांचा प्रस्तुत किया गया है।
आज के समय में आर्टिफिशियल इंटेलिजेंस (AI) और विशेष रूप से लार्ज लैंग्वेज मॉडल्स (LLMs) हमारे काम करने के तरीके को बदल रहे हैं। ये मॉडल्स हजारों पन्नों के दस्तावेजों को पढ़ सकते हैं और उनमें से सारांश भी दे सकते हैं। लेकिन क्या ये मॉडल्स वास्तव में समझते हैं कि लंबे लेखन के दौरान जानकारी में किस तरह के बदलाव हो रहे हैं? इस प्रश्न का उत्तर पाने के लिए एलन इंस्टीट्यूट फॉर AI (Ai2) के शोधकर्ताओं ने 'StateBench' नामक एक नया बेंचमार्क (benchmark): परीक्षण के लिए मानदंड, प्रस्तुत किया है। यह बेंचमार्क विशेष रूप से 'स्टेट ट्रैकिंग' (state tracking) यानी जानकारी में होने वाले क्रमिक बदलावों पर नजर रखने की मॉडल की क्षमता को मापता है।
स्टेट ट्रैकिंग किसी भी बौद्धिक कार्य का आधार है। मान लीजिए कि आप एक रहस्यमयी उपन्यास पढ़ रहे हैं। कहानी की शुरुआत में जॉन के पास एक चाकू है। कुछ अध्यायों के बाद जॉन वह चाकू मैरी को देता है और मैरी उसे एडवर्ड को देती है। यदि अंत में कोई हत्या होती है, तो पाठक के रूप में आपको याद रखना पड़ता है कि अभी चाकू किसके पास है। यही बात प्रोग्रामिंग कोड पढ़ते समय भी लागू होती है, जहाँ वेरिएबल (variable): मान संग्रहीत करने के लिए नाम, की कीमतें लगातार बदलती रहती हैं। यदि AI मॉडल इन बदलावों को सटीक रूप से ट्रैक न कर सके, तो वह लंबे और जटिल कार्यों में विफल हो सकता है।
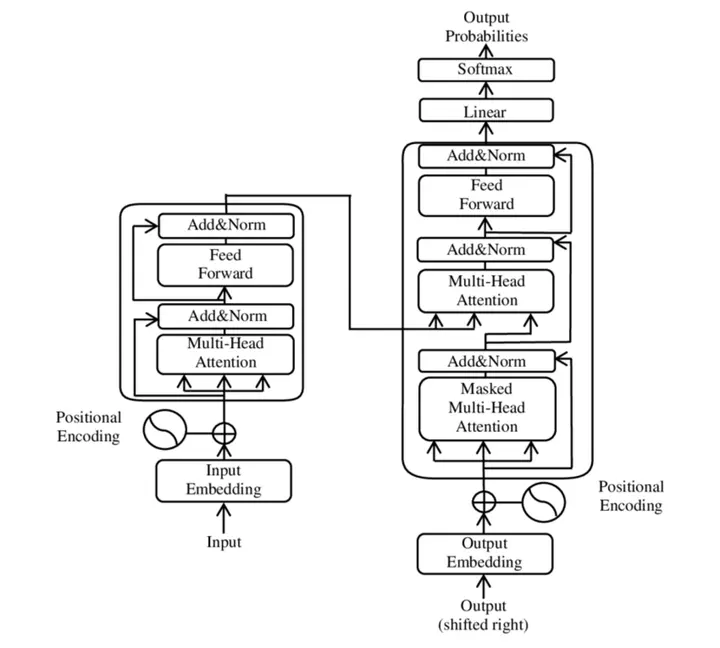
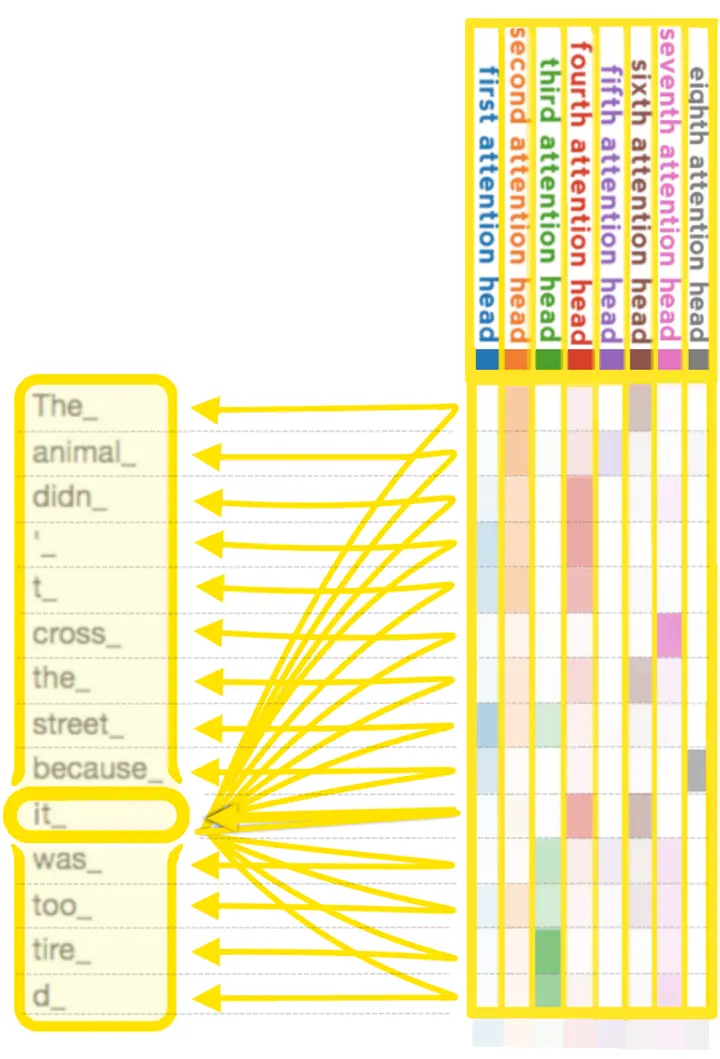
हाल के अधिकांश AI मॉडल्स 'ट्रांसफॉर्मर' (transformer) आर्किटेक्चर पर आधारित हैं। ट्रांसफॉर्मर एक प्रकार का न्यूरल नेटवर्क है जो लेखन के विभिन्न भागों के बीच के संबंधों को समझने के लिए 'अटेंशन मैकेनिज्म' का उपयोग करता है। हालाँकि, शोधकर्ताओं ने नोट किया है कि ट्रांसफॉर्मर मॉडल्स की लंबे लेखन में स्टेट ट्रैकिंग करने की क्षमता में कुछ सैद्धांतिक सीमाएँ हैं। विशेष रूप से जब जानकारी के बदलावों की श्रृंखला बहुत लंबी होती है, तब ये मॉडल्स अक्सर अंतिम स्थिति भूल जाते हैं या भ्रमित हो जाते हैं। StateBench इन सीमाओं को अधिक गहराई से समझने के लिए बनाया गया है।
- इनपुट सीक्वेंसमॉडल को वेरिएबल असाइनमेंट्स की एक लंबी श्रृंखला दी जाती है, जैसे 'A = 5' और फिर 'B = A' ।
- स्टेट अपडेटप्रत्येक नए स्टेप पर, मॉडल को आंतरिक रूप से याद रखना पड़ता है कि किस वेरिएबल की कीमत बदल गई है।
- जटिलता के स्तरजानकारी के बदलाव साधारण (r-trivial) से लेकर अत्यंत जटिल (general finite) हो सकते हैं।
- अंतिम परिणामपूरी सीक्वेंस पढ़ने के बाद, मॉडल को प्रत्येक वेरिएबल की अंतिम सही कीमत बतानी होती है।
StateBench को चार अलग-अलग कठिनाई स्तरों में विभाजित किया गया है। ये स्तर गणित की 'क्रोन-रोड्स थ्योरी' (Krohn–Rhodes theory) पर आधारित हैं, जो स्टेट ट्रैकिंग की समस्याओं को मूलभूत तत्वों में विभाजित करती है। प्रथम स्तर 'r-trivial' है, जो सबसे सरल है। इसमें मॉडल को केवल यह याद रखना होता है कि किसी वस्तु में अंत में कौन सा बदलाव हुआ था। दूसरा स्तर 'aperiodic' है, जो थोड़ा अधिक जटिल है। तीसरा स्तर 'soluble' और चौथा 'general finite' है, जो सबसे कठिन है। इस अंतिम स्तर में जानकारी के बदलाव एक-दूसरे पर निर्भर होते हैं, यानी यदि मॉडल एक भी स्टेप चूक जाए, तो पूरा उत्तर गलत हो सकता है।
| स्तर | विवरण |
|---|---|
| r-trivial | सबसे सरल: केवल अंतिम बदलाव याद रखना होता है। |
| aperiodic | मध्यम: थोड़ा अधिक जटिल स्टेट ट्रैकिंग। |
| soluble | कठिन: जानकारी के बदलाव एक-दूसरे पर निर्भर होते हैं। |
| general finite | सबसे कठिन: एक भी स्टेप चूकने से जवाब गलत हो जाता है। |
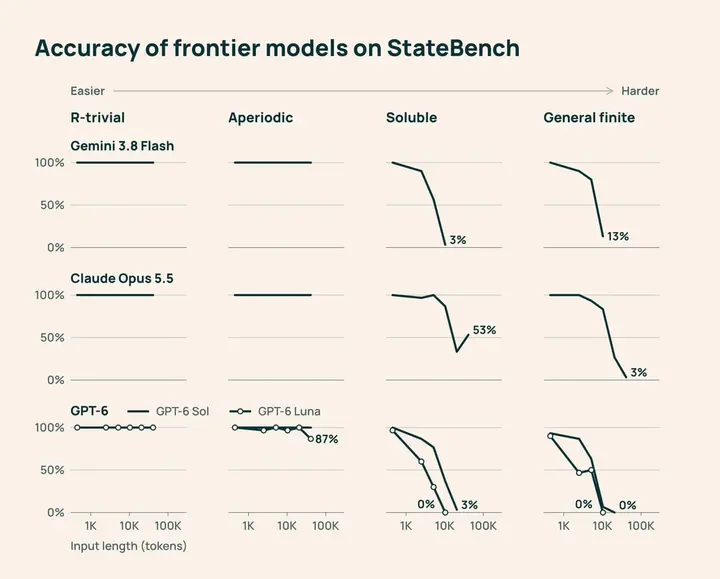
शोधकर्ताओं ने इस परीक्षण के लिए विभिन्न प्रकार के मॉडल्स का उपयोग किया था। इनमें ओपन-सोर्स (open-source): जिसका कोड और डेटा सार्वजनिक हो, मॉडल्स जैसे कि Olmo 3 और Olmo Hybrid शामिल हैं। इसके अलावा, दुनिया के सबसे शक्तिशाली माने जाने वाले फ्रंटियर मॉडल्स (frontier models) जैसे कि Gemini 3.8 Flash, Claude Opus 5.5, और GPT-6 Sol और Luna पर भी परीक्षण किया गया था। इन मॉडल्स को हजारों टोकन (token): शब्द का एक छोटा टुकड़ा, लंबे लेख दिए गए थे और यह देखा गया था कि वे कहाँ तक सटीक रह सकते हैं।
परीक्षण के परिणाम चौंकाने वाले थे। जब लेख छोटा होता है, तब लगभग सभी मॉडल्स अच्छा प्रदर्शन करते हैं। लेकिन जैसे-जैसे लेख की लंबाई बढ़ती है, वैसे-वैसे उनकी सटीकता घटने लगती है। विशेष रूप से सबसे कठिन 'general finite' स्तर पर, GPT-6 और Claude जैसे मॉडल्स की सटीकता 13% से भी नीचे चली गई थी। इसका अर्थ यह हुआ कि भले ही ये मॉडल्स कितने भी स्मार्ट दिखते हों, लेकिन लंबी और जटिल जानकारी की श्रृंखला को ट्रैक करने में वे अभी भी कच्चे हैं। शोधकर्ताओं के अनुसार, इस समस्या का मुख्य कारण 'सेंसिटिविटी' (sensitivity) है; यानी जटिल स्तरों पर एक छोटी सी गलती भी अंतिम परिणाम को पूरी तरह बदल देती है।
| स्तर का नाम | विवरण | उदाहरण |
|---|---|---|
| r-trivial | सबसे सरल, केवल अंतिम बदलाव याद रखना | x = 5, फिर x = 10. अब x क्या है? |
| aperiodic | मध्यम जटिलता, क्रमिक बदलाव | निश्चित क्रम में होने वाले बदलावों को ट्रैक करना |
| soluble | अधिक कठिन, गणित आधारित बदलाव | एक बदलाव दूसरे पर आधारित हो |
| general finite | सबसे जटिल, पूरी श्रृंखला याद रखना | जटिल प्रोग्रामिंग कोड या रहस्यमयी कहानी |
इस समस्या के समाधान के रूप में शोधकर्ताओं ने 'रिकरेंट' (recurrent) और 'हाइब्रिड' (hybrid) आर्किटेक्चर पर ध्यान केंद्रित किया है। ट्रांसफॉर्मर मॉडल्स पूरे लेख को एक साथ देखते हैं, जबकि रिकरेंट मॉडल्स जैसे कि Gated DeltaNet जानकारी को क्रमिक रूप से प्रोसेस करते हैं और एक 'रनिंग मेमोरी' (running memory) बनाए रखते हैं। जब इन मॉडल्स को सीधे StateBench के डेटा पर प्रशिक्षित किया गया, तो उन्होंने अद्भुत प्रदर्शन किया। Gated DeltaNet मॉडल्स अपनी ट्रेनिंग से 250 गुना लंबे लेख में भी स्टेट ट्रैकिंग करने में सफल रहे। यह दर्शाता है कि शायद भविष्य के AI मॉडल्स में केवल ट्रांसफॉर्मर ही नहीं, बल्कि रिकरेंट लेयर्स को भी शामिल करना होगा।
- डेटा इनपुटमॉडल को हजारों टोकन लंबा टेक्स्ट दिया जाता है जिसमें वेरिएबल्स की कीमतें बदलती रहती हैं।
- स्टेट ट्रैकिंगमॉडल को पूरी प्रक्रिया के दौरान प्रत्येक वेरिएबल की वर्तमान स्थिति को ट्रैक करना होता है।
- परिणाम का मूल्यांकनअंत में मॉडल से प्रश्न पूछा जाता है कि वेरिएबल की अंतिम कीमत क्या है और उसकी सटीकता मापी जाती है।
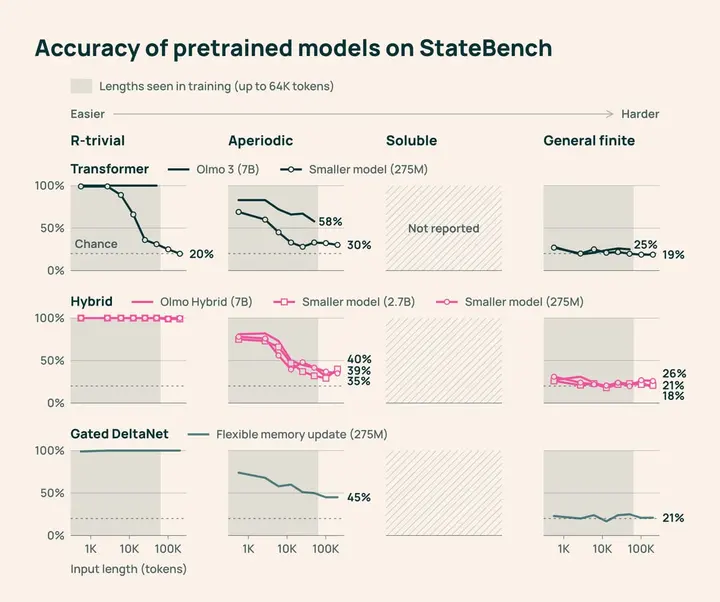
एक दिलचस्प अवलोकन यह भी था कि मॉडल से प्रश्न किस तरह पूछा जाता है, उससे भी परिणाम बदल जाता है। उदाहरण के लिए, जब 275 मिलियन पैरामीटर (parameter): मॉडल की सीखने की क्षमता का माप, वाले हाइब्रिड मॉडल से सादे लेख के रूप में प्रश्न पूछा गया, तो उसने अच्छा प्रदर्शन किया। लेकिन जब वही प्रश्न स्प्रेडशीट (spreadsheet) एडिटिंग के फॉर्मेट में पूछा गया, तो उसकी सटीकता घट गई। इसीलिए StateBench में एक ही समस्या को अलग-अलग फॉर्मेट में प्रस्तुत किया जाता है ताकि मॉडल की सही समझ को मापा जा सके।
भारत जैसे देशों में, जहाँ AI का उपयोग कानूनी दस्तावेजों के विश्लेषण या लंबे मेडिकल रिपोर्ट्स को पढ़ने के लिए किया जा रहा है, वहाँ इस प्रकार के शोध बहुत महत्वपूर्ण हैं। यदि कोई AI वकील हजारों पन्नों के केस में किसी एक महत्वपूर्ण प्रमाण के बदलाव को ट्रैक करने से चूक जाए, तो इसके गंभीर परिणाम हो सकते हैं। StateBench जैसे उपकरण डेवलपर्स को यह समझने में मदद करेंगे कि उनका मॉडल किस प्रकार के कार्यों के लिए सुरक्षित है और कहाँ उसे और अधिक सुधारने की आवश्यकता है।
हालाँकि, StateBench की भी अपनी कुछ सीमाएँ हैं। वर्तमान में यह परीक्षण यह मानकर चलता है कि जानकारी में वेरिएबल्स की संख्या निश्चित है। वास्तविक जीवन में, जैसे कि लंबी बातचीत के दौरान, नए पात्र या नई वस्तुएँ कभी भी जुड़ सकती हैं। शोधकर्ता अब इस दिशा में काम कर रहे हैं कि कैसे अनिश्चित संख्या में आने वाली नई जानकारी को ट्रैक करने की क्षमता को मापा जा सके। इसके अलावा, गणितीय सटीकता (numerical precision) मॉडल के प्रदर्शन पर कैसे असर करती है, यह भी एक खुला प्रश्न है।
निष्कर्ष में, StateBench AI शोधकर्ताओं के लिए एक 'नॉर्थ स्टार' (North Star) यानी मार्गदर्शक के समान है। यह न केवल मॉडल्स की कमजोरियों को दिखाता है, बल्कि नए और अधिक मजबूत आर्किटेक्चर विकसित करने के लिए दिशा भी सुझाता है। जैसे-जैसे हम अधिक जटिल AI सिस्टम्स की ओर बढ़ रहे हैं, वैसे-वैसे उनकी याददाश्त और तर्कशक्ति की कड़ी परीक्षा लेना अनिवार्य हो गया है। कंपनी की घोषणा और टेक्निकल रिपोर्ट के अनुसार, यह डेटासेट और कोड अब आम जनता के लिए उपलब्ध करा दिए गए हैं ताकि दुनिया भर के शोधकर्ता इनका उपयोग कर सकें।


