જનરેટિવ એડવર્સરીયલ નેટવર્ક્સ (GANs): બે મશીનો વચ્ચેની હરીફાઈ જે આબેહૂબ નકલી ડેટા બનાવે છે
ઈયાન ગુડફેલો દ્વારા ૨૦૧૪માં શોધાયેલ GAN ટેકનોલોજી કેવી રીતે બે ન્યુરલ નેટવર્ક વચ્ચેની 'ઝીરો-સમ ગેમ' દ્વારા વાસ્તવિક લાગે તેવો સિન્થેટિક ડેટા તૈયાર કરે છે તેની ઊંડી સમજૂતી.
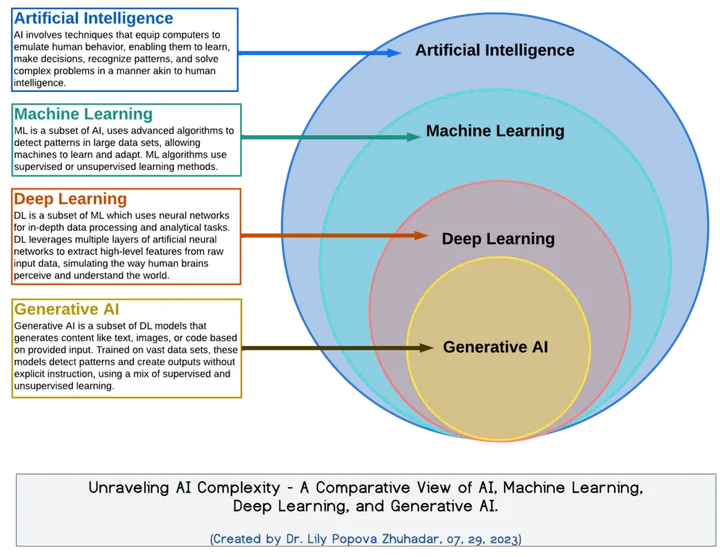
વર્ષ ૨૦૧૪માં આર્ટિફિશિયલ ઇન્ટેલિજન્સ (AI) ની દુનિયામાં એક ક્રાંતિકારી વળાંક આવ્યો જ્યારે મોન્ટ્રીયલ યુનિવર્સિટીના સંશોધક ઈયાન ગુડફેલો અને તેમના સાથીઓએ 'જનરેટિવ એડવર્સરીયલ નેટવર્ક' (Generative Adversarial Network - GAN) નો ખ્યાલ રજૂ કર્યો. વિકિપીડિયા અને ટેકનિકલ અહેવાલો મુજબ, આ એક એવું માળખું છે જે મશીન લર્નિંગના ક્ષેત્રમાં જનરેટિવ AI (Generative AI) માટે પાયાનું સાબિત થયું છે. GAN ની સૌથી મોટી વિશેષતા એ છે કે તે બે અલગ-અલગ ન્યુરલ નેટવર્ક વચ્ચેની હરીફાઈ દ્વારા નવો અને આબેહૂબ ડેટા તૈયાર કરે છે. આ પ્રક્રિયા ઉત્ક્રાંતિના સિદ્ધાંત જેવી છે, જ્યાં બે પક્ષો એકબીજાને હરાવવાના પ્રયાસમાં સતત વધુ શક્તિશાળી અને સચોટ બનતા જાય છે.
GAN નો મુખ્ય ઉદ્દેશ્ય એવો ડેટા બનાવવાનો છે જે અસલી તાલીમ ડેટા (training data) જેવો જ દેખાય અથવા તેના જેવા જ ગુણધર્મો ધરાવતો હોય. ઉદાહરણ તરીકે, જો GAN ને હજારો ફોટોગ્રાફ્સ બતાવવામાં આવે, તો તે એવા નવા ફોટા બનાવી શકે છે જે માનવીય આંખને સંપૂર્ણપણે અસલી લાગે, ભલે તે વ્યક્તિ કે સ્થળ વાસ્તવિક દુનિયામાં અસ્તિત્વમાં ન હોય. આ ક્ષમતાને કારણે જ GAN નો ઉપયોગ સિન્થેટિક ડેટા (synthetic data) એટલે કે કૃત્રિમ રીતે બનાવેલી માહિતી તૈયાર કરવા માટે વ્યાપકપણે થાય છે. આ ટેકનોલોજી માત્ર છબીઓ પૂરતી મર્યાદિત નથી, પરંતુ તેનો ઉપયોગ અવાજ, લખાણ અને વૈજ્ઞાનિક ડેટાના નિર્માણમાં પણ થઈ રહ્યો છે.
- ઇનપુટ નોઈઝજનરેટર નેટવર્ક લેટન્ટ સ્પેસમાંથી રેન્ડમ અંકો (noise) મેળવે છે.
- ડેટા નિર્માણજનરેટર આ નોઈઝનો ઉપયોગ કરીને નકલી ડેટા અથવા છબી બનાવે છે.
- તુલના અને ભેદડિસ્ક્રીમિનેટર અસલી ડેટાસેટ અને જનરેટરના નકલી ડેટાની સરખામણી કરે છે.
- ફીડબેક લૂપડિસ્ક્રીમિનેટરના પરિણામના આધારે બંને નેટવર્ક પોતાની ભૂલો સુધારે છે.
- સંતુલનજ્યારે ડિસ્ક્રીમિનેટર તફાવત પારખી ન શકે ત્યારે તાલીમ પૂર્ણ થાય છે.
- રેન્ડમ નોઈઝજનરેટર લેટન્ટ સ્પેસમાંથી રેન્ડમ અંકો લઈને શરૂઆત કરે છે.
- ડેટા નિર્માણજનરેટર આ અંકોમાંથી એક નકલી ડેટા સેમ્પલ તૈયાર કરે છે.
- તુલનાડિસ્ક્રિમિનેટર અસલી ડેટા અને જનરેટર દ્વારા બનાવેલા નકલી ડેટાની સરખામણી કરે છે.
- પ્રતિસાદ (Feedback)ડિસ્ક્રિમિનેટરના પરિણામ પરથી જનરેટર પોતાની ભૂલો સુધારે છે અને વધુ સચોટ બનવા પ્રયત્ન કરે છે.
GAN નું આર્કિટેક્ચર: સર્જક અને ભેદ પારખનારની લડાઈ
GAN ની કાર્યપદ્ધતિને સમજવા માટે આપણે તેને બે ખેલાડીઓ વચ્ચેની 'ઝીરો-સમ ગેમ' (zero-sum game) તરીકે જોવી જોઈએ. આ રમતમાં એક ખેલાડીનો ફાયદો એ બીજા ખેલાડીનું નુકસાન છે. આ બે ખેલાડીઓ એટલે 'જનરેટર' (Generator) અને 'ડિસ્ક્રિમિનેટર' (Discriminator). જનરેટરનું કામ નવો ડેટા બનાવવાનું છે, જ્યારે ડિસ્ક્રીમિનેટરનું કામ તે ડેટા અસલી છે કે નકલી તે નક્કી કરવાનું છે. આ બંને નેટવર્ક એકસાથે તાલીમ મેળવે છે અને એકબીજાની ભૂલોમાંથી શીખે છે.
જનરેટર નેટવર્કની શરૂઆત 'લેટન્ટ સ્પેસ' (latent space) માંથી લેવામાં આવેલા રેન્ડમ નોઈઝ (random noise) એટલે કે યાદચ્છિક અંકોથી થાય છે. તે આ અંકોને પ્રોસેસ કરીને એક નવી છબી અથવા ડેટા સેમ્પલ બનાવે છે. શરૂઆતમાં, જનરેટર દ્વારા બનાવવામાં આવેલો ડેટા સાવ અર્થહીન અને અસ્પષ્ટ હોય છે. બીજી તરફ, ડિસ્ક્રીમિનેટર પાસે બે પ્રકારના ઇનપુટ હોય છે: એક અસલી ડેટાસેટમાંથી લીધેલા નમૂના અને બીજા જનરેટર દ્વારા બનાવવામાં આવેલા નકલી નમૂના. ડિસ્ક્રીમિનેટરનું લક્ષ્ય એ છે કે તે અસલી ડેટાને ૧ (અસલી) અને નકલી ડેટાને ૦ (નકલી) તરીકે ઓળખી કાઢે.
તાલીમની પ્રક્રિયા અને બેકપ્રોપેગેશન
GAN ની તાલીમ એ એક જટિલ પ્રક્રિયા છે જેમાં 'બેકપ્રોપેગેશન' (backpropagation) નો ઉપયોગ થાય છે. આ એક એવી પદ્ધતિ છે જેના દ્વારા નેટવર્ક પોતાની ભૂલો સુધારે છે. જ્યારે જનરેટર કોઈ નમૂનો બનાવે અને ડિસ્ક્રીમિનેટર તેને 'નકલી' તરીકે ઓળખી કાઢે, ત્યારે જનરેટરને સંકેત મળે છે કે તેણે પોતાની પદ્ધતિમાં સુધારો કરવાની જરૂર છે. તેવી જ રીતે, જો ડિસ્ક્રીમિનેટર કોઈ નકલી નમૂનાને 'અસલી' માની લે, તો ડિસ્ક્રીમિનેટરને પોતાની ઓળખવાની ક્ષમતા સુધારવા માટે તાલીમ આપવામાં આવે છે.
આ પ્રક્રિયા હજારો કે લાખો વખત પુનરાવર્તિત થાય છે. જેમ જેમ સમય પસાર થાય છે, તેમ તેમ જનરેટર એટલું કુશળ બની જાય છે કે તે અસલી ડેટાની આંકડાકીય લાક્ષણિકતાઓને સંપૂર્ણપણે પકડી લે છે. અંતે એક એવો તબક્કો આવે છે જ્યાં ડિસ્ક્રીમિનેટર મૂંઝવણમાં મુકાઈ જાય છે અને તે અસલી અને નકલી ડેટા વચ્ચેનો તફાવત પારખી શકતું નથી. આ તબક્કે આપણે કહી શકીએ કે GAN એ સફળતાપૂર્વક સિન્થેટિક ડેટા બનાવવાનું શીખી લીધું છે. ઈયાન ગુડફેલોના મૂળ પેપર મુજબ, આ એક ગાણિતિક રમત છે જ્યાં જનરેટર લોસ ફંક્શનને ઘટાડવાનો પ્રયાસ કરે છે અને ડિસ્ક્રીમિનેટર તેને વધારવાનો પ્રયાસ કરે છે.
| વિશેષતા | GAN | VAE | Autoregressive |
|---|---|---|---|
| ડેટા નિર્માણની ઝડપ | ઝડપી (એક પાસમાં) | ઝડપી | ધીમી (ક્રમિક) |
| છબીની ગુણવત્તા | અત્યંત તીક્ષ્ણ | થોડી ઝાંખી | સારી |
| ગાણિતિક અભિગમ | ઇમ્પ્લીસિટ (પરોક્ષ) | એક્સપ્લીસિટ (પ્રત્યક્ષ) | એક્સપ્લીસિટ |
| તાલીમની મુશ્કેલી | વધારે (અસ્થિર) | ઓછી | મધ્યમ |
ગાણિતિક પાયો અને સંભાવનાના સિદ્ધાંતો
GAN ના મૂળમાં સંભાવના શાસ્ત્ર (probability theory) અને મેઝર થીયરી (measure theory) રહેલી છે. ગાણિતિક રીતે જોઈએ તો, જનરેટર એક એવું ફંક્શન છે જે લેટન્ટ ડિસ્ટ્રિબ્યુશનને વાસ્તવિક ડેટા ડિસ્ટ્રિબ્યુશનમાં રૂપાંતરિત કરવાનો પ્રયાસ કરે છે. સ્ત્રોત ૧ મુજબ, આ રમતનું ઓબ્જેક્ટિવ ફંક્શન (objective function) લોગ-સંભાવના પર આધારિત છે. ડિસ્ક્રીમિનેટર એ સુનિશ્ચિત કરે છે કે તે અસલી ડેટા માટે મહત્તમ મૂલ્ય આપે અને જનરેટર દ્વારા બનાવેલા ડેટા માટે લઘુત્તમ મૂલ્ય આપે.
વ્યવહારમાં, જ્યારે છબીઓ બનાવવાની વાત આવે છે, ત્યારે જનરેટર તરીકે 'ડીકોન્વોલ્યુશનલ ન્યુરલ નેટવર્ક' (deconvolutional neural network) અને ડિસ્ક્રીમિનેટર તરીકે 'કોન્વોલ્યુશનલ ન્યુરલ નેટવર્ક' (convolutional neural network) નો ઉપયોગ થાય છે. આ નેટવર્ક્સ પિક્સેલ્સની ગોઠવણી અને પેટર્નને સમજવામાં ખૂબ જ સક્ષમ હોય છે. GAN ની એક ખાસિયત એ છે કે તે 'ઇમ્પ્લીસિટ જનરેટિવ મોડલ' (implicit generative model) છે, જેનો અર્થ છે કે તે ડેટાની સંભાવનાને સીધી રીતે ગણતું નથી, પરંતુ ડેટા કેવી રીતે ઉત્પન્ન થાય છે તે શીખે છે.

અન્ય મોડલ્સ સાથે સરખામણી
GAN ને અન્ય મશીન લર્નિંગ પદ્ધતિઓ જેમ કે 'વેરિએશનલ ઓટોએનકોડર્સ' (Variational Autoencoders - VAEs) અથવા 'ઓટોરિગ્રેસિવ મોડલ્સ' (Autoregressive models) સાથે સરખાવવામાં આવે છે. VAEs ડેટાને સંકુચિત કરીને ફરીથી બનાવવાનો પ્રયાસ કરે છે, જેના કારણે ઘણીવાર પરિણામી છબીઓ થોડી ઝાંખી (blurry) હોય છે. તેની સરખામણીમાં GAN દ્વારા બનાવવામાં આવેલી છબીઓ અત્યંત તીક્ષ્ણ અને વાસ્તવિક હોય છે. વળી, WaveNet જેવા મોડલ્સ ડેટાને એક પછી એક ટુકડામાં બનાવે છે, જ્યારે GAN આખી છબી કે ડેટા સેમ્પલને એકસાથે (one pass) બનાવી શકે છે.
જોકે, GAN ની તાલીમ આપવી એ પડકારજનક કાર્ય છે. ઘણીવાર 'મોડ કોલેપ્સ' (mode collapse) જેવી સમસ્યાઓ સર્જાય છે, જેમાં જનરેટર માત્ર એક જ પ્રકારના નમૂના બનાવવાનું શરૂ કરી દે છે અને વિવિધતા ગુમાવી બેસે છે. આ સમસ્યાઓને ઉકેલવા માટે StyleGAN-૧ અને StyleGAN-૨ જેવા અદ્યતન આર્કિટેક્ચર વિકસાવવામાં આવ્યા છે, જે ડેટાની વિવિધ લાક્ષણિકતાઓ પર વધુ સારું નિયંત્રણ આપે છે.
સિન્થેટિક ડેટાનું મહત્વ અને ભવિષ્ય
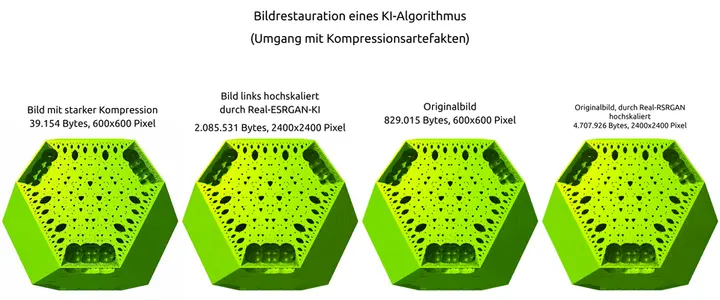
GAN દ્વારા તૈયાર કરવામાં આવતો સિન્થેટિક ડેટા આજે અનેક ક્ષેત્રોમાં ક્રાંતિ લાવી રહ્યો છે. તબીબી ક્ષેત્રમાં, દર્દીઓની ગોપનીયતા જાળવી રાખીને સંશોધન કરવા માટે GAN દ્વારા નકલી મેડિકલ રેકોર્ડ્સ અથવા એક્સ-રે ઈમેજીસ તૈયાર કરવામાં આવે છે. કૃષિ ક્ષેત્રમાં, પાકના રોગોને ઓળખવા માટે મર્યાદિત ડેટા હોય ત્યારે GAN દ્વારા વધારાનો ડેટા બનાવીને મોડલ્સને તાલીમ આપવામાં આવે છે. ખગોળશાસ્ત્રમાં પણ, ટેલિસ્કોપ દ્વારા લેવાયેલી છબીઓમાં રહેલા નોઈઝને દૂર કરવા અને તારાઓને વધુ સ્પષ્ટ રીતે ઓળખવા માટે આ ટેકનોલોજીનો ઉપયોગ થાય છે.
ભારત જેવા દેશોમાં, જ્યાં વિવિધ ભાષાઓ અને ડેટાના પ્રકારો છે, ત્યાં GAN નો ઉપયોગ સ્થાનિક ભાષાઓના અવાજને સિન્થેસાઈઝ કરવા અથવા જૂના દસ્તાવેજોને ડિજિટલ સ્વરૂપે પુનઃસ્થાપિત કરવા માટે થઈ શકે છે. જોકે, આ ટેકનોલોજીનો દુરુપયોગ 'ડીપફેક' (deepfake) બનાવવા માટે પણ થઈ શકે છે, જે એક ચિંતાનો વિષય છે. તેમ છતાં, વિજ્ઞાન અને એન્જિનિયરિંગના દૃષ્ટિકોણથી, GAN એ માનવ સર્જનાત્મકતા અને મશીન લર્નિંગના સંગમનું એક અદભૂત ઉદાહરણ છે.
આગામી વર્ષોમાં, જેમ જેમ કમ્પ્યુટેશનલ પાવર વધશે, તેમ GAN વધુ સચોટ અને કાર્યક્ષમ બનશે. ૨૦૨૬ સુધીમાં, ઘણા નિષ્ણાતો માને છે કે વેરિએશનલ ઓટોએનકોડર્સ અને GAN વચ્ચેનું અંતર ઘટશે અને આપણને વધુ શક્તિશાળી જનરેટિવ મોડલ્સ જોવા મળશે. ઈયાન ગુડફેલોનો આ વિચાર આજે માત્ર એક સંશોધન પત્ર નથી, પરંતુ આધુનિક AI ની કરોડરજ્જુ બની ગયો છે.


