जनरेटिव एडवर्सरियल नेटवर्क्स (GANs): दो मशीनों के बीच की प्रतिस्पर्धा जो सटीक नकली डेटा बनाती है
इयान गुडफेलो द्वारा 2014 में खोजी गई GAN तकनीक कैसे दो न्यूरल नेटवर्क के बीच 'जीरो-सम गेम' के माध्यम से वास्तविक दिखने वाला सिंथेटिक डेटा तैयार करती है, इसकी विस्तृत व्याख्या।
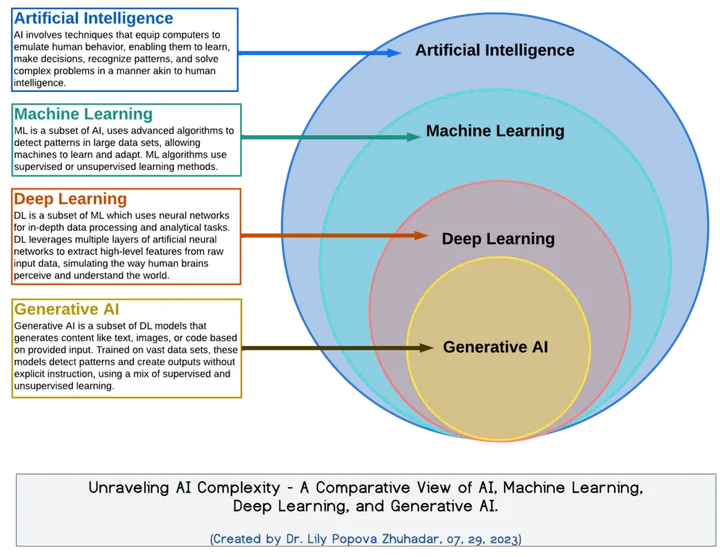
वर्ष 2014 में आर्टिफिशियल इंटेलिजेंस (AI) की दुनिया में एक क्रांतिकारी मोड़ आया जब मॉन्ट्रियल यूनिवर्सिटी के शोधकर्ता इयान गुडफेलो और उनके साथियों ने 'जनरेटिव एडवर्सरियल नेटवर्क' (Generative Adversarial Network - GAN) का विचार प्रस्तुत किया। विकिपीडिया और तकनीकी रिपोर्टों के अनुसार, यह एक ऐसा ढांचा है जो मशीन लर्निंग के क्षेत्र में जनरेटिव AI (Generative AI) के लिए आधारभूत साबित हुआ है। GAN की सबसे बड़ी विशेषता यह है कि यह दो अलग-अलग न्यूरल नेटवर्क के बीच प्रतिस्पर्धा के माध्यम से नया और सटीक डेटा तैयार करता है। यह प्रक्रिया विकास के सिद्धांत जैसी है, जहां दो पक्ष एक-दूसरे को हराने के प्रयास में निरंतर अधिक शक्तिशाली और सटीक बनते जाते हैं।
GAN का मुख्य उद्देश्य ऐसा डेटा बनाना है जो असली ट्रेनिंग डेटा (training data) जैसा ही दिखता हो या उसके समान गुण रखता हो। उदाहरण के लिए, यदि GAN को हजारों तस्वीरें दिखाई जाएं, तो यह ऐसी नई तस्वीरें बना सकता है जो मानवीय आंख को पूरी तरह से असली लगें, भले ही वह व्यक्ति या स्थान वास्तविक दुनिया में अस्तित्व में न हो। इसी क्षमता के कारण GAN का उपयोग सिंथेटिक डेटा (synthetic data) यानी कृत्रिम रूप से तैयार की गई जानकारी बनाने के लिए व्यापक रूप से किया जाता है। यह तकनीक केवल छवियों तक सीमित नहीं है, बल्कि इसका उपयोग ध्वनि, पाठ और वैज्ञानिक डेटा के निर्माण में भी किया जा रहा है।
- इनपुट नॉइज़जनरेटर नेटवर्क लेटेंट स्पेस से रैंडम अंक (noise) प्राप्त करता है।
- डेटा निर्माणजनरेटर इस नॉइज़ का उपयोग करके नकली डेटा या छवि बनाता है।
- तुलना और भेदडिस्क्रिमिनेटर असली डेटासेट और जनरेटर के नकली डेटा की तुलना करता है।
- फीडबैक लूपडिस्क्रिमिनेटर के परिणाम के आधार पर दोनों नेटवर्क अपनी गलतियां सुधारते हैं।
- संतुलनजब डिस्क्रिमिनेटर अंतर पारख न सके तब ट्रेनिंग पूर्ण होती है।
- रैंडम नॉइज़जनरेटर लेटेंट स्पेस से रैंडम अंक लेकर शुरुआत करता है।
- डेटा निर्माणजनरेटर इन अंकों से एक नकली डेटा सैंपल तैयार करता है।
- तुलनाडिस्क्रिमिनेटर असली डेटा और जनरेटर द्वारा बनाए गए नकली डेटा की तुलना करता है।
- प्रतिसाद (Feedback)डिस्क्रिमिनेटर के परिणाम से जनरेटर अपनी गलतियां सुधारता है और अधिक सटीक बनने का प्रयास करता है।
GAN का आर्किटेक्चर: सर्जक और भेद पारखने वाले की लड़ाई
GAN की कार्यप्रणाली को समझने के लिए हमें इसे दो खिलाड़ियों के बीच 'जीरो-सम गेम' (zero-sum game) के रूप में देखना चाहिए। इस खेल में एक खिलाड़ी का लाभ दूसरे खिलाड़ी का नुकसान है। ये दो खिलाड़ी 'जनरेटर' (Generator) और 'डिस्क्रिमिनेटर' (Discriminator) हैं। जनरेटर का काम नया डेटा बनाना है, जबकि डिस्क्रिमिनेटर का काम यह तय करना है कि वह डेटा असली है या नकली। ये दोनों नेटवर्क एक साथ प्रशिक्षित होते हैं और एक-दूसरे की गलतियों से सीखते हैं।
जनरेटर नेटवर्क की शुरुआत 'लेटेंट स्पेस' (latent space) से लिए गए रैंडम नॉइज़ (random noise) यानी यादृच्छिक अंकों से होती है। वह इन अंकों को प्रोसेस करके एक नई छवि या डेटा सैंपल बनाता है। शुरुआत में, जनरेटर द्वारा बनाया गया डेटा पूरी तरह अर्थहीन और अस्पष्ट होता है। दूसरी ओर, डिस्क्रिमिनेटर के पास दो प्रकार के इनपुट होते हैं: एक असली डेटासेट से लिए गए नमूने और दूसरे जनरेटर द्वारा बनाए गए नकली नमूने। डिस्क्रिमिनेटर का लक्ष्य यह है कि वह असली डेटा को 1 (असली) और नकली डेटा को 0 (नकली) के रूप में पहचान ले।
प्रशिक्षण की प्रक्रिया और बैकप्रोपैगेशन
GAN का प्रशिक्षण एक जटिल प्रक्रिया है जिसमें 'बैकप्रोपैगेशन' (backpropagation) का उपयोग होता है। यह एक ऐसी पद्धति है जिसके द्वारा नेटवर्क अपनी गलतियों को सुधारता है। जब जनरेटर कोई नमूना बनाता है और डिस्क्रिमिनेटर उसे 'नकली' के रूप में पहचान लेता है, तब जनरेटर को संकेत मिलता है कि उसे अपनी पद्धति में सुधार करने की आवश्यकता है। इसी तरह, यदि डिस्क्रिमिनेटर किसी नकली नमूने को 'असली' मान लेता है, तो डिस्क्रिमिनेटर को अपनी पहचानने की क्षमता सुधारने के लिए प्रशिक्षित किया जाता है।
यह प्रक्रिया हजारों या लाखों बार दोहराई जाती है। जैसे-जैसे समय बीतता है, जनरेटर इतना कुशल हो जाता है कि वह असली डेटा की सांख्यिकीय विशेषताओं को पूरी तरह से पकड़ लेता है। अंत में एक ऐसा चरण आता है जहाँ डिस्क्रिमिनेटर भ्रमित हो जाता है और वह असली और नकली डेटा के बीच का अंतर नहीं पहचान पाता है। इस चरण पर हम कह सकते हैं कि GAN ने सफलतापूर्वक सिंथेटिक डेटा बनाना सीख लिया है। इयान गुडफेलो के मूल पेपर के अनुसार, यह एक गणितीय खेल है जहाँ जनरेटर लॉस फंक्शन को कम करने का प्रयास करता है और डिस्क्रिमिनेटर उसे बढ़ाने का प्रयास करता है।
| विशेषता | GAN | VAE | Autoregressive |
|---|---|---|---|
| डेटा निर्माण की गति | तेज (एक पास में) | तेज | धीमी (क्रमिक) |
| छवि की गुणवत्ता | अत्यंत तीक्ष्ण | थोड़ी धुंधली | अच्छी |
| गणितीय दृष्टिकोण | इम्प्लिसिट (परोक्ष) | एक्सप्लिसिट (प्रत्यक्ष) | एक्सप्लिसिट |
| ट्रेनिंग की कठिनाई | ज्यादा (अस्थिर) | कम | मध्यम |
गणितीय आधार और संभावना के सिद्धांत
GAN के मूल में प्रायिकता सिद्धांत (probability theory) और माप सिद्धांत (measure theory) निहित हैं। गणितीय रूप से देखें तो, जनरेटर एक ऐसा फंक्शन है जो लेटेंट डिस्ट्रीब्यूशन को वास्तविक डेटा डिस्ट्रीब्यूशन में बदलने का प्रयास करता है। स्रोत 1 के अनुसार, इस खेल का ऑब्जेक्टिव फंक्शन (objective function) लॉग-संभावना पर आधारित है। डिस्क्रिमिनेटर यह सुनिश्चित करता है कि वह असली डेटा के लिए अधिकतम मान दे और जनरेटर द्वारा बनाए गए डेटा के लिए न्यूनतम मान दे।
व्यावहारिक रूप से, जब छवियों को बनाने की बात आती है, तब जनरेटर के रूप में 'डीकन्वोल्यूशनल न्यूरल नेटवर्क' (deconvolutional neural network) और डिस्क्रिमिनेटर के रूप में 'कन्वोल्यूशनल न्यूरल नेटवर्क' (convolutional neural network) का उपयोग होता है। ये नेटवर्क पिक्सेल की व्यवस्था और पैटर्न को समझने में बहुत सक्षम होते हैं। GAN की एक विशेषता यह है कि यह 'इम्प्लिसिट जेनरेटिव मॉडल' (implicit generative model) है, जिसका अर्थ है कि यह डेटा की संभावना की सीधे गणना नहीं करता है, बल्कि यह सीखता है कि डेटा कैसे उत्पन्न होता है।

अन्य मॉडल्स के साथ तुलना
GAN की तुलना अन्य मशीन लर्निंग पद्धतियों जैसे 'वेरिएशनल ऑटोएनकोडर्स' (Variational Autoencoders - VAEs) या 'ऑटोरिग्रेसिव मॉडल्स' (Autoregressive models) के साथ की जाती है। VAEs डेटा को संकुचित करके उसे फिर से बनाने का प्रयास करते हैं, जिसके कारण अक्सर परिणामी छवियां थोड़ी धुंधली (blurry) होती हैं। इसकी तुलना में GAN द्वारा बनाई गई छवियां अत्यंत तीक्ष्ण और वास्तविक होती हैं। इसके अलावा, WaveNet जैसे मॉडल्स डेटा को एक-एक करके टुकड़ों में बनाते हैं, जबकि GAN पूरी छवि या डेटा सैंपल को एक साथ (one pass) बना सकता है।
हालांकि, GAN को प्रशिक्षित करना एक चुनौतीपूर्ण कार्य है। अक्सर 'मोड कोलैप्स' (mode collapse) जैसी समस्याएं उत्पन्न होती हैं, जिसमें जनरेटर केवल एक ही प्रकार के नमूने बनाना शुरू कर देता है और विविधता खो देता है। इन समस्याओं को हल करने के लिए StyleGAN-1 और StyleGAN-2 जैसे उन्नत आर्किटेक्चर विकसित किए गए हैं, जो डेटा की विभिन्न विशेषताओं पर बेहतर नियंत्रण प्रदान करते हैं।
सिंथेटिक डेटा का महत्व और भविष्य
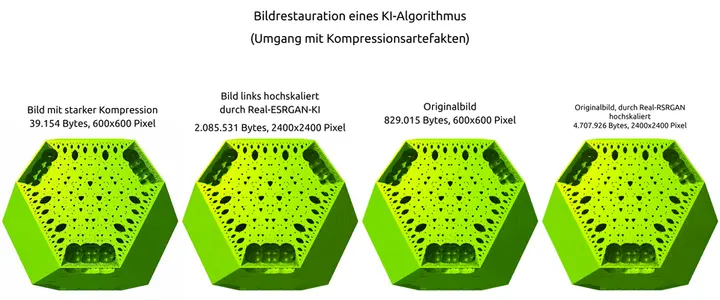
GAN द्वारा तैयार किया जाने वाला सिंथेटिक डेटा आज अनेक क्षेत्रों में क्रांति ला रहा है। चिकित्सा क्षेत्र में, मरीजों की गोपनीयता बनाए रखते हुए शोध करने के लिए GAN द्वारा नकली मेडिकल रिकॉर्ड्स या एक्स-रे इमेजेस तैयार की जाती हैं। कृषि क्षेत्र में, फसल के रोगों को पहचानने के लिए जब डेटा सीमित होता है, तब GAN द्वारा अतिरिक्त डेटा बनाकर मॉडल्स को प्रशिक्षित किया जाता है। खगोल विज्ञान में भी, टेलीस्कोप द्वारा ली गई छवियों में मौजूद नॉइज़ को दूर करने और तारों को अधिक स्पष्ट रूप से पहचानने के लिए इस तकनीक का उपयोग होता है।
भारत जैसे देशों में, जहां विभिन्न भाषाएं और डेटा के प्रकार हैं, वहां GAN का उपयोग स्थानीय भाषाओं की आवाज़ को सिंथेसाइज करने या पुराने दस्तावेजों को डिजिटल रूप में पुनर्स्थापित करने के लिए किया जा सकता है। हालांकि, इस तकनीक का दुरुपयोग 'डीपफेक' (deepfake) बनाने के लिए भी किया जा सकता है, जो एक चिंता का विषय है। फिर भी, विज्ञान और इंजीनियरिंग के दृष्टिकोण से, GAN मानव रचनात्मकता और मशीन लर्निंग के संगम का एक अद्भुत उदाहरण है।
आगामी वर्षों में, जैसे-जैसे कंप्यूटेशनल पावर बढ़ेगी, GAN अधिक सटीक और कुशल बनेंगे। 2026 तक, कई विशेषज्ञों का मानना है कि वेरिएशनल ऑटोएनकोडर्स और GAN के बीच की दूरी कम होगी और हमें अधिक शक्तिशाली जेनरेटिव मॉडल्स देखने को मिलेंगे। इयान गुडफेलो का यह विचार आज केवल एक शोध पत्र नहीं है, बल्कि आधुनिक AI की रीढ़ बन गया है।


