આર્ટિફિશિયલ ઇન્ટેલિજન્સનું એન્જિન: H100 અને આગામી ચિપ્સનું આર્કિટેક્ચર
૮૦ અબજ ટ્રાન્ઝિસ્ટર, ટ્રાન્સફોર્મર એન્જિન અને અતિ-ઝડપી મેમરી કેવી રીતે આજના અદ્યતન એઆઈ મૉડેલ્સને ગતિ આપી રહ્યા છે.
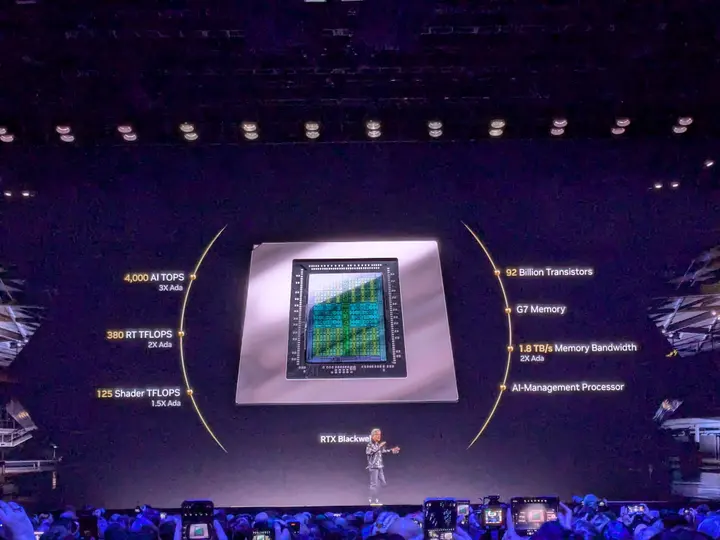
આર્ટિફિશિયલ ઇન્ટેલિજન્સની નવી કરોડરજ્જુ
આજના આધુનિક કમ્પ્યુટિંગ જગતમાં આર્ટિફિશિયલ ઇન્ટેલિજન્સ અને મોટા ભાષા મૉડેલ્સ (Large Language Models) ચલાવવા માટે જે હાર્ડવેરની જરૂર પડે છે, તેમાં ગ્રાફિક્સ પ્રોસેસિંગ યુનિટ એટલે કે GPU સૌથી કેન્દ્રસ્થાને છે. GPU એ હજારો નાની ગણતરીઓ એકસાથે સમાંતર રીતે ઉકેલવા માટે બનાવવામાં આવેલી સિલિકોન ચિપ છે. આ સ્પર્ધામાં NVIDIA કંપનીનું Hopper આર્કિટેક્ચર અને તેના પર આધારિત H100 પ્રોસેસર સમગ્ર વિશ્વમાં ચર્ચાનું કેન્દ્ર બન્યા છે. માર્ચ ૨૦૨૨માં GTC પરિષદ દરમિયાન જાહેર કરાયેલું આ પ્રોસેસર પ્રખ્યાત કમ્પ્યુટર વિજ્ઞાની અને અમેરિકન નૌકાદળના રીઅર એડમિરલ ગ્રેસ હોપર (Grace Hopper) ના નામ પરથી રાખવામાં આવ્યું છે.
આ આર્કિટેક્ચર અગાઉના ટ્યુરિંગ (Turing) અને એમ્પિયર (Ampere) માઇક્રોઆર્કિટેક્ચરની તુલનામાં મોટો ટેકનોલોજીકલ કૂદકો છે. H100 ને ખાસ કરીને ડેટાસેન્ટર્સ અને ક્લાઉડ નેટવર્ક્સમાં અત્યંત જટિલ એઆઈ તાલીમ તેમજ ઇન્ફરન્સ આપવા માટે તૈયાર કરવામાં આવ્યું છે. જ્યારે વિશ્વભરમાં આર્ટિફિશિયલ ઇન્ટેલિજન્સનું મોજું આવ્યું, ત્યારે દરેક મોટી ટેકનોલોજી કંપની આ ચિપ્સ ખરીદવા માટે દોડવા લાગી હતી.

સિલિકોનની રચના અને સ્ટ્રીમિંગ મલ્ટીપ્રોસેસર
હોપર H100 GPU નું નિર્માણ સેમિકન્ડક્ટર ઉત્પાદક TSMC ની અદ્યતન N4 પ્રક્રિયા દ્વારા કરવામાં આવ્યું છે. એક નાનકડી સિલિકોન ડાઇ પર આશરે ૮૦ અબજ ટ્રાન્ઝિસ્ટર (transistors) બેસાડવામાં આવ્યા છે. આ સમગ્ર ચિપમાં ૧૪૪ જેટલા સ્ટ્રીમિંગ મલ્ટીપ્રોસેસર (Streaming Multiprocessors - SM) આવેલા છે. કમ્પ્યુટિંગની ભાષામાં કહીએ તો, સ્ટ્રીમિંગ મલ્ટીપ્રોસેસર એ નાના કમ્પ્યુટેશનલ કારખાના જેવા છે, જ્યાં વાસ્તવિક ગણતરીઓ થાય છે. દરેક SM માં એકસાથે ૬૪ જેટલા વૉર્પ્સ (warps: ૩૨ થ્રેડ્સનો સમાંતર સમૂહ) એકસાથે કાર્યરત રહી શકે છે.
ગણતરીની ક્ષમતા વધારવા માટે H100 માં સિંગલ-પ્રિસિઝન ફ્લોટિંગ પોઇન્ટ (FP32) ક્ષમતા બમણી કરવામાં આવી છે, જે તેના પુરોગામી કરતાં ચક્ર દીઠ બમણી FP32 પ્રક્રિયાઓ પૂર્ણ કરે છે. આ સાથે જ ટેન્સરફ્લોટ-૩૨ (TF-32) ફોર્મેટને પણ સંપૂર્ણ સમર્થન આપવામાં આવ્યું છે. વળી, જૈવિક ગણતરીઓ અને સિક્વન્સ એલાઈનમેન્ટ ઝડપી બનાવવા માટે સ્મિથ-વોટરમેન (Smith–Waterman) અને નીડલમેન-વુન્શ (Needleman–Wunsch) જેવા અલ્ગોરિધમ્સ માટે ખાસ DPX ઇન્સ્ટ્રક્શન્સ SM માં ઉમેરવામાં આવી છે, જેનાથી પ્રોટીન અને જીનોમિક્સ સંશોધનમાં પણ અસાધારણ ઝડપ મળે છે.
- હાઇ પ્રિસિઝન ડેટા ઇનપુટન્યુરલ નેટવર્કના સ્તરોમાંથી ૧૬-બીટ ફ્લોટિંગ પોઇન્ટ (FP16) સ્વરૂપે જટિલ ગાણિતિક ગણતરીઓ દાખલ થાય છે.
- ડાયનેમિક ચોકસાઈ નિયંત્રણટ્રાન્સફોર્મર એન્જિન પરિણામમાં ચોકસાઈનું નુકસાન તપાસીને ડેટાને આપમેળે ૮-બીટ (FP8) ના ઝડપી ફોર્મેટમાં ફેરવે છે.
- અસિંક્રોનસ મેમરી ટ્રાન્સફર (TMA)ટેન્સર મેમરી એક્સિલરેટર મુખ્ય મેમરી અને શેર કરેલી મેમરી વચ્ચે પ્રોસેસર કોરને રોક્યા વગર ૫D ડેટા પહોંચાડે છે.
- સમાંતર ગણતરી અને પરિણામસ્ટ્રીમિંગ મલ્ટીપ્રોસેસર ક્લસ્ટર્સ અતિશય ઊંચી ઝડપે મેટ્રિક્સ ગણતરી પૂર્ણ કરી ગ્લોબલ મેમરીમાં પરિણામ સંગ્રહે છે.
ટ્રાન્સફોર્મર એન્જિન: ગણતરીની નવી કાર્યપદ્ધતિ
H100 ની સૌથી મોટી વિશેષતા તેનું નવું ‘ટ્રાન્સફોર્મર એન્જિન’ (Transformer Engine) છે. આજના મોટાભાગના એઆઈ મૉડેલ્સ ટ્રાન્સફોર્મર નેટવર્ક પર આધારિત છે, જેમાં લાખો-કરોડો ગાણિતિક મેટ્રિક્સ ગુણાકારો થાય છે. અગાઉ આ ગણતરીઓ મુખ્યત્વે ૧૬-બીટ ફ્લોટિંગ પોઇન્ટ (FP16) માં થતી હતી, જે ખૂબ સચોટ પણ ધીમી હતી. હોપર આર્કિટેક્ચરમાં પ્રથમ વખત લાગુ થયેલું ટ્રાન્સફોર્મર એન્જિન ગણતરી દરમિયાન વાસ્તવિક સમયમાં તેનું વિશ્લેષણ કરે છે.
જો મોડેલની ચોકસાઈ પર વિપરીત અસર ન પડતી હોય, તો આ એન્જિન આપમેળે ગણતરીને FP16 માંથી ઘટાડીને ૮-બીટ ફ્લોટિંગ પોઇન્ટ (FP8) ના ઝડપી ફોર્મેટમાં ફેરવી દે છે. આ પ્રક્રિયા દરમિયાન એન્જિન મેન્ટિસા (mantissa) કે એક્સપોનન્ટ (exponent) ને ફાળવેલા બીટ્સનું ડાયનેમિક ગોઠવણ કરે છે જેથી ચોકસાઈ જળવાઈ રહે. આ પદ્ધતિથી મોડેલ શીખવાની અને પરિણામ આપવાની ગતિ અનેક ગણી વધી જાય છે.
TB/s
અતિ-ઝડપી મેમરી અને TMA આર્કિટેક્ચર
પ્રોસેસર ગમે તેટલું ઝડપી હોય, પણ જો તેને મેમરીમાંથી ડેટા ઝડપથી ન મળે, તો તે નકામું બની જાય છે. હોપર H100 માં HBM3 અને HBM2e મેમરીનો ઉપયોગ કરવામાં આવ્યો છે, જે ૮૦ GB સુધીની ક્ષમતા આપે છે. HBM3 મેમરી સિસ્ટમ પ્રતિ સેકન્ડે ૩ ટેરાબાઇટ્સ (3 TB/s) જેટલી અકલ્પનીય બેન્ડવિડ્થ પૂરી પાડે છે, જે અગાઉના Ampere A100 ના ૨ TB/s ની તુલનામાં ૫૦ ટકા વધુ ઝડપી છે.
આ ઝડપને સાથ આપવા માટે હોપરમાં ટેન્સર મેમરી એક્સિલરેટર (TMA) રજૂ કરવામાં આવ્યું છે. TMA ગ્લોબલ મેમરી અને શેર્ડ મેમરી વચ્ચે પ્રોસેસર કોર્સને રોક્યા વગર સીધો ડેટા ટ્રાન્સફર કરી શકે છે, જેમાં ૫D ટેન્સર્સ સુધીના ડેટા પરિમાણો સીધા જ મોકલી શકાય છે. આ પ્રક્રિયાથી રજિસ્ટર અને SM ઇન્સ્ટ્રક્શન્સ પરનો બોજ ઘટી જાય છે. આ ઉપરાંત ચિપમાં સંયુક્ત L1 કેશ, ટેક્સચર કેશ અને શેર્ડ મેમરીની ક્ષમતા વધારીને ૨૫૬ KB કરવામાં આવી છે, જ્યારે L2 કેશમાં આપમેળે ઇનલાઇન કમ્પ્રેશન પણ ઉમેરાયું છે.
| પરિમાણ | સ્પેસિફિકેશન વિગત |
|---|---|
| મેન્યુફેક્ચરિંગ પ્રોસેસ | TSMC N4 પ્રક્રિયા |
| ટ્રાન્ઝિસ્ટર સંખ્યા | ૮૦ અબજ (80 Billion) |
| સ્ટ્રીમિંગ મલ્ટીપ્રોસેસર્સ (SM) | ૧૪૪ સુધી |
| મેમરી સપોર્ટ અને મહત્તમ ક્ષમતા | HBM3 અને HBM2e, ૮૦ GB સુધી |
| મેમરી બેન્ડવિડ્થ | ૩ TB/s (HBM3) |
| L1 કેશ / શેર કરેલી મેમરી | ૨૫૬ KB |
| થર્મલ ડિઝાઇન પાવર (TDP) | ૭૦૦ વોટ (SXM5 મોડલ) |
ક્લસ્ટરિંગ અને હાઇ-પાવર ડિઝાઇનની જરૂરિયાત
મોટા સુપરકમ્પ્યુટર્સ બનાવવા માટે ઘણા બધા થ્રેડ બ્લોક્સને સાથે કામ કરાવવું પડે છે. હોપરમાં થ્રેડ બ્લોક ક્લસ્ટર્સની સુવિધા છે, જેમાં ૮ બ્લોક્સનું પોર્ટેબલ ક્લસ્ટર સામાન્ય રીતે અને ખાસ સૂચનાઓ દ્વારા ૧૬ સુધીનું ક્લસ્ટર બનાવી શકાય છે. આ તમામ પ્રોસેસર્સ વચ્ચે ડેટાની ઝડપી આપ-લે કરવા માટે અદ્યતન NVLink ઇન્ટરકનેક્ટ વપરાય છે.
કાર્યક્ષમતાની દ્રષ્ટિએ SXM5 સોકેટ ધરાવતું H100 મોડલ ૭૦૦ વોટનો થર્મલ ડિઝાઇન પાવર (TDP) ધરાવે છે, જે સામાન્ય PCIe સોકેટ કરતાં વધુ ડેટા બેન્ડવિડ્થ અને ઝડપ આપે છે. NVIDIA એ આ જ ચિપનો ઉપયોગ કરીને Grace Hopper (GH200) મોડ્યુલ પણ તૈયાર કર્યું છે, જેમાં H100 GPU ની સાથે ૭૨-કોર ધરાવતો Grace CPU એક જ બોર્ડ પર જોડાયેલો છે અને આ આખું મોડ્યુલ ૧૦૦૦ વોટ સુધી પાવર વાપરી શકે છે.
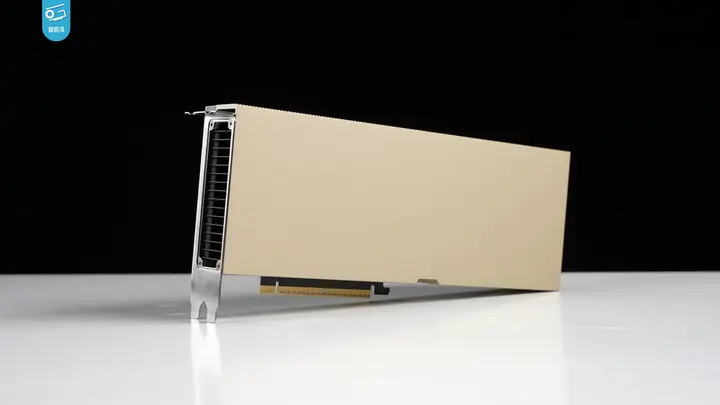
બજારમાં અભૂતપૂર્વ માંગ અને વૈશ્વિક અસરો
૨૦૨૩ અને ૨૦૨૪ દરમિયાન આર્ટિફિશિયલ ઇન્ટેલિજન્સના ઉછાળા વખતે H100 ની અભૂતપૂર્વ ખેંચ ઊભી થઈ હતી. ઓરેકલ કોર્પોરેશનના લેરી એલિસને ખુલાસો કર્યો હતો કે NVIDIA ના સીઈઓ જેન્સેન હુઆંગ સાથેના એક રાત્રિભોજન દરમિયાન તેઓ અને ટેસ્લા તેમજ xAI ના એલોન મસ્ક વધુ H100 ચિપ્સ મેળવવા માટે કરગરી રહ્યા હતા. રેમન્ડ જેમ્સ ફાઇનાન્શિયલના વિશ્લેષકોના જણાવ્યા મુજબ, જાન્યુઆરી ૨૦૨૪ માં NVIDIA દરેક H100 ચિપ $૨૫,૦૦૦ થી $૩૦,૦૦૦ ની કિંમતે વેચી રહી હતી, જ્યારે ઈ-બે (eBay) પર આ ચિપ $૪૦,૦૦૦ થી વધુ કિંમતે વેચાતી હતી. ફેબ્રુઆરી ૨૦૨૪ સુધીમાં આ મૂલ્યવાન ચિપ્સને સશસ્ત્ર વાહનો (armored cars) માં ડેટાસેન્ટર સુધી પહોંચાડવામાં આવતી હતી.
આ દરમિયાન અમેરિકાના નિકાસ નિયંત્રણોને કારણે વૈશ્વિક ભૂરાજકીય ચર્ચાઓ પણ શરૂ થઈ. ચીનના બજાર માટે નિયમોને આધીન H800 અને બાદમાં H20 જેવા સુધારેલા મૉડેલ્સ રજૂ કરવામાં આવ્યા હતા. વર્ષ ૨૦૨૬ ની શરૂઆતમાં Hopper આધારિત H200 ચિપને લઈને વૈશ્વિક વેપાર વિવાદો સર્જાયા, જેમાં અમેરિકાના પ્રમુખ ડોનાલ્ડ ટ્રમ્પની ચીન મુલાકાત દરમિયાન પણ આ નિયંત્રણો ચર્ચાનો વિષય બન્યા હતા. તે સમયે અલીબાબા, ટેન્સન્ટ, બાઇટડાન્સ અને જેડી.કોમ જેવી ચીની કંપનીઓને H200 ખરીદવાની ચોક્કસ મંજૂરીઓ આપવામાં આવી હતી.
આગામી પેઢી: P100 થી B200 સુધીની સફર
કમ્પ્યુટિંગ ઇતિહાસમાં NVIDIA ની એક્સિલરેટર યાત્રા P100 થી શરૂ થઈને V100, A100 અને ત્યારબાદ Hopper H100 સુધી પહોંચી છે. આ શ્રેણીમાં હવે આગળનું મોટું પગલું એટલે Blackwell આર્કિટેક્ચર અને તેની B200 તેમજ ભવિષ્યની R100 ચિપ્સ. Blackwell શ્રેણી Hopper કરતાં પણ વિશાળ કદ અને બહુવિધ ચિપલેટ્સ સાથે એઆઈ વર્કલોડને નવી ઊંચાઈએ લઈ જવાની દિશા દર્શાવે છે.
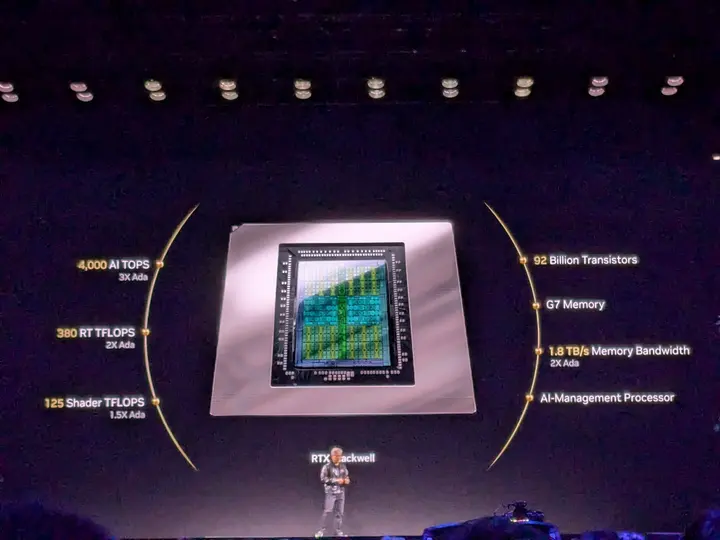
ભારત જેવા દેશોમાં પણ જ્યાં એઆઈ આધારિત ભાષા મોડેલ્સ, હેલ્થકેર અને ડીપ લર્નિંગ રિસર્ચ ઝડપથી વિસ્તરી રહ્યું છે, ત્યાં આવા ડેટાસેન્ટર ગ્રેડ પ્રોસેસર્સની ઉપલબ્ધતા પાયાની જરૂરિયાત બની રહી છે. જેમ જેમ મોડેલ્સ મોટા થઈ રહ્યા છે, તેમ તેમ સિલિકોનની ઝડપ અને ઉર્જા-કાર્યક્ષમતા આગામી દાયકાના વિજ્ઞાન અને અર્થતંત્રનું નિર્દેશન કરશે.

