आर्टिफिशियल इंटेलिजेंस का इंजन: H100 और आगामी चिप्स का आर्किटेक्चर
80 अरब ट्रांजिस्टर, ट्रांसफॉर्मर इंजन और अति-तेज मेमोरी कैसे आज के उन्नत AI मॉडल्स को गति दे रहे हैं।
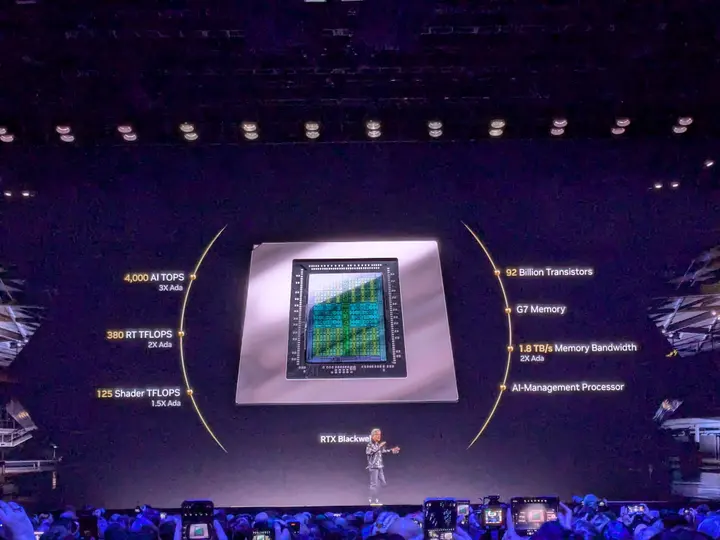
आर्टिफिशल इंटेलिजेंस की नई रीढ़
आज के आधुनिक कंप्यूटिंग जगत में आर्टिफिशल इंटेलिजेंस और बड़े भाषा मॉडल (Large Language Models) चलाने के लिए जिस हार्डवेयर की जरूरत पड़ती है, उसमें ग्राफिक्स प्रोसेसिंग यूनिट यानी GPU सबसे केंद्रस्थान पर है। GPU वह सिलिकॉन चिप है जिसे हजारों छोटी गणनाओं को एक साथ समानांतर रूप से हल करने के लिए बनाया गया है। इस स्पर्धा में NVIDIA कंपनी का Hopper आर्किटेक्चर और उस पर आधारित H100 प्रोसेसर पूरी दुनिया में चर्चा का केंद्र बन गए हैं। मार्च 2022 में GTC कॉन्फ्रेंस के दौरान घोषित यह प्रोसेसर प्रसिद्ध कंप्यूटर विज्ञानी और अमेरिकी नौसेना के रियर एडमिरल ग्रेस हॉपर (Grace Hopper) के नाम पर रखा गया है।
यह आर्किटेक्चर पिछले ट्यूरिंग (Turing) और एम्पीयर (Ampere) माइक्रोआर्किटेक्चर की तुलना में एक बड़ा टेक्नोलॉजिकल छलांग है। H100 को विशेष रूप से डेटासेंटर्स और क्लाउड नेटवर्क्स में अत्यधिक जटिल एआई ट्रेनिंग और इन्फरेंस देने के लिए तैयार किया गया है। जब दुनियाभर में आर्टिफिशल इंटेलिजेंस की लहर आई, तब हर बड़ी टेक्नोलॉजी कंपनी इन चिप्स को खरीदने के लिए दौड़ने लगी थी।

सिलिकॉन की रचना और स्ट्रीमिंग मल्टीप्रोसेसर
हॉपर H100 GPU का निर्माण सेमीकंडक्टर निर्माता TSMC की उन्नत N4 प्रक्रिया द्वारा किया गया है। एक छोटी सी सिलिकॉन डाई पर लगभग 80 अरब ट्रांजिस्टर (transistors) बैठाए गए हैं। इस पूरी चिप में 144 जितने स्ट्रीमिंग मल्टीप्रोसेसर (Streaming Multiprocessors - SM) आए हुए हैं। कंप्यूटिंग की भाषा में कहें तो, स्ट्रीमिंग मल्टीप्रोसेसर छोटे कंप्यूटेशनल कारखाने जैसे हैं, जहाँ वास्तविक गणनाएँ होती हैं। प्रत्येक SM में एक साथ 64 जितने वॉर्प्स (warps: 32 थ्रेड्स का समानांतर समूह) एक साथ कार्यरत रह सकते हैं।
गणना की क्षमता बढ़ाने के लिए H100 में सिंगल-प्रिसिजन फ्लोटिंग पॉइंट (FP32) क्षमता दोगुनी की गई है, जो अपने पूर्ववर्ती की तुलना में चक्र प्रति चक्र दोगुनी FP32 प्रक्रियाएं पूरी करती है। इसके साथ ही टेंसरफ्लोट-32 (TF-32) फॉर्मेट को भी पूरा समर्थन दिया गया है। साथ ही, जैविक गणनाओं और सीक्वेंस एलाइनमेंट को तेज बनाने के लिए स्मिथ-वॉटरमैन (Smith–Waterman) और नीडलमैन-वुन्श (Needleman–Wunsch) जैसे एल्गोरिदम के लिए विशेष DPX इंस्ट्रक्शंस SM में जोड़ी गई हैं, जिससे प्रोटीन और जिनोमिक्स अनुसंधान में भी असाधारण गति मिलती है।
- हाई प्रिसिजन डेटा इनपुटन्यूरल नेटवर्क के स्तरों से १६-बिट फ्लोटिंग पॉइंट (FP16) रूप में जटिल गणितीय गणनाएं दाखिल होती हैं।
- डायनेमिक चोकसाई नियंत्रणट्रांसफॉर्मर इंजन परिणाम में शुद्धता का नुकसान जाँचकर डेटा को अपने आप ८-बीट (FP8) के तेज़ फॉर्मेट में बदलता है।
- असिंक्रोनस मेमोरी ट्रांसफर (TMA)टेन्सर मेमोरी एक्सीलरेटर मुख्य मेमोरी और शेयर की गई मेमोरी के बीच प्रोसेसर कोर को रोके बिना ५D डेटा पहुँचाता है।
- समान्तर गणना और परिणामस्ट्रीमिंग मल्टीप्रोसेसर क्लस्टर्स अत्यधिक ऊँची रफ़्तार से मैट्रिक्स गणना पूर्ण कर ग्लोबल मेमोरी में परिणाम संगृहीत करते हैं।
ट्रांसफॉर्मर इंजन: गणना की नई कार्यपद्धति
H100 की सबसे बड़ी विशेषता इसका नया ‘ट्रांसफॉर्मर इंजन’ (Transformer Engine) है। आज के अधिकांश एआई मॉडल ट्रांसफॉर्मर नेटवर्क पर आधारित हैं, जिसमें लाखों-करोड़ों गणितीय मैट्रिक्स गुणा होते हैं। पहले ये गणनाएं मुख्य रूप से 16-बिट फ्लोटिंग पॉइंट (FP16) में होती थीं, जो बहुत सटीक लेकिन धीमी थीं। हॉपर आर्किटेक्चर में पहली बार लागू हुआ ट्रांसफॉर्मर इंजन गणना के दौरान वास्तविक समय में उसका विश्लेषण करता है।
यदि मॉडल की सटीकता पर कोई प्रतिकूल प्रभाव न पड़े, तो यह इंजन स्वचालित रूप से गणना को FP16 से घटाकर 8-बिट फ़्लोटिंग पॉइंट (FP8) के तेज़ फ़ॉर्मेट में बदल देता है। इस प्रक्रिया के दौरान इंजन सटीकता बनाए रखने के लिए मैंटिसा (mantissa) या एक्सपोनेंट (exponent) को आवंटित किए गए बिट्स का गतिशील समायोजन करता है। इस पद्धति से मॉडल के सीखने और परिणाम देने की गति कई गुना बढ़ जाती है।
TB/s
अति-तेज मेमोरी और TMA आर्किटेक्चर
प्रोसेसर चाहे कितना भी तेज़ हो, लेकिन यदि उसे मेमोरी से डेटा तेज़ी से न मिले, तो वह व्यर्थ हो जाता है। हॉपर H100 में HBM3 और HBM2e मेमोरी का उपयोग किया गया है, जो 80 GB तक की क्षमता देती है। HBM3 मेमोरी सिस्टम प्रति सेकंड 3 टेराबाइट्स (3 TB/s) जितनी अविश्वसनीय बैंडविड्थ प्रदान करती है, जो पिछले Ampere A100 के 2 TB/s की तुलना में 50 प्रतिशत अधिक तेज़ है।
इस गति का साथ देने के लिए हॉपर में टेंसर मेमोरी एक्सीलरेटर (TMA) पेश किया गया है। TMA ग्लोबल मेमोरी और शेर्ड मेमोरी के बीच प्रोसेसर कोर को रोके बिना सीधा डेटा ट्रांसफर कर सकता है, जिसमें 5D टेंसर तक के डेटा आयाम सीधे भेजे जा सकते हैं। इस प्रक्रिया से रजिस्टर और SM इंस्ट्रक्शन पर का बोझ कम हो जाता है। इसके अलावा चिप में संयुक्त L1 कैश, टेक्सचर कैश और शेर्ड मेमोरी की क्षमता बढ़ाकर 256 KB कर दी गई है, जबकि L2 कैश में स्वचालित रूप से इनलाइन कम्प्रेशन भी जोड़ा गया है.
| परिमाण | स्पेसिफिकेशन्स डिटेल |
|---|---|
| मैन्युफैक्चरिंग प्रोसेस | TSMC N4 प्रक्रिया |
| ट्रांजिस्टर संख्या | ८० अरब (80 Billion) |
| स्ट्रीमिंग मल्टीप्रोसेसर्स (SM) | १४४ तक |
| मेमोरी सपोर्ट और अधिकतम क्षमता | HBM3 और HBM2e, ८० GB तक |
| मेमोरी बैंडविड्थ | ३ TB/s (HBM3) |
| L1 कैश / शेयर की गई मेमोरी | २५६ KB |
| थर्मल डिज़ाइन पावर (TDP) | ७०० वॉट (SXM5 मॉडल) |
क्लस्टरिंग और हाई-पावर डिज़ाइन की आवश्यकता
बड़े सुपरकंप्यूटर बनाने के लिए बहुत सारे थ्रेड ब्लॉक को एक साथ काम कराना पड़ता है। हॉपर में थ्रेड ब्लॉक क्लस्टर की सुविधा है, जिसमें 8 ब्लॉक का पोर्टेबल क्लस्टर सामान्य रूप से और विशेष निर्देशों द्वारा 16 तक का क्लस्टर बनाया जा सकता है। इन सभी प्रोसेसर के बीच डेटा के तेज़ आदान-प्रदान के लिए उन्नत NVLink इंटरकनेक्ट का उपयोग किया जाता है।
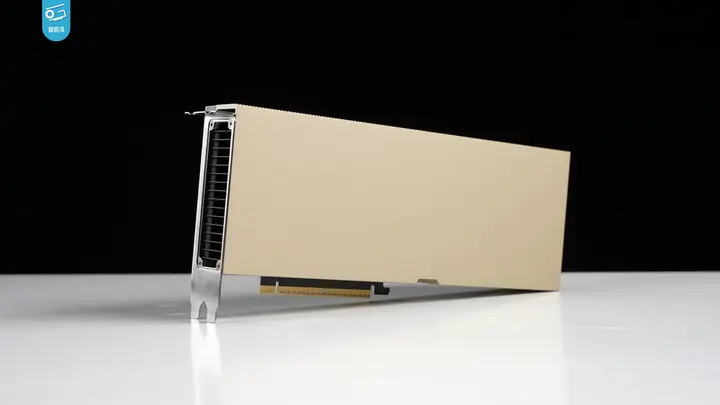
कार्यक्षमता की दृष्टि से SXM5 सॉकेट वाला H100 मॉडल 700 वॉट का थर्मल डिज़ाइन पावर (TDP) रखता है, जो सामान्य PCIe सॉकेट की तुलना में अधिक डेटा बैंडविड्थ और गति देता है। NVIDIA ने इसी चिप का उपयोग करके Grace Hopper (GH200) मॉड्यूल भी तैयार किया है, जिसमें H100 GPU के साथ 72-कोर वाला Grace CPU एक ही बोर्ड पर जुड़ा हुआ है और यह पूरा मॉड्यूल 1000 वॉट तक पावर की खपत कर सकता है।
बाजार में अभूतपूर्व मांग और वैश्विक प्रभाव
२०२३ और २०२४ के दौरान आर्टिफिशियल इंटेलिजेंस के उभार के समय H100 की अभूतपूर्व कमी पैदा हुई थी। ओरेकल कॉरपोरेशन के लैरी एलिसन ने खुलासा किया था कि NVIDIA के सीईओ जेनसेन ह्वांग के साथ एक रात्रिभोज के दौरान वे और टेस्ला तथा xAI के एलन मस्क अधिक H100 चिप्स प्राप्त करने के लिए गिड़गिड़ा रहे थे। रेमंड जेम्स फाइनेंशियल के विश्लेषकों के अनुसार, जनवरी २०२४ में NVIDIA प्रत्येक H100 चिप $२५,००० से $३०,००० की कीमत पर बेच रही थी, जबकि ई-बे (eBay) पर यह चिप $४०,००० से अधिक कीमत पर बिकती थी। फरवरी २०२४ तक इन मूल्यवान चिप्स को बख्तरबंद वाहनों (armored cars) में डेटासेंटर तक पहुँचाया जाता था।
इस दौरान अमेरिका के निर्यात नियंत्रणों के कारण वैश्विक भू-राजनीतिक चर्चाएँ भी शुरू हुईं। चीन के बाज़ार के लिए नियमों के अधीन H800 और बाद में H20 जैसे संशोधित मॉडल पेश किए गए थे। वर्ष २०२६ की शुरुआत में Hopper आधारित H200 चिप को लेकर वैश्विक व्यापार विवाद पैदा हुए, जिसमें अमेरिका के राष्ट्रपति डोनाल्ड ट्रंप की चीन यात्रा के दौरान भी ये नियंत्रण चर्चा का विषय बने थे। उस समय अलीबाबा, टेंसेंट, बाइटडांस और जेडी.कॉम जैसी चीनी कंपनियों को H200 खरीदने की निश्चित अनुमतियाँ दी गई थीं।
आगामी पीढ़ी: P100 से B200 तक का सफर
कंप्यूटिंग इतिहास में NVIDIA की एक्सीलेटर यात्रा P100 से शुरू होकर V100, A100 और उसके बाद Hopper H100 तक पहुँची है। इस श्रृंखला में अब अगला बड़ा कदम यानी Blackwell आर्किटेक्चर और उसकी B200 तथा भविष्य की R100 चिप्स। Blackwell श्रृंखला Hopper से भी विशाल आकार और बहुविध चिपलेट्स के साथ एआई वर्कलोड को नई ऊँचाई पर ले जाने की दिशा दर्शाती है।
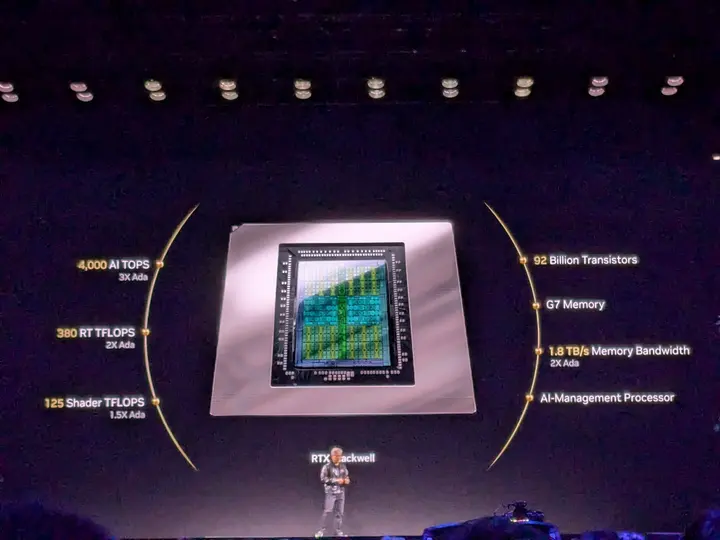
भारत जैसे देशों में भी जहाँ एआई आधारित भाषा मॉडल, हेल्थकेयर और डीप लर्निंग रिसर्च तेज़ी से फैल रही है, वहाँ ऐसे डेटासेंटर ग्रेड प्रोसेसर की उपलब्धता बुनियादी ज़रूरत बनती जा रही है। जैसे-जैसे मॉडल बड़े हो रहे हैं, वैसे-वैसे सिलिकॉन की गति और ऊर्जा-कार्यक्षमता आगामी दशक के विज्ञान और अर्थव्यवस्था का निर्देशन करेगी।

