આર્ટિફિશિયલ ઇન્ટેલિજન્સની ગતિ વધારતા હાર્ડવેર એક્સિલરેટર્સ: TPU અને NPUની આંતરિક આર્કિટેક્ચર અને કાર્યપદ્ધતિ
સીપીયુ અને જીપીયુની મર્યાદાઓ પાર કરીને સિસ્ટોલિક એરે અને લો-પ્રિસિઝન કમ્પ્યુટિંગ દ્વારા એઆઈ મોડેલ્સને અતિ ઝડપી બનાવતા સ્પેશિયલાઇઝ્ડ ચિપ્સનું ઊંડું વિશ્લેષણ.
એઆઈ કમ્પ્યુટિંગમાં નવો વળાંક: TPU અને NPU શા માટે જરૂરી બન્યા?
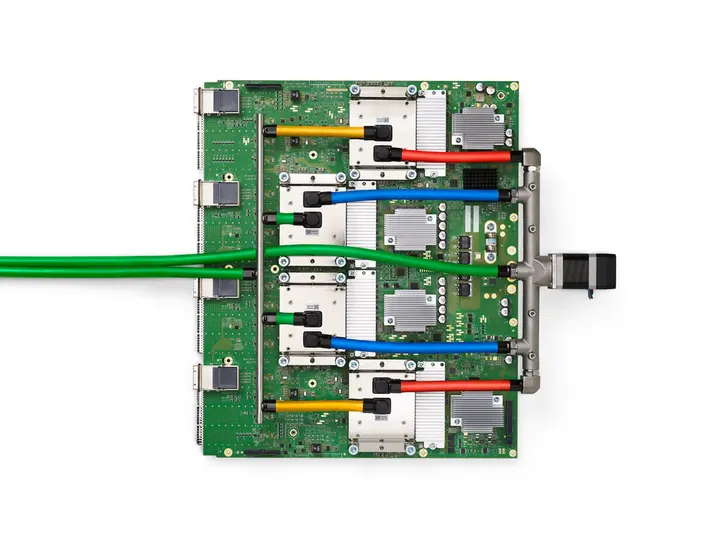
આધુનિક કૃત્રિમ બુદ્ધિમત્તા (AI) ના યુગમાં પરંપરાગત સેન્ટ્રલ પ્રોસેસિંગ યુનિટ (CPU) અને ગ્રાફિક્સ પ્રોસેસિંગ યુનિટ (GPU) પરનું કમ્પ્યુટેશનલ ભારણ અતિશય વધી ગયું છે. મશીન લર્નિંગ અને ડીપ લર્નિંગ મોડેલ્સને સક્ષમતાથી ચલાવવા માટે ખાસ પ્રકારના હાર્ડવેર એક્સિલરેટર્સ (hardware accelerators) ની જરૂરિયાત ઉભી થઈ. આ જરૂરિયાતમાંથી ન્યુરલ પ્રોસેસિંગ યુનિટ (neural processing unit - NPU) અને ટેન્સર પ્રોસેસિંગ યુનિટ (tensor processing unit - TPU) જેવા સ્પેશિયલાઇઝ્ડ એપ્લિકેશન-સ્પેસિફિક ઇન્ટિગ્રેટેડ સર્કિટ (application-specific integrated circuit - ASIC) નો જન્મ થયો. ગૂગલે ૨૦૧૫ માં પોતાના ડેટા સેન્ટરોમાં આંતરિક રીતે TPU નો ઉપયોગ શરૂ કર્યો હતો અને ૨૦૧૮ માં તેને ક્લાઉડ ઇન્ફ્રાસ્ટ્રક્ચર દ્વારા અન્ય કંપનીઓ માટે ઉપલબ્ધ કરાવ્યો હતો.
ગૂગલમાં કસ્ટમ સિલિકોન વિકાસના સ્થાપક અમીર સાલેક (Amir Salek) ના નેતૃત્વમાં મૂળ TPU, TPUv2, TPUv3, TPUv4 અને એજ-TPU નો વિકાસ થયો હતો. તે જ રીતે, નોર્મન પી. જુપ્પી (Norman P. Jouppi) ના ટેકનિકલ નેતૃત્વ હેઠળ ગૂગલે માત્ર ૧૫ મહિનાના ટૂંકા ગાળામાં પ્રથમ TPU નું ડિઝાઇનિંગ અને ડિપ્લોયમેન્ટ પૂરું કર્યું હતું. ૨૦૧૭ ના ISCA કોન્ફરન્સમાં રજૂ કરાયેલા સંશોધન પત્ર મુજબ, પ્રથમ પેઢીના TPU એ સમકાલીન CPU અને GPU ની તુલનામાં ૧૫ થી ૩૦ ગણું વધુ પરફોર્મન્સ અને ૩૦ થી ૮૦ ગણું વધુ પરફોર્મન્સ-પર-વોટ (વોટ દીઠ કાર્યક્ષમતા) હાંસલ કર્યું હતું.
ગણું વધુ
ટીપીયુ ખાસ કરીને ટેન્સ૨ફ્લો (TensorFlow), જેએક્સ (JAX) અને પાઇટોર્ચ (PyTorch) જેવા સોફ્ટવેર ફ્રેમવર્ક્સ માટે અનુકૂળ બનાવવામાં આવ્યા છે. ગૂગલે તેનો ઉપયોગ આલ્ફાગો (AlphaGo), આલ્ફાઝીરો (AlphaZero), ગૂગલ સ્ટ્રીટ વ્યુ ટેક્સ્ટ પ્રોસેસિંગ, ગૂગલ ફોટોઝ (જ્યાં એક ચિપ રોજના ૧૦૦ મિલિયનથી વધુ ફોટોઝ પ્રોસેસ કરી શકે છે) અને રેન્કબ્રેન (RankBrain) જેવા જટિલ પ્રોજેક્ટ્સમાં સફળતાપૂર્વક કર્યો છે.
સિસ્ટોલિક એરે અને કમ્પ્યુટેશનલ આર્કિટેક્ચર: આ ચિપ્સ કેવી રીતે કામ કરે છે?
પરંપરાગત પ્રોસેસર્સની સરખામણીએ TPU અને NPU નો મુખ્ય તફાવત તેમની આંતરિક કમ્પ્યુટેશનલ ડિઝાઇન છે. આ ચિપ્સ હાઇ-વોલ્યુમ અને લો-પ્રિસિઝન કમ્પ્યુટેશન (low-precision computation) માટે ડિઝાઇન કરવામાં આવી છે, જેમ કે ૮-બિટ ગણતરીઓ. તેમાં રાસ્ટરાઇઝેશન કે ટેક્સચર મેપિંગ માટેના વિશિષ્ટ હાર્ડવેર હોતા નથી, પરંતુ તે જ્યુલ દીઠ વધુ ઇનપુટ/આઉટપુટ ઓપરેશન્સ આપવા પર ધ્યાન કેન્દ્રિત કરે છે.
ટીપીયુ આર્કિટેક્ચરનું હૃદય 'સિસ્ટોલિક એરે' (systolic array) છે. ગૂગલના મૂળ એન્જિનિયર અને ગ્રોક (Groq) ના સ્થાપક જોનાથન રોસ (Jonathan Ross) ના જણાવ્યા મુજબ, ગૂગલમાં એઆઈ એક્સિલરેટર માટે ત્રણ અલગ અલગ જૂથો કામ કરી રહ્યા હતા, જેમાંથી સિસ્ટોલિક એરે ડિઝાઇન શ્રેષ્ઠ સાબિત થઈ હતી. આ આર્કિટેક્ચરમાં ડેટા હૃદયના ધબકારાની જેમ પ્રોસેસિંગ એલિમેન્ટ્સના ગ્રીડમાંથી સતત વહે છે, જેથી મેમરીમાંથી વારંવાર ડેટા વાંચવા કે લખવાની જરૂર પડતી નથી.
- ડેટા ઇનપુટડેટા પ્રોસેસિંગ એલિમેન્ટ્સના ગ્રીડમાં એકસાથે દાખલ થાય છે.
- પાઇપલાઇન પ્રોસેસિંગડેટા હૃદયના ધબકારાની જેમ એક એલિમેન્ટમાંથી બીજામાં સતત વહે છે.
- મેમરી બચતડેટા વારંવાર મેમરીમાં લખવા કે વાંચવાને બદલે ચિપની અંદર જ પ્રોસેસ થાય છે.
- ૧. ઇનપુટ ટ્રાન્સફરહોસ્ટ પ્રોસેસર PCIe બસ મારફતે ડેટા અને મશીન લર્નિંગ ઇન્સ્ટ્રક્શન્સ TPU ને મોકલે છે.
- ૨. સિસ્ટોલિક એરે પ્રોસેસિંગડેટા ૨૫૬×૨૫૬ ના મલ્ટિપ્લાયર ગ્રીડમાંથી પસાર થાય છે જ્યાં સમાંતર ગણતરી થાય છે.
- ૩. એક્યુમ્યુલેશન૩૨-બિટ એક્યુમ્યુલેટર્સ ગણતરીના મધ્યવર્તી પરિણામોને એકઠા કરે છે.
- ૪. એક્ટિવેશન અને આઉટપુટએક્ટિવેશન ફંક્શન લાગુ કરીને અંતિમ પ્રોસેસ્ડ ડેટા હોસ્ટ સિસ્ટમને પાછો મોકલવામાં આવે છે.
મશીન લર્નિંગ મોડેલ્સમાં અલગ અલગ પ્રોસેસર્સનો ઉપયોગ અલગ રીતે થાય છે. ટીપીયુ કન્વોલ્યુશનલ ન્યુરલ નેટવર્ક્સ (CNNs) માટે ખૂબ અનુકૂળ છે, જ્યારે જીપીયુ ફુલ્લી કનેક્ટેડ નેટવર્ક્સ માટે અને સીપીયુ રિકરન્ટ ન્યુરલ નેટવર્ક્સ (RNNs) માટે વધુ યોગ્ય રહે છે. લાર્જ લેંગ્વેજ મોડેલ્સ (LLMs) માં ટ્રાન્સફોર્મર નેટવર્ક્સ માટે સામાન્ય રીતે ઇન્ફરન્સ (અનુમાન) માટે TPU અને ટ્રેનિંગ માટે GPU નો ઉપયોગ થતો આવ્યો છે.
ગૂગલ TPU ની આઠ પેઢીઓની વિકાસયાત્રા અને ટેકનિકલ સ્પષ્ટીકરણો
ગૂગલ TPU ની પ્રથમ પેઢી ૨૮ એનએમ (28 nm) પ્રોસેસ પર આધારિત ૮-બિટ મેટ્રિક્સ મલ્ટિપ્લિકેશન એન્જિન હતી, જેનું ડાઇ સાઇઝ ૩૩૧ એમએમ² કે તેથી ઓછું હતું. તે ૭૦૦ એમએચઝેડ (700 MHz) ક્લોક સ્પીડ અને ૨૮ થી ૪૦ વોટ પાવર પર ચાલતી હતી. તેમાં ૨૮ એમઆઈબી (MiB) ઓન-ચિપ મેમરી અને ૨૫૬×૨૫૬ સિસ્ટોલિક એરે માટે ૪ એમઆઈબી ના ૩૨-બિટ એક્યુમ્યુલેટર્સ હતા, સાથે ૩૪ જીબી/સે બેન્ડવિડ્થ ધરાવતી ૮ જીઆઈબી (GiB) DDR3 મેમરી હતી.
મે ૨૦૧૭ માં જાહેર કરાયેલી બીજી પેઢી (TPU v2) માં મેમરી બેન્ડવિડ્થ વધારવા માટે ૧૬ જીબી (GB) હાઇ બેન્ડવિડ્થ મેમરી (High Bandwidth Memory - HBM) નો ઉપયોગ કરાયો, જેથી બેન્ડવિડ્થ ૬૦૦ જીબી/સે અને પરફોર્મન્સ ૪૫ ટેરાફ્લોપ્સ (teraFLOPS) સુધી પહોંચ્યું. તેમાં ગૂગલ બ્રેઇન દ્વારા શોધાયેલ bfloat16 ફોર્મેટ રજૂ કરાયું, જેથી તે ટ્રેનિંગ અને ઇન્ફરન્સ બંને માટે ઉપયોગી બન્યું. ૨૫૬-ચિપના પોડ (pod) માં તેનું પરફોર્મન્સ ૧૧.૫ પેટાફ્લોપ્સ (petaFLOPS) હતું.
| ચિપનું નામ | પ્રોસેસ ટેકનોલોજી / મેમરી | પાવર વપરાશ | મુખ્ય ઉપયોગ |
|---|---|---|---|
| TPU Gen 1 | 28 nm / 8 GiB DDR3 | 28–40 W | ઇન્ફરન્સ (8-bit) |
| TPU Gen 2 | 16 GB HBM | અનઉલ્લેખિત | ટ્રેનિંગ અને ઇન્ફરન્સ |
| Edge TPU | ઓન-ચિપ / સિંગલ મોડ્યુલ | 2 W | એજ આઈઓટી ડિવાઇસ (4 TOPS) |
| TPU 8t | 216 GB HBM3e | લિક્વિડ કૂલ્ડ | લાર્જ-સ્કેલ પ્રી-ટ્રેનિંગ |
| TPU 8i | 288 GB HBM3e + 384 MB SRAM | લિક્વિડ કૂલ્ડ | હાઇ-સ્પીડ સર્વિંગ અને એજન્ટ્સ |
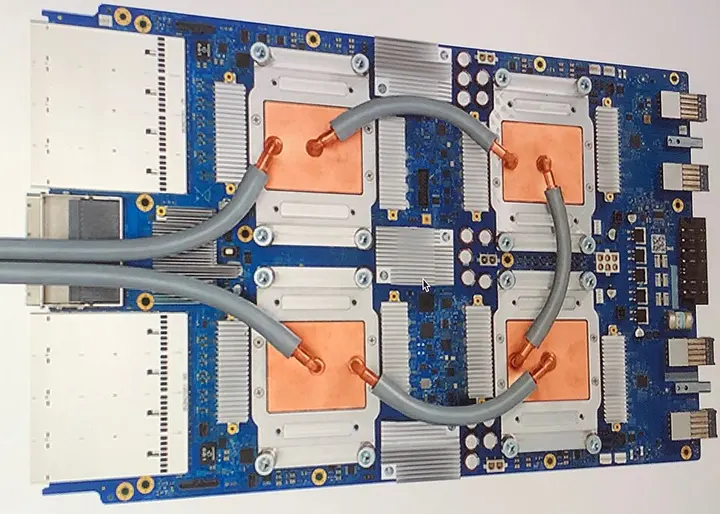
આ વિકાસયાત્રા આગળ વધીને ૨૦૨૬ માં આઠમી પેઢી સુધી પહોંચી છે. ૨૨ એપ્રિલ ૨૦૨૬ ના રોજ ગૂગલે TPU 8t (ટ્રેનિંગ) અને TPU 8i (ઇન્ફરન્સ) ચિપ્સ જાહેર કરી. TPU 8t મોડેલ ૧૨.૬ FP4 PFLOPs નું પરફોર્મન્સ અને ૨૧૬ જીબી HBM3e મેમરી ધરાવે છે, જે વર્ગો (Virgo) નેટવર્ક ફેબ્રિક દ્વારા ૯,૬૦૦ ચિપ્સ સુધી સ્કેલ થઈને ૧૨૧ FP4 ExaFLOPs પરફોર્મન્સ આપે છે. બીજી તરફ TPU 8i ચિપ ૧૦.૧ FP4 PFLOPs અને ૨૮૮ જીબી HBM3e મેમરી તેમજ ૩૮૪ એમબી SRAM ધરાવે છે. ગૂગલના તમામ TPU મોડેલ્સના ઉત્પાદનમાં બોડકોમ (Broadcom) અને ટીએસએમસી (TSMC) ની મહત્વની ભૂમિકા રહી છે.
કન્ઝ્યુમર ડિવાઇસ અને એજ કમ્પ્યુટિંગમાં NPU નું મહત્વ
ડેટા સેન્ટરો ઉપરાંત, NPU નો ઉપયોગ સ્માર્ટફોન, લેપટોપ અને એજ ડિવાઇસિસમાં વ્યાપકપણે વધી રહ્યો છે. જુલાઈ ૨૦૧૮ માં ગૂગલે એજ ટીપીયુ (Edge TPU) ની જાહેરાત કરી હતી, જે ૨ વોટ વીજળી પર પ્રતિ સેકન્ડ ૪ ટ્રિલિયન ઓપરેશન્સ (4 TOPS) કરવાની ક્ષમતા ધરાવે છે. તે ટેન્સ૨ફ્લો લાઇટ (TensorFlow Lite) અને ૮-બિટ ગણતરી પર કામ કરે છે. અસૂસ (Asus) એ Tinker Edge T અને Tinker Edge R જેવા સિંગલ-બોર્ડ કમ્પ્યુટર્સમાં આ ટેકનોલોજીનો ઉપયોગ કર્યો છે.
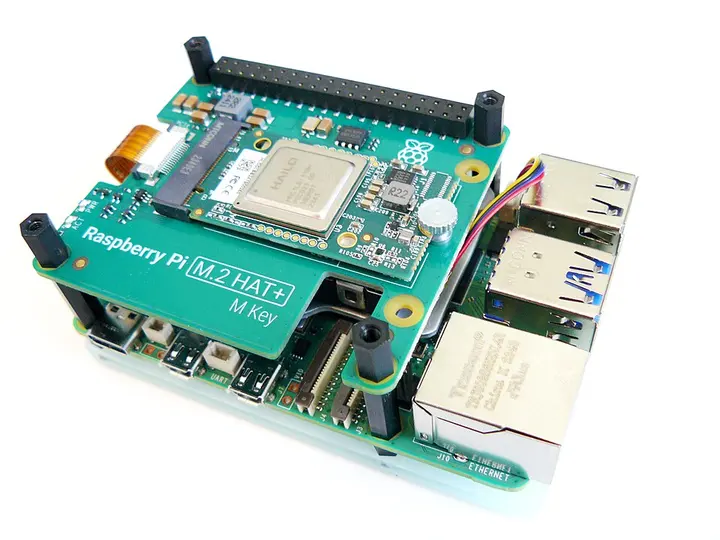
કન્ઝ્યુમર ડિવાઇસિસમાં એપલ સિલિકોન, ક્વોલકોમ, સેમસંગ, હાઇવેઇ અને ગૂગલ ટેન્સ૨ પ્રોસેસર્સમાં NPU બિલ્ટ-ઇન હોય છે. ગ્રાફિક્સ રેન્ડરિંગમાં NPU નો ઉપયોગ કરીને ૫૪૦p રિઝોલ્યુશન (૩૦ fps) માં રેન્ડર થયેલા દ્રશ્યને રિયલ-ટાઇમમાં ૨૧૬૦p (૨૪૦ fps) માં અપસ્કેલ કરી શકાય છે, જેનાથી મુખ્ય GPU નો પાવર વપરાશ ઘટે છે. ઇન્ટેલના મેટોર લેક (Meteor Lake) પ્રોસેસર્સમાં વિઝન પ્રોસેસિંગ માટે VPU સમાવવામાં આવ્યા છે.
વૈજ્ઞાનિક ગણતરીઓમાં પણ NPU નો ઉપયોગ વધી રહ્યો છે. ઓઝાકી સ્કીમ (Ozaki scheme) નો ઉપયોગ કરીને લો-પ્રિસિઝન (FP16 અથવા INT8) NPU પર ઉચ્ચ પ્રિસિઝન (FP64) ગણતરીઓનું અનુકરણ કરી શકાય છે. એનવીડિયા કન્ઝ્યુમર જીપીયુ પર આ પદ્ધતિથી ૬ ગણી ઝડપ નોંધાઈ છે. આ ક્ષેત્રમાં સોફ્ટવેર ડેવલપમેન્ટ સરળ બનાવવા માટે ક્રોનોસ ગ્રુપ (Khronos Group) દ્વારા OpenCL, Vulkan, અને SPIR-V જેવા ઓપન સ્ટાન્ડર્ડ્સ વિકસાવવામાં આવી રહ્યા છે.


