आर्टिफिशियल इंटेलिजेंस की गति बढ़ाते हार्डवेयर एक्सेलरेटर्स: TPU और NPU की आंतरिक आर्किटेक्चर और कार्यपद्धति
CPU और GPU की सीमाओं को पार करके सिस्टोलिक एरे और लो-प्रिसिजन कंप्यूटिंग के माध्यम से AI मॉडल्स को अति तीव्र बनाने वाली स्पेशलाइज्ड चिप्स का गहन विश्लेषण।
एआई कंप्यूटिंग में नया मोड़: TPU और NPU क्यों जरूरी बन गए?
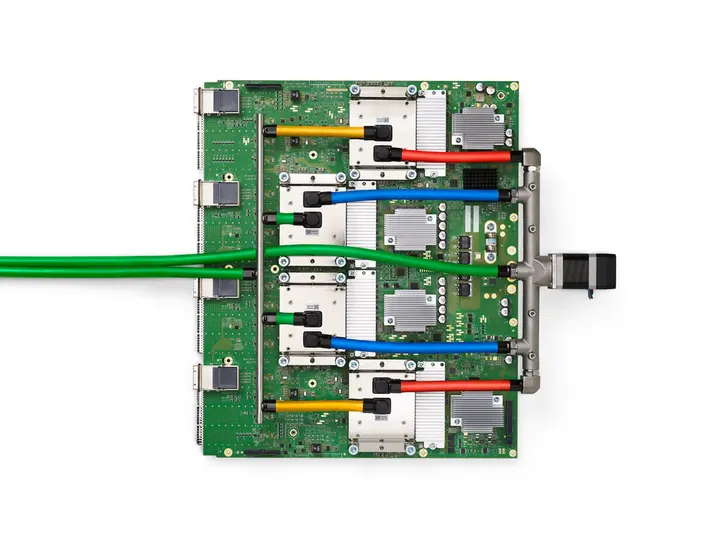
आधुनिक कृत्रिम बुद्धिमत्ता (AI) के युग में पारंपरिक सेंट्रल प्रोसेसिंग यूनिट (CPU) और ग्राफिक्स प्रोसेसिंग यूनिट (GPU) पर कंप्यूटेशनल भार अत्यधिक बढ़ गया है। मशीन लर्निंग और डीप लर्निंग मॉडल्स को कुशलतापूर्वक चलाने के लिए विशेष प्रकार के हार्डवेयर एक्सेलेरेटर्स (hardware accelerators) की आवश्यकता उत्पन्न हुई। इस आवश्यकता से न्यूरल प्रोसेसिंग यूनिट (neural processing unit - NPU) और टेंसर प्रोसेसिंग यूनिट (tensor processing unit - TPU) जैसे स्पेशलाइज्ड एप्लीकेशन-स्पेसिफिक इंटीग्रेटेड सर्किट (application-specific integrated circuit - ASIC) का जन्म हुआ। गूगल ने 2015 में अपने डेटा सेंटरों में आंतरिक रूप से TPU का उपयोग शुरू किया था और 2018 में इसे क्लाउड इंफ्रास्ट्रक्चर के माध्यम से अन्य कंपनियों के लिए उपलब्ध कराया था।
गूगल में कस्टम सिलिकॉन विकास के संस्थापक अमीर सालेक (Amir Salek) के नेतृत्व में मूल TPU, TPUv2, TPUv3, TPUv4 और एज-TPU का विकास हुआ था। इसी तरह, नॉर्मन पी. जुप्पी (Norman P. Jouppi) के तकनीकी नेतृत्व में गूगल ने मात्र 15 महीने की अल्प अवधि में पहले TPU की डिजाइनिंग और डिप्लॉयमेंट पूरी की थी। 2017 के ISCA कॉन्फ्रेंस में प्रस्तुत शोध पत्र के अनुसार, पहली पीढ़ी के TPU ने समकालीन CPU और GPU की तुलना में 15 से 30 गुना अधिक परफॉरमेंस और 30 से 80 गुना अधिक परफॉरमेंस-पर-वॉट (वॉट प्रति कार्यक्षमता) हासिल किया था।
ગણું વધુ
TPU विशेष रूप से टेंसरफ्लो (TensorFlow), JAX और पाइटॉर्च (PyTorch) जैसे सॉफ्टवेयर फ्रेमवर्क्स के लिए अनुकूल बनाए गए हैं। गूगल ने इनका उपयोग अल्फागो (AlphaGo), अल्फाजीरो (AlphaZero), गूगल स्ट्रीट व्यू टेक्स्ट प्रोसेसिंग, गूगल फोटोज (जहाँ एक चिप प्रतिदिन 100 मिलियन से अधिक फोटोज प्रोसेस कर सकती है) और रैंकब्रेन (RankBrain) जैसे जटिल प्रोजेक्ट्स में सफलतापूर्वक किया है।
सिस्टोलिक एरे और कंप्यूटेशनल आर्किटेक्चर: ये चिप्स कैसे काम करती हैं?
पारंपरिक प्रोसेसर्स की तुलना में TPU और NPU का मुख्य अंतर उनकी आंतरिक कंप्यूटेशनल डिजाइन है। ये चिप्स हाई-वॉल्यूम और लो-प्रिसिजन कंप्यूटेशन (low-precision computation) के लिए डिजाइन की गई हैं, जैसे कि 8-बिट गणनाएं। इनमें रास्टराइजेशन या टेक्सचर मैपिंग के लिए विशिष्ट हार्डवेयर नहीं होते हैं, लेकिन ये जूल प्रति अधिक इनपुट/आउटपुट ऑपरेशंस देने पर ध्यान केंद्रित करती हैं।
TPU आर्किटेक्चर का हृदय 'सिस्टोलिक एरे' (systolic array) है। गूगल के मूल इंजीनियर और ग्रोक (Groq) के संस्थापक जोनाथन रॉस (Jonathan Ross) के अनुसार, गूगल में एआई एक्सेलेरेटर के लिए तीन अलग-अलग समूह काम कर रहे थे, जिनमें से सिस्टोलिक एरे डिजाइन सर्वश्रेष्ठ साबित हुई थी। इस आर्किटेक्चर में डेटा हृदय की धड़कन की तरह प्रोसेसिंग एलिमेंट्स के ग्रिड से निरंतर बहता है, जिससे मेमोरी से बार-बार डेटा पढ़ने या लिखने की आवश्यकता नहीं पड़ती है।
- डेटा इनपुटडेटा प्रोसेसिंग एलिमेंट्स के ग्रिड में एक साथ प्रवेश करता है।
- पाइपलाइन प्रोसेसिंगडेटा दिल की धड़कन की तरह एक एलिमेंट से दूसरे में लगातार बहता है।
- मेमोरी बचतडेटा बार-बार मेमोरी में लिखने या पढ़ने के बजाय चिप के अंदर ही प्रोसेस होता है।
- 1. इनपुट ट्रांसफरहोस्ट प्रोसेसर PCIe बस के माध्यम से डेटा और मशीन लर्निंग इंस्ट्रक्शन्स TPU को भेजता है।
- 2. सिस्टोलिक एरे प्रोसेसिंगडेटा 256×256 के मल्टीप्लायर ग्रिड से गुजरता है जहां समानांतर गणना होती है।
- 3. एक्यूमुलेशन32-बिट एक्यूमुलेटर्स गणना के मध्यवर्ती परिणामों को इकट्ठा करते हैं।
- 4. एक्टिवेशन और आउटपुटएक्टिवेशन फंक्शन लागू करके अंतिम प्रोसेस्ड डेटा होस्ट सिस्टम को वापस भेजा जाता है।
मशीन लर्निंग मॉडल्स में अलग-अलग प्रोसेसर्स का उपयोग अलग तरह से किया जाता है। टीपीयू (TPU) कन्वेन्शनल न्यूरल नेटवर्क्स (CNNs) के लिए बहुत अनुकूल हैं, जबकि जीपीयू (GPU) फुली कनेक्टेड नेटवर्क्स के लिए और सीपीयू (CPU) रिकरंट न्यूरल नेटवर्क्स (RNNs) के लिए अधिक उपयुक्त रहते हैं। लार्ज लैंग्वेज मॉडल्स (LLMs) में ट्रांसफॉर्मर नेटवर्क्स के लिए सामान्यतः इन्फरेंस (अनुमान) के लिए TPU और ट्रेनिंग के लिए GPU का उपयोग होता आया है।
गूगल TPU की आठ पीढ़ियों की विकासयात्रा और तकनीकी स्पष्टीकरण
गूगल TPU की प्रथम पीढ़ी 28 nm प्रोसेस पर आधारित 8-बिट मैट्रिक्स मल्टिप्लिकेशन इंजन थी, जिसका डाई साइज 331 mm² या उससे कम था। यह 700 MHz क्लॉक स्पीड और 28 से 40 वॉट पावर पर चलती थी। इसमें 28 MiB ऑन-चिप मेमोरी और 256×256 सिस्टोलिक एरे के लिए 4 MiB के 32-बिट एक्युमुलेटर्स थे, साथ ही 34 GB/s बैंडविड्थ वाली 8 GiB DDR3 मेमोरी थी।
मई 2017 में घोषित की गई दूसरी पीढ़ी (TPU v2) में मेमोरी बैंडविड्थ बढ़ाने के लिए 16 GB हाई बैंडविड्थ मेमोरी (High Bandwidth Memory - HBM) का उपयोग किया गया, जिससे बैंडविड्थ 600 GB/s और परफॉरमेंस 45 टेराफ्लॉप्स (teraFLOPS) तक पहुंच गई। इसमें गूगल ब्रेन द्वारा खोजी गई bfloat16 फॉर्मेट पेश की गई, जिससे यह ट्रेनिंग और इन्फरेंस दोनों के लिए उपयोगी बन गई। 256-चिप के पॉड (pod) में इसका परफॉरमेंस 11.5 पेटाफ्लॉप्स (petaFLOPS) था।
| चिप का नाम | प्रोसेस टेक्नोलॉजी / मेमोरी | पावर खपत | मुख्य उपयोग |
|---|---|---|---|
| TPU Gen 1 | 28 nm / 8 GiB DDR3 | 28–40 W | इन्फरेंस (8-bit) |
| TPU Gen 2 | 16 GB HBM | अनुल्लिखित | ट्रेनिंग और इन्फरेंस |
| Edge TPU | ऑन-चिप / सिंगल मॉड्यूल | 2 W | एज आईओटी डिवाइस (4 TOPS) |
| TPU 8t | 216 GB HBM3e | लिक्विड कूल्ड | लार्ज-स्केल प्री-ट्रेनिंग |
| TPU 8i | 288 GB HBM3e + 384 MB SRAM | लिक्विड कूल्ड | हाई-स्पीड सर्विंग और एजेंट्स |
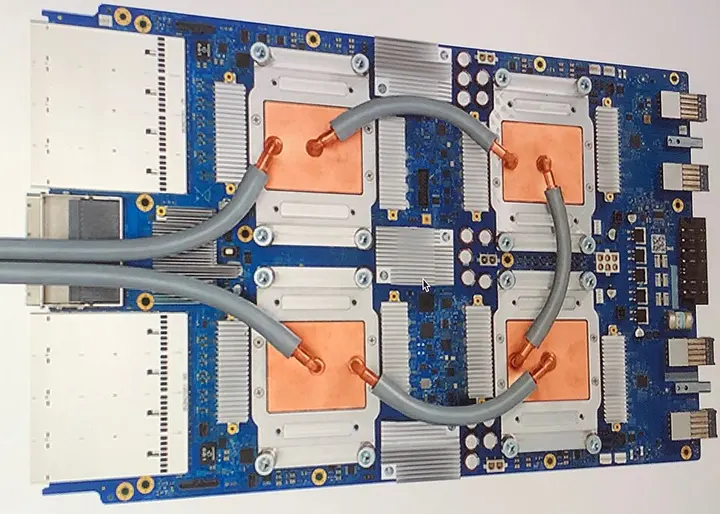
यह विकासयात्रा आगे बढ़कर 2026 में आठवीं पीढ़ी तक पहुंच गई है। 22 अप्रैल 2026 को गूगल ने TPU 8t (ट्रेनिंग) और TPU 8i (इन्फरेंस) चिप्स घोषित कीं। TPU 8t मॉडल 12.6 FP4 PFLOPs का परफॉरमेंस और 216 GB HBM3e मेमोरी रखता है, जो वर्गो (Virgo) नेटवर्क फैब्रिक द्वारा 9,600 चिप्स तक स्केल होकर 121 FP4 ExaFLOPs परफॉरमेंस देता है। दूसरी ओर TPU 8i चिप 10.1 FP4 PFLOPs और 288 GB HBM3e मेमोरी तथा 384 MB SRAM रखती है। गूगल के सभी TPU मॉडल्स के उत्पादन में ब्रॉडकॉम (Broadcom) और टीएसएमसी (TSMC) की महत्वपूर्ण भूमिका रही है।
कंज्यूमर डिवाइस और एज कंप्यूटिंग में NPU का महत्व
डेटा सेंटरों के अलावा, NPU का उपयोग स्मार्टफोन, लैपटॉप और एज डिवाइसेस में व्यापक रूप से बढ़ रहा है। जुलाई 2018 में गूगल ने एज टीपीयू (Edge TPU) की घोषणा की थी, जो 2 वॉट बिजली पर प्रति सेकंड 4 ट्रिलियन ऑपरेशन्स (4 TOPS) करने की क्षमता रखता है। यह टेंसॉरफ्लो लाइट (TensorFlow Lite) और 8-बिट गणना पर काम करता है। आसुस (Asus) ने Tinker Edge T और Tinker Edge R जैसे सिंगल-बोर्ड कंप्यूटर्स में इस टेक्नोलॉजी का उपयोग किया है।
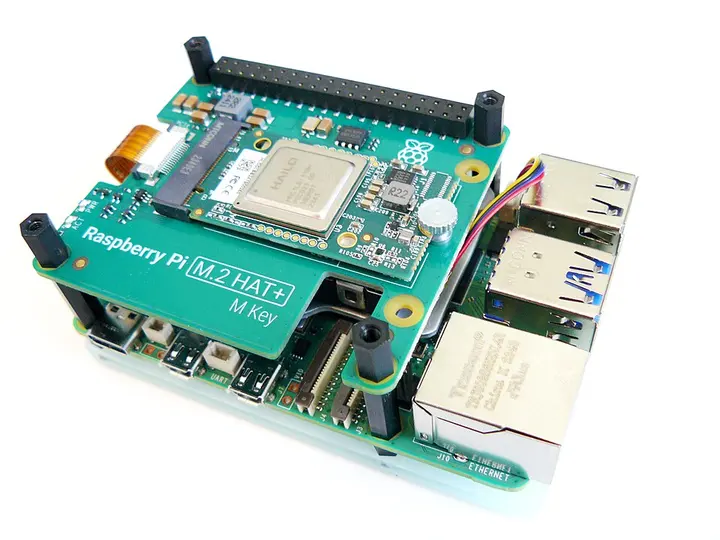
कंज्यूमर डिवाइसेस में एप्पल सिलिकॉन, क्वालकॉम, सैमसंग, हुआवेई और गूगल टेंसर प्रोसेसर्स में NPU बिल्ट-इन होते हैं। ग्राफिक्स रेंडरिंग में NPU का उपयोग करके 540p रिज़ॉल्यूशन (30 fps) में रेंडर किए गए दृश्य को रियल-टाइम में 2160p (240 fps) में अपस्केल किया जा सकता है, जिससे मुख्य GPU का पावर उपभोग घटता है। इंटेल के मेटोर लेक (Meteor Lake) प्रोसेसर्स में विज़न प्रोसेसिंग के लिए VPU शामिल किए गए हैं।
वैज्ञानिक गणनाओं में भी NPU का उपयोग बढ़ रहा है। ओज़ाकी स्कीम (Ozaki scheme) का उपयोग करके लो-प्रिसिजन (FP16 या INT8) NPU पर उच्च प्रिसिजन (FP64) गणनाओं का अनुकरण किया जा सकता है। एनवीडिया कंज्यूमर जीपीयू पर इस पद्धति से 6 गुनी गति दर्ज की गई है। इस क्षेत्र में सॉफ्टवेयर डेवलपमेंट सरल बनाने के लिए क्रोनोस ग्रुप (Khronos Group) द्वारा OpenCL, Vulkan, और SPIR-V जैसे ओपन स्टैंडर्ड्स विकसित किए जा रहे हैं।


