કૃત્રિમ ન્યુરલ નેટવર્કમાં મેમરીની ક્રાંતિ: આરએનએનથી લઈને એલએસટીએમ સુધીની ટેકનિકલ સફર
સમય આધારિત ડેટા અને માનવ ભાષા સમજવા માટે ન્યુરલ નેટવર્કમાં રીકરન્ટ કનેક્શન્સ અને ગેટિંગ મિકેનિઝમ કેવી રીતે કાર્ય કરે છે તેની વિસ્તૃત સમજૂતી.
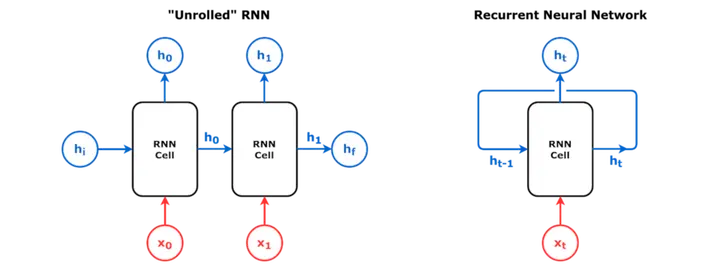
કૃત્રિમ ન્યુરલ નેટવર્ક્સ (Artificial Neural Networks)ના ક્ષેત્રમાં પરંપરાગત ફીડફોરવર્ડ ન્યુરલ નેટવર્ક્સ (feedforward neural networks) દરેક ઇનપુટને એકબીજાથી સ્વતંત્ર રીતે પ્રોસેસ કરે છે. પરંતુ જ્યારે ટેક્સ્ટ, અવાજ અથવા ટાઇમ સિરીઝ (time series) જેવા ક્રમિક ડેટા (sequential data) પર કામ કરવાનું હોય, ત્યારે ઘટકોનો ક્રમ અત્યંત મહત્વનો બની જાય છે. આ જરૂરિયાત પૂરી કરવા માટે રીકરન્ટ ન્યુરલ નેટવર્ક્સ (Recurrent Neural Networks - RNN) વિકસાવવામાં આવ્યા હતા. આરએનએન પોતાના અગાઉના સમય સ્ટેપના આઉટપુટને વર્તમાન સમય સ્ટેપના ઇનપુટ સાથે સાંકળીને એક પ્રકારની આંતરિક મેમરી જાળવી રાખે છે.
આરએનએનનો મૂળભૂત ઘટક રીકરન્ટ યુનિટ (recurrent unit) છે, જે એક હિડન સ્ટેટ (hidden state) ધરાવે છે. આ હિડન સ્ટેટ વર્તમાન ઇનપુટ અને અગાઉના હિડન સ્ટેટના આધારે સતત અપડેટ થતી રહેતી મેમરી તરીકે કામ કરે છે. ગણિતીય રીતે જોઈએ તો, આરએનએન એક એવું વિધેય છે જે ઇનપુટ વેક્ટર xt અને હિડન વેક્ટર ht ને પ્રોસેસ કરીને નવું આઉટપુટ yt અને આગામી સમય સ્ટેપ માટેનું હિડન વેક્ટર ht+1 આપે છે. આ ફીડબેક મિકેનિઝમ મોડેલને ભૂતકાળના ઇનપુટ્સમાંથી શીખીને વર્તમાન પ્રોસેસિંગમાં તેનો ઉપયોગ કરવાની શક્તિ આપે છે.
આરએનએન આધારિત મોડેલ્સને મુખ્યત્વે બે ભાગમાં વિભાજિત કરી શકાય છે: કોન્ફિગરેશન અને આર્કિટેક્ચર. જ્યારે વિવિધ આરએનએનને ડેટા ફ્લોમાં જોડવામાં આવે છે તેને કોન્ફિગરેશન કહેવાય છે, અને દરેક આરએનએન પોતે ચોક્કસ આર્કિટેક્ચર ધરાવે છે. ઊંડાણપૂર્વક પ્રોસેસિંગ કરવા માટે સ્ટેક્ડ આરએનએન (Stacked RNN) અથવા ડીપ આરએનએનનો ઉપયોગ થાય છે, જેમાં એક કરતા વધુ આરએનએન લેયર્સને એકબીજા પર ગોઠવવામાં આવે છે. લેયર ૧ ઇનપુટ x0,t અને હિડન સ્ટેટ h1,t ને મેળવીને x1,t અને નવું હિડન સ્ટેટ h1,t+1 ઉત્પન્ન કરે છે, જે આગળના લેયર માટે ઇનપુટ તરીકે કાર્ય કરે છે.
આરએનએન કેવી રીતે કાર્ય કરે છે: તબક્કાવાર પ્રક્રિયા
આરએનએનની કાર્યપદ્ધતિને સમજવા માટે તેને સમયના વિવિધ તબક્કાઓમાં વિસ્તારિત (unfolded in time) કરીને જોવું પડે છે. દરેક સમય સ્ટેપ પર મોડેલ સમાન પેરામીટર્સ અને વજન (weights) નો ઉપયોગ કરીને શ્રેણીબદ્ધ ગણતરીઓ કરે છે.
- ઇનપુટ અને હિડન સ્ટેટનું ગ્રહણવર્તમાન સમય સ્ટેપ t પર નવું ઇનપુટ xt અને અગાઉના સમય સ્ટેપ t-1 નું હિડન સ્ટેટ ht-1 પ્રાપ્ત કરવામાં આવે છે.
- વેઇટેડ ગણતરી અને રૂપાંતરણઇનપુટ અને અગાઉના મેમરી સ્ટેટ પર વેઇટ મેટ્રિક્સ અને બાયસ લાગુ કરીને નોન-લિનિયર એક્ટિવેશન ફંક્શન દ્વારા પ્રક્રિયા થાય છે.
- હિડન સ્ટેટનું અપડેટનવી ગણતરીના આધારે વર્તમાન સમયનું હિડન સ્ટેટ ht અપડેટ થાય છે, જે આગામી સમય સ્ટેપ માટે મેમરી તરીકે કાર્ય કરે છે.
- આઉટપુટ જનરેશનવર્તમાન હિડન સ્ટેટ આધારિત ચોક્કસ પ્રિડિક્શન અથવા પરિણામ yt જનરેટ કરીને મોડેલ આગળ વધે છે.
પ્રથમ તબક્કામાં, નેટવર્ક વર્તમાન સમય સ્ટેપનો ડેટા અને ભૂતકાળની યાદગીરી મેળવે છે. બીજા તબક્કામાં, તે માહિતી પર વજન અને બાયસ (bias) લગાવીને નોન-લિનિયર રૂપાંતરણ કરે છે. ત્રીજા તબક્કામાં, મેળવેલા પરિણામથી હિડન સ્ટેટ અપડેટ થાય છે અને ચોથા તબક્કામાં તે સમય સ્ટેપનું આઉટપુટ જનરેટ થાય છે.
ન્યુરોસાયન્સ અને આંકડાકીય મિકેનિક્સથી લઈને મોર્ડન આર્કિટેક્ચર સુધીનો ઈતિહાસ
રીકરન્ટ ન્યુરલ નેટવર્કના મૂળ ન્યુરોસાયન્સમાં રહેલા છે. જીવવિજ્ઞાનમાં "રીકરન્ટ" શબ્દ લૂપ જેવી શારીરિક રચનાઓ માટે વપરાય છે. ૧૯૦૧માં કાહાલે (Cajal) સેરેબેલર કોર્ટેક્સમાં રીકરન્ટ અર્ધવર્તુળો જોયા હતા. ત્યારબાદ ૧૯૩૩માં લોરેન્ટે ડી નો (Lorente de Nó) એ રીકરન્ટ સંબંધો શોધી કાઢ્યા અને પ્રસ્તાવ મૂક્યો કે ઉત્તેજક લૂપ્સ વેસ્ટિબ્યુલો-ઓક્યુલર રિફ્લેક્સને સ્પષ્ટ કરે છે. ૧૯૪૦ના દાયકામાં હેબ (Hebb) નામના વિજ્ઞાનીએ ટૂંકા ગાળાની મેમરીની સમજૂતી માટે "રિવર્બરેટિંગ સર્કિટ" નો વિચાર રજૂ કર્યો. ૧૯૪૩માં મકાલોચ અને પિટ્સ (McCulloch and Pitts) ના પેપરમાં સાયકલ ધરાવતા નેટવર્ક્સનો ઉલ્લેખ હતો, જે ભૂતકાળની પ્રવૃત્તિઓથી પ્રભાવિત થઈ શકતા હતા.
૧૯૬૦માં ફ્રેન્ક રોસેનબ્લાટે (Frank Rosenblatt) "ક્લોઝ્ડ-લૂપ ક્રોસ-કપલ્ડ પર્સેપ્ટ્રોન્સ" પર સંશોધન પ્રકાશિત કર્યું. તેમણે ૧૯૬૧માં દર્શાવ્યું કે સંપૂર્ણપણે ક્રોસ-કપલ્ડ પર્સેપ્ટ્રોન નેટવર્ક અનાંત ઊંડાઈ ધરાવતા ફીડફોરવર્ડ નેટવર્ક સમાન છે. આ પછી ૧૯૭૧માં કાઓરુ નાકાનો (Kaoru Nakano), ૧૯૭૨માં શુન-ઈચી અમારી (Shun'ichi Amari) અને ૧૯૭૪માં વિલિયમ એ. લિટલ (William A. Little) દ્વારા સમાન નેટવર્ક્સ રજૂ કરવામાં આવ્યા હતા. આ ક્ષેત્રમાં આંકડાકીય મિકેનિક્સ (statistical mechanics) નું પણ મોટું યોગદાન રહ્યું. ૧૯૨૦ના દાયકામાં વિલહેલ્મ લેન્ઝ અને અર્ન્સ્ટ ઇસિંગ દ્વારા ઇસિંગ મોડેલ (Ising model) વિકસાવવામાં આવ્યું હતું. ૧૯૮૨માં જોન હોપફિલ્ડે (John Hopfield) બાઈનરી એક્ટિવેશન ફંક્શન ધરાવતા હોપફિલ્ડ નેટવર્ક (Hopfield network) નો અભ્યાસ કરવા આ સિદ્ધાંતો લાગુ કર્યા અને ૧૯૮૪માં તેને કન્ટીન્યુઅસ એક્ટિવેશન ફંક્શન સુધી વિસ્તૃત કર્યું.
વર્ષ
૧૯૮૦ના દાયકામાં ન્યુરલ નેટવર્ક્સના પુનરુત્થાન દરમિયાન બે મહત્વના આર્કિટેક્ચર સામે આવ્યા: ૧૯૮૬માં માઈકલ આઈ. જોર્ડન દ્વારા જોર્ડન નેટવર્ક (Jordan network) અને ૧૯૯૦માં જેફરી ઈલ્મેન દ્વારા ઈલ્મેન નેટવર્ક (Elman network). ત્યાર બાદ ૧૯૯૭માં માઈક શુસ્ટર અને કુલદીપ કે. પાલીવાલે બાયડાયરેક્શનલ રીકરન્ટ ન્યુરલ નેટવર્ક્સ (BRNNs) રજૂ કર્યા, જે સિક્વન્સને આગળ અને પાછળ બંને દિશામાં પ્રોસેસ કરતા હતા.
વેનિશિંગ ગ્રેડિએન્ટની સમસ્યા અને એલએસટીએમ (LSTM) નો ઉદ્ભવ
પરંપરાગત આરએનએન મોડેલ્સ જ્યારે લાંબી શ્રેણીઓ (long sequences) પર તાલીમ પામે છે, ત્યારે તેઓ વેનિશિંગ ગ્રેડિએન્ટ પ્રોબ્લેમ (vanishing gradient problem) નો સામનો કરે છે. જ્યારે બેક-પ્રોપેગેશન થ્રુ ટાઇમ (back-propagation through time) દ્વારા મોડેલને ટ્રેન કરવામાં આવે છે, ત્યારે લાંબા ગાળાના ગ્રેડિએન્ટ્સ ખૂબ નાની સંખ્યાઓના ગુણાકારને કારણે શૂન્યની નજીક પહોંચી જાય છે. આના કારણે મોડેલ ભૂતકાળની દૂરની માહિતી યાદ રાખી શકતું નથી અને શીખવાનું બંધ કરી દે છે.
આ ગંભીર મર્યાદાને દૂર કરવા માટે ૧૯૯૭માં સેપ હોચરેઇટર (Sepp Hochreiter) અને જુર્ગન શ્મિડહુબર (Jürgen Schmidhuber) દ્વારા લોંગ શોર્ટ-ટર્મ મેમરી (Long Short-Term Memory - LSTM) આર્કિટેક્ચર રજૂ કરવામાં આવ્યું. એલએસટીએમ એવું મિકેનિઝમ પૂરું પાડે છે જે હજારો ટાઇમ સ્ટેપ્સ સુધી ગ્રેડિયન્ટને ઘટ્યા વિના વહેવા દે છે. આનાથી નેટવર્ક એ શીખી શકે છે કે કઈ માહિતી લાંબા સમય સુધી યાદ રાખવી અને કઈ માહિતી ભૂલી જવી.
ઉદાહરણ તરીકે, કુદરતી ભાષા પ્રોસેસિંગ (Natural Language Processing) માં, "Dave, as a result of his controversial claims, is now a pariah" વાક્ય પ્રોસેસ કરતી વખતે એલએસટીએમ મોડેલ મુખ્ય કર્તા 'Dave' નું લિંગ અને વચન યાદ રાખે છે જેથી આગળ આવતા સર્વનામ 'his' અને ક્રિયાપદ 'is' સાથે યોગ્ય વ્યાકરણ જાળવી શકાય. ક્રિયાપદ 'is' આવી ગયા પછી મોડેલ તે માહિતીની જરૂરિયાત પૂરી થઈ હોવાનું સમજીને તેને દૂર કરી શકે છે.
એલએસટીએમનું આંતરિક બંધારણ અને ગણિતીય સમીકરણો
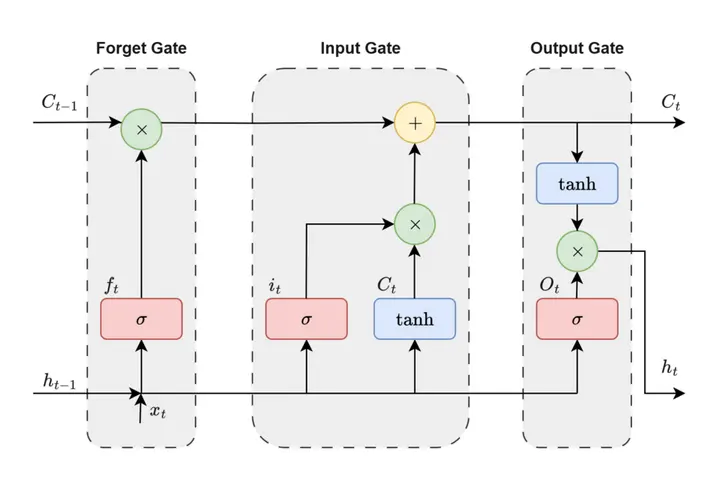
એક એલએસટીએમ યુનિટ મુખ્યત્વે એક મેમરી સેલ (cell) અને ત્રણ ગેટ્સ (gates) થી બનેલું હોય છે: ફોર્ગેટ ગેટ (forget gate), ઇનપુટ ગેટ (input gate) અને આઉટપુટ ગેટ (output gate). આ ગેટ્સ સેલની અંદર માહિતીના પ્રવાહને નિયંત્રિત કરવાનું કામ કરે છે.
ફોર્ગેટ ગેટ અગાઉના સ્ટેટમાંથી કઈ માહિતી કાઢી નાખવી તે નક્કી કરે છે. તે સિગ્મોઇડ ફંક્શન (sigmoid function) નો ઉપયોગ કરીને ૦ થી ૧ ની વચ્ચે મૂલ્ય આપે છે, જ્યાં ૦ એટલે માહિતી સંપૂર્ણ ભૂલી જવી અને ૧ એટલે સંપૂર્ણ યાદ રાખવી. ઇનપુટ ગેટ નવી કઈ માહિતી સેલ સ્ટેટમાં ઉમેરવી તે નક્કી કરે છે. આઉટપુટ ગેટ વર્તમાન સેલ સ્ટેટમાંથી કઈ માહિતી બહાર મોકલવી તેનું નિયંત્રણ કરે છે.
| ગેટ / ઘટક | ગણિતીય સમીકરણ | મુખ્ય કાર્ય |
|---|---|---|
| ફોર્ગેટ ગેટ (ft) | ft = σg(Wf xt + Uf ht-1 + bf) | અગાઉના સ્ટેટમાંથી કઈ માહિતી કાઢી નાખવી તે નક્કી કરે છે (૦ થી ૧) |
| ઇનપુટ ગેટ (it) | it = σg(Wi xt + Ui ht-1 + bi) | વર્તમાન ઇનપુટમાંથી કઈ નવી માહિતી સંગ્રહિત કરવી તે નક્કી કરે છે |
| કેન્ડિડેટ સ્ટેટ (c~t) | c~t = σc(Wc xt + Uc ht-1 + bc) | સેલ સ્ટેટમાં ઉમેરવા માટેના નવા ઉમેદવાર મૂલ્યો બનાવે છે |
| સેલ સ્ટેટ (ct) | ct = ft ⊙ ct-1 + it ⊙ c~t | જૂની મેમરી ભુલાવી નવી મેમરી ઉમેરીને મુખ્ય સ્ટેટ અપડેટ કરે છે |
| આઉટપુટ ગેટ (ot) | ot = σg(Wo xt + Uo ht-1 + bo) | સેલ સ્ટેટમાંથી કઈ માહિતી આઉટપુટ તરીકે મોકલવી તે નક્કી કરે છે |
એલએસટીએમ સેલમાં થતી ગણતરીના ફોરવર્ડ પાસના વેક્ટર સમીકરણો નીચે મુજબ છે. અહીં σg સિગ્મોઇડ એક્ટિવેશન ફંક્શન દર્શાવે છે અને ⊙ ચિહ્ન હેડામાર્ડ પ્રોડક્ટ (Hadamard product - એલિમેન્ટ-વાઇઝ ગુણાકાર) દર્શાવે છે:
ફોર્ગેટ ગેટ: ft = σg(Wf xt + Uf ht-1 + bf) ઇનપુટ ગેટ: it = σg(Wi xt + Ui ht-1 + bi) આઉટપુટ ગેટ: ot = σg(Wo xt + Uo ht-1 + bo) કેન્ડિડેટ સેલ સ્ટેટ: c~t = σc(Wc xt + Uc ht-1 + bc) નવું સેલ સ્ટેટ: ct = ft ⊙ ct-1 + it ⊙ c~t નવું હિડન સ્ટેટ: ht = ot ⊙ σh(ct)
અહીં શરૂઆતના મૂલ્યો c0 = ૦ અને h0 = ૦ હોય છે. ડબ્લ્યુ (W) અને યુ (U) મેટ્રિક્સ અનુક્રમે ઇનપુટ અને રીકરન્ટ કનેક્શન્સના વજન (weights) દર્શાવે છે.
એડવાન્સ વિનિયોગ, બાયડાયરેક્શનલ મોડેલ્સ અને ટ્રાન્સફોર્મર યુગ
૨૦૦૦ના દાયકાના મધ્યમાં બાયડાયરેક્શનલ આર્કિટેક્ચરને એલએસટીએમ સાથે જોડવામાં આવ્યું. બાયડાયરેક્શનલ એલએસટીએમ (Bi-LSTM) મોડેલ્સે સ્પીચ રેકગ્નિશન (speech recognition) અને ટેક્સ્ટ-ટુ-સ્પીચ ક્ષેત્રે ક્રાંતિકારી પરિણામો આપ્યા અને ગૂગલ વોઈસ સર્ચ (Google voice search) માં તેનો વ્યાપક ઉપયોગ થયો. ૨૦૧૦માં ટોમાશ માઇકોલોવ (Tomáš Mikolov) અને તેમના સાથીઓએ દર્શાવ્યું કે આરએનએન આધારિત લેંગ્વેજ મોડેલ્સ પરંપરાગત n-gram મોડેલ્સ કરતા વધુ સારું પરિણામ આપે છે.

૨૦૧૪માં ક્યુંગહ્યુન ચો (Kyunghyun Cho) અને તેમની ટીમે મશીન ટ્રાન્સલેશન માટે આરએનએન એન્કોડર-ડીકોડર (RNN encoder-decoder) પ્રસ્તાવિત કર્યું. આ જ વર્ષે એલએસટીએમનો ઉપયોગ કરીને સિક્વન્સ-ટુ-સિક્વન્સ (sequence-to-sequence) લર્નિંગ દર્શાવવામાં આવ્યું. આ શોધે એટેન્શન મિકેનિઝમ (attention mechanisms) ના વિકાસમાં પાયાની ભૂમિકા ભજવી.
બાદમાં ગેટિડ રીકરન્ટ યુનિટ (Gated Recurrent Unit - GRU) જેવા વધુ કાર્યક્ષમ વિકલ્પો પણ આવ્યા. તાજેતરના વર્ષોમાં, સેલ્ફ-એટેન્શન (self-attention) પર આધારિત ટ્રાન્સફોર્મર્સ (Transformers) મોડેલ્સે કુદરતી ભાષા પ્રોસેસિંગમાં આઈઆરએનએનનું સ્થાન લીધું છે કારણ કે તે સમાંતર પ્રોસેસિંગ (parallel processing) માં શ્રેષ્ઠ છે. છતાં પણ, જ્યાં રિયલ-ટાઇમ પ્રોસેસિંગ અને કમ્પ્યુટેશનલ કાર્યક્ષમતા અત્યંત જરૂરી હોય તેવા ઉપકરણો પર આરએનએન અને એલએસટીએમ આજે પણ મહત્વપૂર્ણ ભૂમિકા ભજવી રહ્યા છે.


