कृत्रिम न्यूरल नेटवर्क में मेमोरी की क्रांति: आरएनएन से लेकर एलएसटीएम तक की तकनीकी यात्रा
समय-आधारित डेटा और मानव भाषा को समझने के लिए न्यूरल नेटवर्क में रीकरेंट कनेक्शन्स और गेटिंग मैकेनिज्म कैसे काम करते हैं, इसकी विस्तृत व्याख्या।
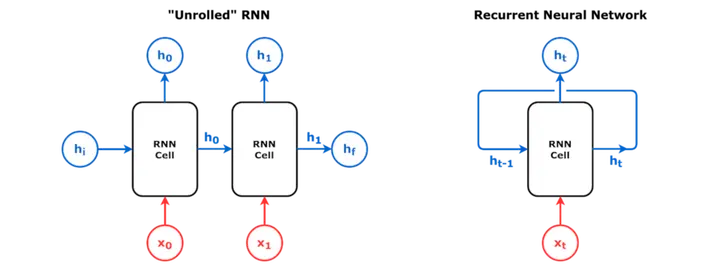
कृत्रिम न्यूरल नेटवर्क्स (Artificial Neural Networks) के क्षेत्र में पारंपरिक फीडफॉरवर्ड न्यूरल नेटवर्क (feedforward neural networks) प्रत्येक इनपुट को एक-दूसरे से स्वतंत्र रूप से प्रोसेस करते हैं। परंतु जब टेक्स्ट, आवाज़ या टाइम सीरीज़ (time series) जैसे क्रमिक डेटा (sequential data) पर काम करना होता है, तब घटकों का क्रम अत्यंत महत्वपूर्ण बन जाता है। इस आवश्यकता को पूरा करने के लिए रीकरंट न्यूरल नेटवर्क्स (Recurrent Neural Networks - RNN) विकसित किए गए थे। आरएनएन अपने पिछले समय स्टेप के आउटपुट को वर्तमान समय स्टेप के इनपुट के साथ जोड़कर एक प्रकार की आंतरिक मेमोरी बनाए रखता है।
आरएनएन का मूल घटक रीकरंट यूनिट (recurrent unit) है, जो एक हिडन स्टेट (hidden state) रखता है। यह हिडन स्टेट वर्तमान इनपुट और पिछले हिडन स्टेट के आधार पर लगातार अपडेट होती रहने वाली मेमोरी के रूप में काम करता है। गणितीय रूप से देखें तो, आरएनएन एक ऐसा फ़ंक्शन है जो इनपुट वेक्टर xt और हिडन वेक्टर ht को प्रोसेस करके नया आउटपुट yt और आगामी समय स्टेप के लिए हिडन वेक्टर ht+1 देता है। यह फीडबैक मैकेनिज्म मॉडल को अतीत के इनपुट्स से सीखकर वर्तमान प्रोसेसिंग में उसका उपयोग करने की शक्ति देता है।
आरएनएन आधारित मॉडल्स को मुख्य रूप से दो भागों में विभाजित किया जा सकता है: कॉन्फ़िगरेशन और आर्किटेक्चर। जब विभिन्न आरएनएन को डेटा फ्लो में जोड़ा जाता है उसे कॉन्फ़िगरेशन कहा जाता है, और प्रत्येक आरएनएन खुद एक विशिष्ट आर्किटेक्चर रखता है। गहराई से प्रोसेसिंग करने के लिए स्टैक्ड आरएनएन (Stacked RNN) या डीप आरएनएन का उपयोग किया जाता है, जिसमें एक से अधिक आरएनएन लेयर्स को एक-दूसरे के ऊपर व्यवस्थित किया जाता है। लेयर १ इनपुट x0,t और हिडन स्टेट h1,t को प्राप्त करके x1,t और नया हिडन स्टेट h1,t+1 उत्पन्न करता है, जो आगे के लेयर के लिए इनपुट के रूप में कार्य करता है।
आरएनएन कैसे कार्य करता है: चरण-दर-चरण प्रक्रिया
आरएनएन की कार्यपद्धति को समझने के लिए इसे समय के विभिन्न चरणों में विस्तारित (unfolded in time) करके देखना पड़ता है। प्रत्येक समय स्टेप पर मॉडल समान पैरामीटर्स और वजन (weights) का उपयोग करके क्रमिक गणनाएँ करता है।
- इनपुट और हिडन स्टेट का ग्रहणवर्तमान समय स्टेप t पर नया इनपुट xt और पिछले समय स्टेप t-1 का हिडन स्टेट ht-1 प्राप्त किया जाता है।
- वेटेड गणना और रूपांतरणइनपुट और पिछले मेमोरी स्टेट पर वेट मैट्रिक्स और बायस लागू करके नॉन-लिनियर एक्टिवेशन फंक्शन द्वारा प्रक्रिया होती है।
- हिडन स्टेट का अपडेटनई गणना के आधार पर वर्तमान समय का हिडन स्टेट ht अपडेट होता है, जो अगले समय स्टेप के लिए मेमोरी के रूप में कार्य करता है।
- आउटपुट जनरेशनवर्तमान हिडन स्टेट आधारित सटीक प्रेडिक्शन या परिणाम yt जनरेट करके मॉडल आगे बढ़ता है।
प्रथम चरण में, नेटवर्क वर्तमान समय स्टेप का डेटा और अतीत की याददाश्त प्राप्त करता है। दूसरे चरण में, वह जानकारी पर वजन और बायस (bias) लगाकर नॉन-लीनियर रूपांतरण करता है। तीसरे चरण में, प्राप्त परिणाम से हिडन स्टेट अपडेट होता है और चौथे चरण में उस समय स्टेप का आउटपुट जनरेट होता है।
न्यूरोसाइनेंस और सांख्यिकीय मैकेनिक्स से लेकर मॉडर्न आर्किटेक्चर तक का इतिहास
रीकरंट न्यूरल नेटवर्क की जड़ें न्यूरोसाइंस में हैं। जीव विज्ञान में "रीकरंट" शब्द लूप जैसी शारीरिक संरचनाओं के लिए इस्तेमाल होता है। १९०१ में काहाले (Cajal) ने सेरेबेलर कॉर्टेक्स में रीकरंट अर्धवृत्त देखे थे। उसके बाद १९३३ में लोरेन्ते डे नो (Lorente de Nó) ने रीकरंट संबंधों की खोज की और यह प्रस्ताव रखा कि उत्तेजक लूप वेस्टिबुलो-ऑक्युलर रिफ्लेक्स को स्पष्ट करते हैं। १९४० के दशक में हेब (Hebb) नामक वैज्ञानिक ने अल्पावधि मेमोरी की समझ के लिए "रिवर्बरेटिंग सर्किट" का विचार पेश किया। १९४३ में मैकुलॉच और पिट्स (McCulloch and Pitts) के पेपर में साइकिल वाले नेटवर्क्स का उल्लेख था, जो पिछली गतिविधियों से प्रभावित हो सकते थे।
१९६० में फ्रैंक रोसेनब्लैट (Frank Rosenblatt) ने "क्लोज़्ड-लूप क्रॉस-कप्ल्ड पर्सेपट्रॉन्स" पर शोध प्रकाशित किया। उन्होंने १९६१ में दर्शाया कि पूरी तरह से क्रॉस-कप्ल्ड पर्सेपट्रॉन नेटवर्क अनंत गहराई वाले फीडफॉर्वर्ड नेटवर्क के समान है। इसके बाद १९७१ में काओरु नाकानो (Kaoru Nakano), १९७२ में शुन-इची अमारी (Shun'ichi Amari) और १९७४ में विलियम ए. लिटिल (William A. Little) द्वारा समान नेटवर्क प्रस्तुत किए गए थे। इस क्षेत्र में सांख्यिकीय मैकेनिक्स (statistical mechanics) का भी बड़ा योगदान रहा। १९२० के दशक में विल्हेल्म लेन्ज़ और अर्न्स्ट इसिंग द्वारा इसिंग मॉडल (Ising model) विकसित किया गया था। १९८२ में जॉन हॉपफील्ड (John Hopfield) ने बाइनरी एक्टिवेशन फंक्शन वाले हॉपफील्ड नेटवर्क (Hopfield network) का अध्ययन करने के लिए इन सिद्धांतों को लागू किया और १९८४ में इसे कंटीन्यूअस एक्टिवेशन फंक्शन तक विस्तारित किया।
વર્ષ
1980 के दशक में न्युरल नेटवर्क्स के पुनरुत्थान के दौरान दो महत्वपूर्ण आर्किटेक्चर सामने आए: 1986 में माइकल आई. जोर्डन द्वारा जोर्डन नेटवर्क (Jordan network) और 1990 में जेफ्री इल्मेन द्वारा इल्मेन नेटवर्क (Elman network)। उसके बाद 1997 में माइक शुस्टर और कुलदीप के. पालिवाल ने बाइडायरेक्शनल रीकरंट न्युरल नेटवर्क्स (BRNNs) पेश किए, जो सीक्वेंस को आगे और पीछे दोनों दिशाओं में प्रोसेस करते थे।
वैनिशिंग ग्रेडिएंट की समस्या और एलएसटीएम (LSTM) का उद्भव
पारंपरिक आरएनएन (RNN) मॉडल जब लंबी श्रेणियों (long sequences) पर प्रशिक्षित किए जाते हैं, तब वे 'वैनिशिंग ग्रेडिएंट प्रॉब्लम' (vanishing gradient problem) का सामना करते हैं। जब 'बैक-प्रोपैगेशन थ्रू टाइम' (back-propagation through time) के माध्यम से मॉडल को ट्रेन किया जाता है, तब लंबी अवधि के ग्रेडिएंट्स बहुत छोटी संख्याओं के गुणन के कारण शून्य के करीब पहुँच जाते हैं। इसके कारण मॉडल अतीत की दूर की जानकारी याद नहीं रख पाता है और सीखना बंद कर देता है।
इस गंभीर सीमा को दूर करने के लिए 1997 में सेप होचराइटर (Sepp Hochreiter) और जुर्गन श्मिटहुबर (Jürgen Schmidhuber) द्वारा लॉन्ग शॉर्ट-टर्म मेमोरी (Long Short-Term Memory - LSTM) आर्किटेक्चर प्रस्तुत किया गया। एलएसटीएम (LSTM) ऐसा मैकेनिज्म प्रदान करता है जो हजारों टाइम स्टेप्स तक ग्रेडिएंट को घटे बिना प्रवाहित होने देता है। इससे नेटवर्क यह सीख सकता है कि कौन सी जानकारी लंबे समय तक याद रखनी है और कौन सी जानकारी भूल जानी है।
उदाहरण के लिए, नेचुरल लैंग्वेज प्रोसेसिंग (Natural Language Processing) में, "Dave, as a result of his controversial claims, is now a pariah" वाक्य को प्रोसेस करते समय LSTM मॉडल मुख्य कर्ता 'Dave' के लिंग और वचन को याद रखता है ताकि आगे आने वाले सर्वनाम 'his' और क्रिया 'is' के साथ उचित व्याकरण बनाए रखा जा सके। क्रिया 'is' के आ जाने के बाद मॉडल यह समझ सकता है कि उस जानकारी की आवश्यकता पूरी हो गई है और उसे हटा सकता है।
LSTM की आंतरिक संरचना और गणितीय समीकरण
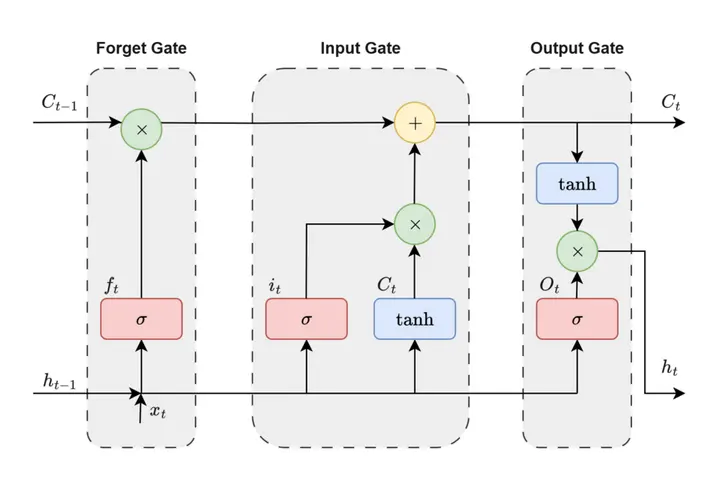
एक LSTM यूनिट मुख्य रूप से एक मेमोरी सेल (cell) और तीन गेट्स (gates) से बनी होती है: फॉरगेट गेट (forget gate), इनपुट गेट (input gate) और आउटपुट गेट (output gate)। ये गेट्स सेल के भीतर सूचना के प्रवाह को नियंत्रित करने का कार्य करते हैं।
फॉरगेट गेट पिछले स्टेट से कौन सी जानकारी हटानी है, यह तय करता है। यह सिग्मॉइड फंक्शन (sigmoid function) का उपयोग करके 0 से 1 के बीच मान देता है, जहाँ 0 का अर्थ है जानकारी को पूरी तरह भूल जाना और 1 का अर्थ है पूरी तरह याद रखना। इनपुट गेट यह तय करता है कि सेल स्टेट में कौन सी नई जानकारी जोड़नी है। आउटपुट गेट वर्तमान सेल स्टेट से कौन सी जानकारी बाहर भेजनी है, इसे नियंत्रित करता है।
| गेट / घटक | गणितीय समीकरण | मुख्य कार्य |
|---|---|---|
| फॉरगेट गेट (ft) | ft = σg(Wf xt + Uf ht-1 + bf) | पिछले स्टेट से कौन सी जानकारी निकाल देनी है वह तय करता है (0 से 1) |
| इनपुट गेट (it) | it = σg(Wi xt + Ui ht-1 + bi) | वर्तमान इनपुट से कौन सी नई जानकारी संग्रहित करनी है वह तय करता है |
| कैंडिडेट स्टेट (c~t) | c~t = σc(Wc xt + Uc ht-1 + bc) | सेल स्टेट में जोड़ने के लिए नए उम्मीदवार मूल्य बनाता है |
| सेल स्टेट (ct) | ct = ft ⊙ ct-1 + it ⊙ c~t | पुरानी मेमोरी भुलाकर नई मेमोरी जोड़कर मुख्य स्टेट अपडेट करता है |
| आउटपुट गेट (ot) | ot = σg(Wo xt + Uo ht-1 + bo) | सेल स्टेट से कौन सी जानकारी आउटपुट के रूप में भेजनी है वह तय करता है |
LSTM सेल में होने वाली गणना के फॉरवर्ड पास के वेक्टर समीकरण नीचे दिए गए हैं। यहाँ σg सिग्मॉइड एक्टिवेशन फंक्शन को दर्शाता है और ⊙ चिह्न हैडामार्ड प्रोडक्ट (Hadamard product - एलिमेंट-वाइज गुणा) को दर्शाता है:
फॉरगेट गेट: ft = σg(Wf xt + Uf ht-1 + bf) इनपुट गेट: it = σg(Wi xt + Ui ht-1 + bi) आउटपुट गेट: ot = σg(Wo xt + Uo ht-1 + bo) कैंडिडेट सेल स्टेट: c~t = σc(Wc xt + Uc ht-1 + bc) नया सेल स्टेट: ct = ft ⊙ ct-1 + it ⊙ c~t नया हिडन स्टेट: ht = ot ⊙ σh(ct)
यहाँ शुरुआती मान c0 = 0 और h0 = 0 होते हैं। W और U मैट्रिक्स क्रमशः इनपुट और रिकरंट कनेक्शन्स के वेट्स (weights) को दर्शाते हैं।
एडवांस विनियोग, बायडायरेक्शनल मॉडल्स और ट्रांसफॉर्मर युग
2000 के दशक के मध्य में बायडायरेक्शनल आर्किटेक्चर को LSTM के साथ जोड़ा गया। बायडायरेक्शनल LSTM (Bi-LSTM) मॉडल्स ने स्पीच रिकग्निशन (speech recognition) और टेक्स्ट-टू-स्पीच के क्षेत्र में क्रांतिकारी परिणाम दिए और Google वॉइस सर्च (Google voice search) में इनका व्यापक उपयोग हुआ। 2010 में टोमाश माइकोलोव (Tomáš Mikolov) और उनके साथियों ने दिखाया कि RNN आधारित लैंग्वेज मॉडल्स पारंपरिक n-gram मॉडल्स की तुलना में बेहतर परिणाम देते हैं।

2014 में क्युंगह्युन चो (Kyunghyun Cho) और उनकी टीम ने मशीन ट्रांसलेशन के लिए आरएनएन एनकोडर-डीकोडर (RNN encoder-decoder) प्रस्तावित किया। इसी वर्ष एलएसटीएम (LSTM) का उपयोग करके सीक्वेंस-टू-सीक्वेंस (sequence-to-sequence) लर्निंग प्रदर्शित की गई। इस खोज ने अटेंशन मैकेनिज्म (attention mechanisms) के विकास में आधारभूत भूमिका निभाई।
बाद में गेटेड रिकरंट यूनिट (Gated Recurrent Unit - GRU) जैसे अधिक कार्यक्षम विकल्प भी आए। हाल के वर्षों में, सेल्फ-अटेंशन (self-attention) पर आधारित ट्रांसफॉर्मर्स (Transformers) मॉडल्स ने नेचुरल लैंग्वेज प्रोसेसिंग में आरएनएन (RNN) का स्थान ले लिया है क्योंकि वे पैरेलल प्रोसेसिंग (parallel processing) में श्रेष्ठ हैं। फिर भी, जिन उपकरणों पर रियल-टाइम प्रोसेसिंग और कंप्यूटेशनल कार्यक्षमता अत्यंत आवश्यक होती है, वहां आरएनएन और एलएसटीएम आज भी महत्वपूर्ण भूमिका निभा रहे हैं।


