ગૂગલની ૮મી પેઢીની ટેન્સર ચિપ્સ: સ્વાયત્ત AI એજન્ટ્સ માટે પાયાની ક્રાંતિ
ગૂગલે તેની નવી TPU ૮tx અને TPU ૮i Max ચિપ્સ સાથે આર્ટિફિશિયલ ઇન્ટેલિજન્સના ભવિષ્યને નવી દિશા આપી છે, જે ખાસ કરીને જટિલ એજન્ટિક કાર્યો માટે તૈયાર કરવામાં આવી છે.
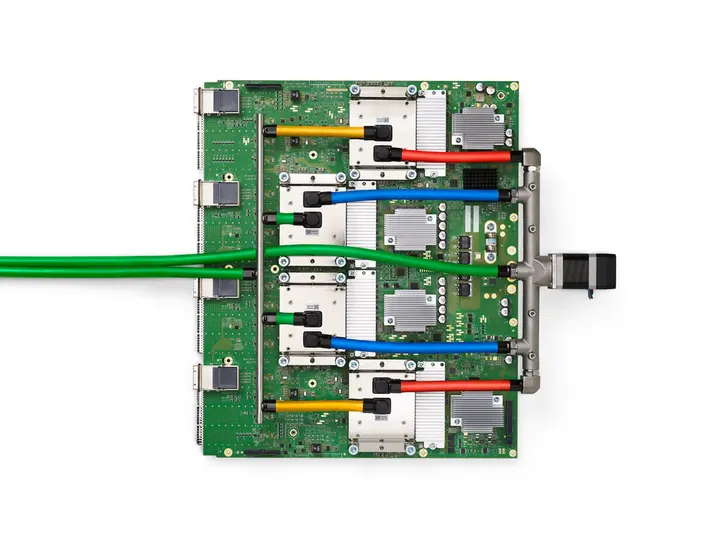
આર્ટિફિશિયલ ઇન્ટેલિજન્સ (AI) ની દુનિયા અત્યારે એક મોટા પરિવર્તનમાંથી પસાર થઈ રહી છે. અત્યાર સુધી આપણે AI નો ઉપયોગ માત્ર પ્રશ્નોના જવાબ મેળવવા કે ચિત્રો બનાવવા માટે કરતા હતા, પરંતુ હવે 'AI એજન્ટ્સ' (AI agents) નો યુગ આવી રહ્યો છે. આ એજન્ટ્સ એવા સ્વાયત્ત પ્રોગ્રામ્સ છે જે માત્ર જવાબ નથી આપતા, પરંતુ વપરાશકર્તા વતી જટિલ કાર્યો પણ કરી શકે છે. આ બદલાતી જરૂરિયાતોને પહોંચી વળવા માટે, ગૂગલે તેની આઠમી પેઢીના ટેન્સર પ્રોસેસિંગ યુનિટ (Tensor Processing Unit - TPU) ની જાહેરાત કરી છે. કંપનીના અહેવાલો મુજબ, આ નવી ચિપ્સ ખાસ કરીને એજન્ટિક વર્કલોડ (agentic workloads) એટલે કે એવા કાર્યો જેમાં AI એ જાતે નિર્ણય લઈને પગલાં ભરવાના હોય, તેને ધ્યાનમાં રાખીને બનાવવામાં આવી છે.
ગૂગલની આ નવી જાહેરાતમાં બે મુખ્ય ચિપ્સનો સમાવેશ થાય છે: TPU ૮tx અને TPU ૮i Max. બિઝનેસ સ્ટાન્ડર્ડના અહેવાલ મુજબ, ૧૦ નવેમ્બર ૨૦૨૬ના રોજ ગૂગલે આ શ્રેણીનો વિસ્તાર કર્યો હતો, જે સુરક્ષિત AI ઇન્ફરન્સ (inference) એટલે કે માહિતી પરથી તારણ કાઢવાની પ્રક્રિયા અને જટિલ એજન્ટ કાર્યોને ટેકો આપવા માટે ડિઝાઇન કરવામાં આવી છે. આ પ્રથમ વખત છે જ્યારે ગૂગલે તેની TPU આર્કિટેક્ચરને તાલીમ અને અનુમાન માટે અલગ-અલગ વિશિષ્ટ ડિઝાઇનમાં વિભાજિત કરી છે. આ વ્યૂહાત્મક ફેરફાર દર્શાવે છે કે AI મોડેલ્સ હવે એટલા વિશાળ અને જટિલ બની ગયા છે કે એક જ પ્રકારની ચિપ તમામ કાર્યો માટે પૂરતી નથી.
TPU શું છે તે સમજવું જરૂરી છે. વિકિપીડિયાના જણાવ્યા મુજબ, ટેન્સર પ્રોસેસિંગ યુનિટ એ એક એપ્લિકેશન-સ્પેસિફિક ઇન્ટિગ્રેટેડ સર્કિટ (ASIC) છે, જે ખાસ કરીને ન્યુરલ નેટવર્ક મશીન લર્નિંગ માટે ગૂગલ દ્વારા વિકસાવવામાં આવી છે. સામાન્ય ગ્રાફિક્સ પ્રોસેસિંગ યુનિટ (GPU) ની સરખામણીમાં, TPU ઓછી ચોકસાઈવાળી ગણતરીઓ ખૂબ જ ઝડપથી અને ઓછા પાવર વપરાશમાં કરવા માટે ડિઝાઇન કરવામાં આવી છે. ગૂગલે ૨૦૧૫માં આંતરિક રીતે આ ચિપ્સનો ઉપયોગ શરૂ કર્યો હતો અને ૨૦૧૮થી તે ક્લાઉડ સેવાઓ દ્વારા અન્ય કંપનીઓ માટે ઉપલબ્ધ કરાવી છે. આ ચિપ્સનો વિકાસ બ્રોડકોમ (Broadcom) કંપનીના સહયોગથી કરવામાં આવે છે અને તેનું ઉત્પાદન તાઇવાન સેમિકન્ડક્ટર મેન્યુફેક્ચરિંગ કંપની (TSMC) દ્વારા કરવામાં આવે છે.
બે અલગ રસ્તા: તાલીમ અને અનુમાન
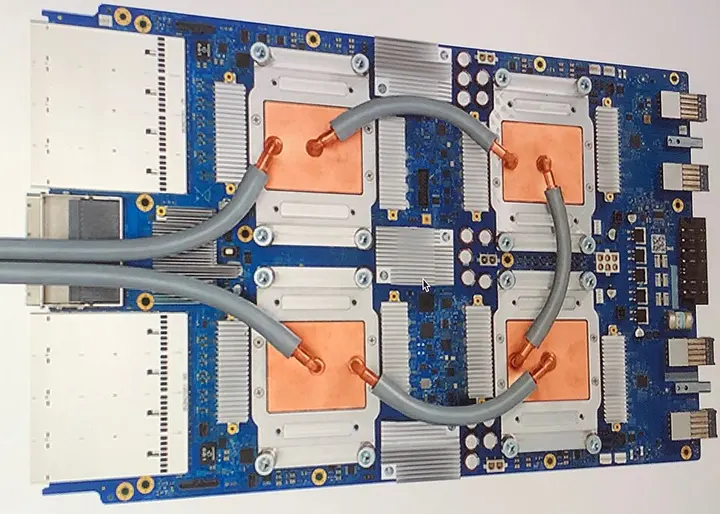
ગૂગલે ૨૨ એપ્રિલ ૨૦૨૬ના રોજ આઠમી પેઢીના TPU ની જાહેરાત કરી હતી. આ પેઢીમાં બે મુખ્ય પ્રકાર છે: TPU ૮t અને TPU ૮i. અહીં 't' નો અર્થ ટ્રેનિંગ (Training) એટલે કે મોડેલને શીખવવાની પ્રક્રિયા છે, જ્યારે 'i' નો અર્થ ઇન્ફરન્સ (Inference) એટલે કે શીખેલા મોડેલનો ઉપયોગ કરીને પરિણામ મેળવવાની પ્રક્રિયા છે. આ બંને ચિપ્સ ગૂગલના પોતાના આર્મ-આધારિત (Arm-based) એક્સિયન (Axion) CPU પર હોસ્ટ કરવામાં આવે છે અને તેમાં ચોથી પેઢીની લિક્વિડ કૂલિંગ (liquid cooling) એટલે કે પ્રવાહી દ્વારા ઠંડક આપવાની ટેકનોલોજીનો ઉપયોગ થાય છે.
TPU ૮t એ મોટા પાયે ફ્રન્ટિયર મોડેલ્સની પ્રી-ટ્રેનિંગ માટે બનાવવામાં આવી છે. તેની ક્ષમતા આશ્ચર્યજનક છે. તે ૧૨.૬ FP૪ PFLOPs (પેટાફ્લોપ્સ) ની પીક પરફોર્મન્સ આપે છે. FP૪ એ ફ્લોટિંગ પોઈન્ટ ૪-બીટ ફોર્મેટ છે જે ગણતરીની ઝડપ વધારે છે. તેમાં ૨૧૬ GB ની HBM૩e મેમરી છે, જે ૬,૫૨૮ GB/s ની બેન્ડવિડ્થ (bandwidth) એટલે કે ડેટા ટ્રાન્સફર કરવાની ઝડપ પૂરી પાડે છે. આ ચિપ્સને 'વર્ગો નેટવર્ક' (Virgo Network) દ્વારા જોડવામાં આવે છે, જેનાથી ૯,૬૦૦ ચિપ્સનું એક 'સુપરપોડ' બનાવી શકાય છે. આ સુપરપોડ કુલ ૧૨૧ FP૪ ExaFLOPs (એક્ઝાફ્લોપ્સ) જેટલી પ્રચંડ ગણતરી શક્તિ ધરાવે છે.
બીજી તરફ, TPU ૮i એ હાઇ-સ્પીડ સર્વિંગ અને AI એજન્ટ્સ માટે તૈયાર કરવામાં આવી છે. AI એજન્ટ્સને લાંબા સમય સુધી તર્ક (reasoning) કરવાની જરૂર હોય છે, તેથી આ ચિપમાં ૨૮૮ GB ની HBM૩e મેમરી આપવામાં આવી છે, જેની બેન્ડવિડ્થ ૮,૬૦૧ GB/s છે. સૌથી મહત્વની વાત એ છે કે તેમાં ૩૮૪ MB ની ઓન-ચિપ SRAM (સ્ટેટિક રેન્ડમ એક્સેસ મેમરી) છે, જે અગાઉની પેઢી કરતા ત્રણ ગણી વધારે છે. આ મેમરી ડેટાને પ્રોસેસરની ખૂબ નજીક રાખે છે, જેનાથી પ્રોસેસિંગની ઝડપ વધે છે. તેમાં 'બોર્ડફ્લાય' (Boardfly) નેટવર્ક ટોપોલોજી અને કલેક્ટિવ્સ એક્સિલરેશન એન્જિન (CAE) નો ઉપયોગ કરવામાં આવ્યો છે, જે સિંક્રોનાઇઝેશન લેટન્સી (latency) એટલે કે બે કાર્યો વચ્ચેના વિલંબને પાંચ ગણો ઘટાડે છે.
| વિગત | TPU 8t (Training) | TPU 8i (Inference) |
|---|---|---|
| પીક પરફોર્મન્સ | 12.6 FP4 PFLOPs | 10.1 FP4 PFLOPs |
| HBM મેમરી ક્ષમતા | 216 GB | 288 GB |
| મેમરી બેન્ડવિડ્થ | 6,528 GB/s | 8,601 GB/s |
| નેટવર્ક ફેબ્રિક | Virgo Network | Boardfly Topology |
ટેકનોલોજી પાછળનું વિજ્ઞાન: સિસ્ટોલિક એરે
TPU કેવી રીતે કામ કરે છે તે સમજવા માટે 'સિસ્ટોલિક એરે' (systolic array) ની કલ્પના કરવી પડે. જેમ માનવ શરીરમાં હૃદય લોહીને પંપ કરે છે, તેમ આ આર્કિટેક્ચરમાં ડેટા પ્રોસેસરોના નેટવર્ક દ્વારા સતત વહેતો રહે છે. સામાન્ય પ્રોસેસરમાં દરેક ગણતરી પછી ડેટાને મેમરીમાં પાછો મોકલવો પડે છે, પરંતુ TPU માં એક ગણતરીનું પરિણામ સીધું જ બીજા પ્રોસેસરને મળે છે. આનાથી મેમરી એક્સેસ કરવાની જરૂરિયાત ઘટે છે અને વીજળીનો વપરાશ પણ ઓછો થાય છે. નોર્મન જોપ્પી (Norman Jouppi) નામના એન્જિનિયરે આ ડિઝાઇનનું નેતૃત્વ કર્યું હતું, જેમણે સાબિત કર્યું હતું કે TPU અન્ય પ્રોસેસરો કરતા ૩૦ થી ૮૦ ગણી વધુ કાર્યક્ષમતા આપી શકે છે.
- ડેટા ઇનપુટહોસ્ટ પ્રોસેસર (CPU) દ્વારા ડેટાને PCIe બસ મારફતે TPU માં મોકલવામાં આવે છે.
- સિસ્ટોલિક એરે પ્રોસેસિંગડેટા મેટ્રિક્સ મલ્ટિપ્લાયર યુનિટ્સમાંથી પસાર થાય છે, જ્યાં એક પ્રોસેસરનું પરિણામ સીધું બીજાને મળે છે.
- એક્ટિવેશન ફંક્શનગણતરી કરેલા ડેટા પર એક્ટિવેશન ફંક્શન લાગુ કરવામાં આવે છે જેથી ન્યુરલ નેટવર્ક નિર્ણય લઈ શકે.
- પરિણામ આઉટપુટઅંતિમ પરિણામ અથવા તારણ ફરીથી મેમરીમાં અથવા હોસ્ટ પ્રોસેસરને મોકલવામાં આવે છે.
ગૂગલના ઇતિહાસ પર નજર કરીએ તો, આ કંપનીની સ્થાપના ૧૯૯૮માં લેરી પેજ અને સર્જી બ્રિન દ્વારા કરવામાં આવી હતી. ૨૦૧૫માં સુંદર પિચાઈ ગૂગલના CEO બન્યા અને તેમના નેતૃત્વમાં ગૂગલે 'AI ફર્સ્ટ' કંપની બનવાની દિશા પકડી. TPU નો વિકાસ આ વ્યૂહરચનાનો એક મુખ્ય ભાગ છે. ૨૦૧૬માં ગૂગલ I/O કોન્ફરન્સમાં પ્રથમ પેઢીના TPU ની જાહેરાત કરવામાં આવી હતી. ત્યારથી અત્યાર સુધીમાં દરેક પેઢીએ પ્રદર્શનમાં મોટો ઉછાળો જોયો છે. ઉદાહરણ તરીકે, ચોથી પેઢીના TPU v૪ એ Nvidia A૧૦૦ કરતા ૫% થી ૮૭% વધુ ઝડપી હોવાનો દાવો કરવામાં આવ્યો હતો. હવે આઠમી પેઢી સાથે, ગૂગલ સીધી રીતે Nvidia ની અત્યાધુનિક H૧૦૦ અને તેના પછીની ચિપ્સ સાથે સ્પર્ધા કરી રહ્યું છે.
સામાન્ય લોકો અને ભારત માટે મહત્વ
તમને પ્રશ્ન થશે કે આ ચિપ્સથી સામાન્ય માણસને શું ફાયદો? જ્યારે તમે ગૂગલ સર્ચ કરો છો, ગૂગલ ફોટોઝમાં ચિત્રો શોધો છો અથવા ગૂગલ ટ્રાન્સલેટનો ઉપયોગ કરો છો, ત્યારે પડદા પાછળ આ TPU ચિપ્સ જ કામ કરતી હોય છે. ગૂગલ ફોટોઝમાં એક જ TPU દિવસમાં ૧૦ કરોડથી વધુ ફોટા પ્રોસેસ કરી શકે છે. નવી ૮મી પેઢીની ચિપ્સ આવવાથી, AI એજન્ટ્સ વધુ સચોટ અને ઝડપી બનશે. ભવિષ્યમાં, તમારા ફોન પરનો AI એજન્ટ તમારી ફ્લાઇટ બુક કરવાથી લઈને તમારી આખી ઓફિસનું કામ સંભાળવા સુધીના કાર્યો પળવારમાં કરી શકશે, કારણ કે તેને ક્લાઉડમાં આટલી શક્તિશાળી ચિપ્સનો ટેકો મળશે.
ભારત જેવા દેશ માટે, જ્યાં ડિજિટલ સેવાઓનો વ્યાપ વધી રહ્યો છે, ગૂગલ ક્લાઉડ દ્વારા આ TPU ચિપ્સનો ઉપયોગ ભારતીય સ્ટાર્ટઅપ્સ અને સંશોધકો માટે વરદાન સાબિત થઈ શકે છે. ભારતીય ભાષાઓના મોટા મોડેલ્સ (LLMs) ને તાલીમ આપવા માટે જે પ્રચંડ ગણતરી શક્તિ જોઈએ, તે આ TPU ૮t પૂરી પાડી શકે છે. વળી, ગૂગલ હવે મેટા (Meta) જેવી કંપનીઓ સાથે પણ તેમના ડેટા સેન્ટરમાં TPU વાપરવા માટે વાતચીત કરી રહ્યું છે, જેનો અર્થ છે કે ભવિષ્યમાં ફેસબુક કે ઇન્સ્ટાગ્રામની AI સુવિધાઓ પણ ગૂગલની આ ચિપ્સ પર ચાલી શકે છે.
GB/s
નિષ્કર્ષમાં, ગૂગલની ૮મી પેઢીની TPU માત્ર હાર્ડવેરનું અપગ્રેડ નથી, પરંતુ AI ના નવા યુગની તૈયારી છે. તાલીમ અને અનુમાન માટે અલગ-અલગ ચિપ્સ બનાવીને ગૂગલે સાબિત કર્યું છે કે તે AI ક્ષેત્રે પોતાનું વર્ચસ્વ જાળવી રાખવા માંગે છે. જેમ જેમ AI એજન્ટ્સ આપણા જીવનનો અભિન્ન ભાગ બનશે, તેમ તેમ આ ચિપ્સની ભૂમિકા વધુ નિર્ણાયક બનતી જશે. જોકે, આ ટેકનોલોજી કેટલી સુરક્ષિત રહેશે અને તેનો ખર્ચ કેટલો હશે તે જોવું રહ્યું, પરંતુ અત્યારે તો ગૂગલે સેમિકન્ડક્ટરની દુનિયામાં એક નવો માપદંડ સ્થાપિત કરી દીધો છે.